





Nginx采用多进程架构实现故障隔离与自动恢复:主进程仅负责管理,worker进程独立处理请求,任一worker崩溃不影响其他进程或主进程,master会自动拉起新worker补位。
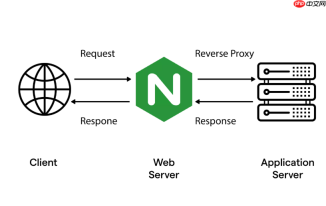
Nginx 采用多进程架构,核心目的之一就是隔离故障、防止单点崩溃导致整个服务不可用。它不依赖单个进程持续运行,而是由一个主进程(master)统筹管理多个工作进程(worker),每个 worker 独立处理请求。一旦某个 worker 异常退出,master 进程能立即拉起新进程补位,用户几乎无感知。
主进程与工作进程职责分离
主进程不直接处理网络请求,只负责读取配置、绑定端口、启动/监控 worker 进程、接收信号并做平滑重启或重载。所有 HTTP 请求、SSL 握手、静态文件读取等实际任务均由 worker 进程完成。这种分工让主进程极轻量、极稳定,即使某个 worker 因内存越界、第三方模块 bug 或极端请求触发崩溃,也不会波及主进程或其他 worker。
worker 进程彼此独立、互不干扰
每个 worker 是独立的 OS 进程,拥有自己的内存空间、文件描述符和连接队列。它们通过共享内存(如 limit_req、limit_conn 模块)协调状态,但不共享堆栈或执行上下文。这意味着:
- 一个 worker 遇到段错误(SIGSEGV)或被 OOM Killer 杀掉,其他 worker 继续响应请求
- 慢请求、长连接或大文件传输卡在一个 worker 中,不会阻塞其他 worker 处理新连接
- 通过 worker_rlimit_core 和 working_directory 配置,还可为每个 worker 单独设置核心转储路径,便于定位具体哪个进程出问题
自动恢复机制保障服务连续性
master 进程持续监听 worker 的存活状态。当检测到 worker 异常退出(非正常 exit code 或被 kill),会在日志中记录(如 "worker process XXX exited on signal 11"),并立即 fork 一个新 worker 替代。该过程无需人工干预,也不中断已建立的连接(已有连接由原 worker 继续处理直至关闭)。配合 systemd 或 supervisord 可进一步增强守护能力,但 Nginx 自身已具备基础容错能力。
合理配置 worker 数量与资源限制
过多 worker 会争抢 CPU 和锁资源,过少则无法充分利用多核;建议设为 CPU 核心数(worker_processes auto;),并配合适当的 worker_connections 和系统级 ulimit。同时启用 worker_shutdown_timeout 控制优雅退出时间,避免旧 worker 持有连接过久。对于高并发场景,还可开启 accept_mutex off(Linux 3.9+)减少惊群效应,提升多核利用率。





