





nginx 不存在主备 worker 进程切换机制,所有 worker 进程完全对等、独立运行,无主从关系;连接分发由内核(so_reuseport)或 accept_mutex 控制,不依赖 worker 间协作;高可用需外部组件实现。
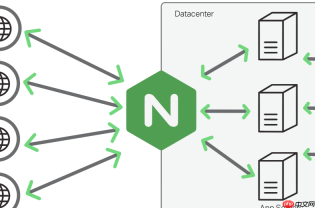
Nginx 在多进程模型中并不存在严格意义上的“主备 Worker 进程”切换机制。这是一个常见的误解——Nginx 的 Worker 进程之间是完全对等、无主从关系的,也没有运行时的“主备选举”或“故障接管”逻辑。
Worker 进程本质:平等、独立、无状态
Nginx 启动后,Master 进程会 fork 出多个 Worker 进程(数量由 worker_processes 指令指定),每个 Worker 独立监听端口(通过内核 SO_REUSEPORT 支持或 Master 进程分发连接)、处理请求、管理自己的内存和连接。它们不共享内存(除少量只读共享内存如 shared memory zones 外),也不互相通信,更不会主动感知彼此状态。
因此:
- 没有“主 Worker”负责调度或协调其他 Worker;
- 没有“备用 Worker”待命接管失败进程的任务;
- 某个 Worker 崩溃后,Master 会按配置(worker_rlimit_core、working_directory 等)记录日志并重新 fork 一个新 Worker,但这是进程级容错,不是“切换”。
连接分发机制:依赖操作系统,非 Nginx 自主调度
Nginx 不在应用层做连接负载均衡。连接如何落到哪个 Worker,取决于:
- SO_REUSEPORT(推荐,Linux 3.9+):内核在 accept 阶段就将新连接哈希分发给多个监听同一地址:端口的 Worker,天然均衡且避免惊群;
- 传统 single-listen + accept mutex:所有 Worker 竞争同一个 listen socket,Master 用文件锁(accept_mutex)控制仅一个 Worker 调用 accept,其余等待,效率较低;
无论哪种方式,都不存在“主 Worker 接收后再转发给备 Worker”的行为——每个 Worker 直接与客户端通信。
高可用靠外部机制,不在 Worker 层实现
若需真正的主备容灾(例如一台机器宕机后流量切到另一台),必须借助外部组件:
- 负载均衡器(如 LVS、HAProxy、云 LB)做健康检查与故障转移;
- 服务发现 + 动态 upstream(如 Consul + nginx-upstream-check-module);
- 进程监控工具(如 systemd、supervisord)重启异常 Worker,但仅限本机恢复。
这些都不改变 Worker 进程本身的对等性。
为什么会有“主备 Worker”的误传?
可能混淆了以下概念:
- Master vs Worker 角色:Master 是管理者(加载配置、平滑重启、监控 Worker),Worker 是执行者,但 Master 不参与请求处理;
- 热升级(binary upgrade)过程:旧 Worker 逐步退出,新 Worker 逐步接手,看似“切换”,实为新旧两组 Worker 并存过渡,无主备关系;
- 第三方模块或定制化开发:极少数场景下有人扩展 Nginx 实现 Worker 间状态同步,但这已超出官方设计范畴。
官方文档明确指出:“Worker processes are spawned by the master process and handle requests in parallel.” —— 平行,非主备。





