在自然语言处理(NLP)领域,文本分类是一项基础且重要的任务。传统方法依赖于大量的标注数据进行模型训练,而标注数据的获取往往耗时耗力。近年来,零样本学习(Zero-Shot Learning,ZSL)作为一种新兴的学习范式,逐渐受到关注。它允许模型在没有见过特定类别标注数据的情况下,对这些类别进行分类,极大地拓展了NLP的应用范围。 本文将深入探讨零样本学习在NLP文本分类中的应用,分析其核心原理与优势,并介绍一种便捷的工具——PyTorch Tabular,它可以帮助用户快速构建和训练适用于表格数据的深度学习模型。通过本文,你将了解到零样本学习如何打破数据依赖的瓶颈,以及如何利用深度学习技术赋能文本分类任务,为企业和开发者提供更灵活、高效的解决方案。
关键要点
零样本学习允许模型对未见过的类别进行分类。
零样本学习在NLP文本分类中具有重要应用价值。
PyTorch Tabular 简化了表格数据的深度学习模型构建。
迁移学习是零样本学习的重要组成部分。
Prompt工程可以提升零样本学习的文本分类效果。
零样本学习:打破数据依赖的文本分类新范式
什么是零样本学习?
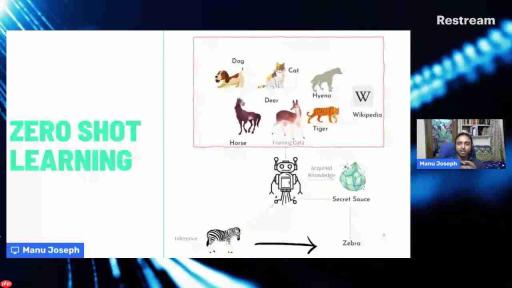
传统机器学习模型通常需要在目标类别上进行大量训练才能实现有效的分类。然而,在许多实际场景中,获取所有类别的标注数据是困难甚至不可能的。零样本学习应运而生,它旨在利用已知的类别信息(例如属性描述、文本描述)将知识迁移到未知的类别上,从而实现对这些类别的识别。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
简而言之,零样本学习让机器像人类一样,通过已有的经验和知识,推断出从未见过的物体或概念。例如,如果一个孩子知道斑马有马的形状和黑白条纹,即使他从未见过斑马,也能通过已知的知识进行识别。
零样本学习在NLP文本分类中的应用
在NLP领域,零样本学习可以应用于各种文本分类任务。例如:
-
情感分析:
模型在训练时只见过积极和消极情感的文本数据,但通过零样本学习,可以识别出喜悦、悲伤、愤怒等更细粒度的情感类别。
- 主题分类:模型只训练了科技、体育等主题的文本,但可以识别出从未见过的文化、艺术等主题。
- 意图识别:模型只训练了预订机票、查询天气等意图的对话文本,但可以识别出用户咨询酒店预订、餐厅推荐等新的意图。
这些应用场景都极大地拓展了文本分类的应用范围,降低了对大规模标注数据的依赖,为企业和开发者提供了更灵活的解决方案。
零样本学习的核心原理:知识迁移
零样本学习的核心在于知识迁移,即将已知类别的知识迁移到未知类别上。这种迁移通常依赖于以下两种信息:
-
语义嵌入(Semantic Embedding):
将类别标签嵌入到一个连续的语义空间中,例如使用Word2Vec、GloVe等词向量技术。
- 属性描述(Attribute Description):使用一组属性来描述每个类别,例如“斑马有条纹”、“狮子是肉食动物”。
通过学习已知类别在语义空间中的表示以及与属性描述之间的关系,模型就可以将这些知识迁移到未知类别上。当模型遇到一个未知类别的文本时,它可以利用该类别的语义嵌入或属性描述,在已知的知识基础上进行推断和分类。
零样本学习的四种常用方法
使用潜在嵌入(Latent Embedding)
这种方法的核心思想是将输入文本和类别标签嵌入到一个共享的潜在空间中,然后计算它们之间的距离, 从而进行分类。与计算机视觉不同的是,NLP 领域有一个优势,即输入和标签都在同一个领域中(都是文本)。因此,我们可以使用相似的嵌入方法将它们投影到一个共享空间中,并通过测量余弦距离来进行零样本分类。
关键步骤如下:
- 文本编码(Text Encoding):使用如 S-BERT 这样的文本编码器将输入文本转换为嵌入向量。
- 标签嵌入(Label Embedding):同样使用文本编码器将类别标签转换为嵌入向量。
- 距离计算(Distance Calculation):计算文本嵌入和标签嵌入之间的余弦距离。
- 分类预测(Classification Prediction):选择与文本嵌入距离最近的标签作为预测结果。
提高性能的关键在于使用更好的文本编码器、采用其他的池化技术(Pooling Techniques)以及优化 Prompt 工程
| 特点 | 描述 |
|---|---|
| 优点 | 方法比较简单,易于实现。 |
| 缺点 | 依赖于嵌入质量,对于语义信息丰富的类别效果较好,对于抽象类别可能表现不佳。 |
| 适用场景 | 适用于类别标签具有明确语义信息的文本分类任务,例如情感分析、主题分类等。 |
| 提升方法 | 采用预训练语言模型,利用领域知识优化prompt,训练阶段构建对比学习目标函数 |
自然语言推理(Natural Language Inference,NLI)
NLI 是一种判断两个句子之间关系的任务,其中一个句子是前提(Premise),另一个是假设(Hypothesis)。NLI 的目标是确定假设与前提之间的关系,通常分为三种:

- 蕴含(Entailment):假设可以从前提中推断出来。
- 矛盾(Contradiction):假设与前提相矛盾。
- 中立(Neutral):假设与前提既不矛盾也不蕴含。
Hugging Face 实现了零样本分类流水线,
这种流水线以一种创造性的提示工程(Prompt Engineering)方式巧妙地利用了自然语言推理模型。
| 特点 | 描述 |
|---|---|
| 优点 | 利用预训练的 NLI 模型进行推理,无需额外的训练数据。对自然语言理解能力要求较高。 |
| 缺点 | 受限于 NLI 模型的性能,对于复杂或需要领域知识的文本分类任务可能表现不佳。 |
| 适用场景 | 适用于具有明确推理关系的文本分类任务,例如判断新闻标题与文章内容是否一致、验证用户评论是否符合特定规则等。 |
| 提升方法 | 选择领域相关性更强的NLI模型、prompt微调 |
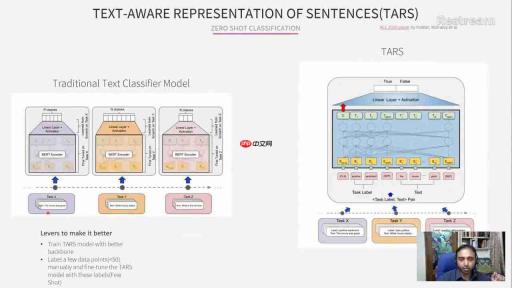
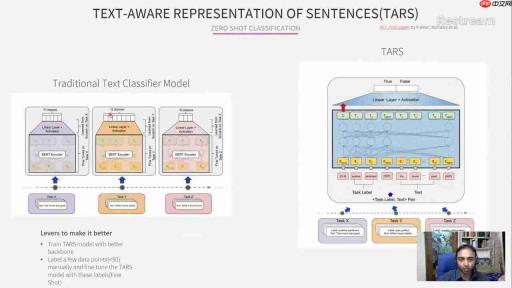
文本感知句子表征(Text-Aware Representation of Sentences,TARS)
ACL 2020 提出一种名为 TARS 的文本分类框架, 它通过对 Transformer 模型进行巧妙的改造,使其能够直接对文本进行分类。TARS 的核心思想是将文本分类任务转化为一个二元分类问题,即判断给定的文本是否属于特定的类别。
| 特点 | 描述 |
|---|---|
| 优点 | 可以灵活地适应各种文本分类任务,无需针对每个任务单独设计模型。泛化性较强。 |
| 缺点 | 模型结构相对复杂,训练过程需要一定的技巧。 |
| 适用场景 | 适用于各种文本分类任务,尤其是在类别数量较多或类别定义较为模糊的情况下。 |
| 提升方法 | 设计更有效的prompt,增加pretrain阶段对齐task和label分布。 |
问答(Question Answering)
我们可以使用一种领域/任务自适应的问答(QA)框架与一些语义嵌入相结合,以实现零样本任务。
该方法将文本分类问题转化为一个问答问题,例如“这篇文章是关于什么的?”。然后,模型会从预定义的类别中选择最合适的答案。
| 特点 | 描述 |
|---|---|
| 优点 | 利用 qa 模型的自然语言理解能力进行分类,可解释性较强。 |
| 缺点 | 需要构建高质量的问答数据集,对领域知识要求较高。 |
| 适用场景 | 适用于需要解释分类结果的任务,例如智能客服、信息检索等。 |
| 提升方法 | 根据问题类型构建特定QA模型、扩大知识库 |
使用PyTorch Tabular快速构建深度学习模型
PyTorch Tabular简介
PyTorch Tabular是一个基于PyTorch的库,旨在简化表格数据的深度学习模型构建过程。
它提供了各种预定义的模型结构、训练策略和评估指标,用户可以通过简单的配置即可快速搭建和训练模型。
PyTorch Tabular 的核心优势包括:
- 易于使用:提供简洁的API和丰富的文档,降低了深度学习的入门门槛。
- 高度可配置:用户可以根据需求自定义模型结构、优化器、损失函数等。
- 高性能:基于PyTorch,充分利用GPU加速,实现高效的模型训练。
- 模块化设计:方便用户扩展和定制模型。
PyTorch Tabular Github地址: 用户可以在Github上搜索到PyTorch Tabular
PyTorch Tabular 项目优缺点分析
? Pros
易于使用:提供简洁的API和丰富的文档,降低了深度学习的入门门槛。
高度可配置:用户可以根据需求自定义模型结构、优化器、损失函数等。
高性能:基于PyTorch,充分利用GPU加速,实现高效的模型训练。
模块化设计:方便用户扩展和定制模型。
? Cons
相对于成熟的机器学习库,生态系统仍然不够完善。
对于特定领域的数据,可能需要进行更多的特征工程。
高级定制和调试可能需要一定的深度学习基础。
常见问题
零样本学习与传统机器学习方法相比有哪些优势?
零样本学习最大的优势在于它不需要目标类别的标注数据, 降低了数据收集和标注的成本。此外,零样本学习还具有更强的泛化能力,可以应对新的、未知的类别。
PyTorch Tabular 适用于哪些类型的表格数据?
PyTorch Tabular 适用于各种类型的表格数据,包括数值型、分类型、文本型等。它提供了灵活的数据预处理和特征工程功能,可以有效地处理各种复杂的数据。
零样本学习目前面临哪些挑战?
零样本学习目前仍然面临一些挑战,包括: 领域迁移问题:如果已知类别和未知类别之间存在较大的领域差异,模型可能难以进行有效的知识迁移。 属性描述的准确性:如果属性描述不准确或不完整,会影响模型的分类性能。 模型的可解释性:零样本学习模型的决策过程通常比较复杂,缺乏可解释性。
相关问题
如何选择合适的零样本学习方法?
选择合适的零样本学习方法需要根据具体的任务和数据特点进行考虑。如果类别标签具有明确的语义信息,可以尝试基于语义嵌入的方法;如果可以获取类别的属性描述,可以尝试基于属性描述的方法;如果需要解释分类结果,可以尝试基于问答的方法。此外,还可以尝试将不同的方法进行组合,以提高模型的性能。