





在人工智能领域,处理长文本一直是挑战。DeepSeek OCR 创新性地利用视觉压缩技术,将文本信息编码到图像中,大幅提升 AI 系统处理长文本的效率和能力。本文将深入探讨 DeepSeek OCR 的原理、技术突破以及它对 AI 未来发展的潜在影响。
DeepSeek OCR 核心要点
DeepSeek OCR 采用视觉压缩技术,将文本信息存储在图像中。
它通过 DeepEncoder 和 DeepSeek3B-MoE-A570M 实现高效的文本压缩和解码。
在 OCR 任务中,DeepSeek OCR 实现了高达 97% 的精准度。
DeepSeek OCR 的技术突破对 AI 内存和长文本处理具有重要意义。
该技术在历史长文本压缩和记忆遗忘机制研究中显示出潜力。
Vision Transformer (ViT) 模型是 DeepSeek OCR 的关键组件。
DeepSeek OCR:视觉压缩技术的新纪元
图像价值千言万语:DeepSeek OCR 的灵感来源
俗话说,“一张图片胜过千言万语”。这句话道出了图像在信息传递上的强大能力。传统上,我们认为图片能提供远超文字描述的信息量。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
DeepSeek 从这句格言中汲取灵感,并将其提升到了一个全新的高度。
DeepSeek 发布了一篇论文和一个模型,展示了他们最新的技术成果:DeepSeek OCR。然而,这项技术的真正价值并不仅仅在于 OCR 功能本身。DeepSeek OCR 的核心在于利用视觉作为压缩算法,为 AI 内存和长文本处理开辟了新的可能性。
简单来说,DeepSeek 正在探索一种全新的信息存储方式:将文字信息编码到图像中。这意味着,我们可以将原本需要大量文本才能表达的内容,压缩到一个单一的图像里,并通过 AI 模型完美地读取出来。
DeepSeek OCR 的核心技术:语境光学压缩
DeepSeek OCR 的核心在于其使用的“语境光学压缩”技术。 这种技术旨在使用视觉作为文本的压缩算法。
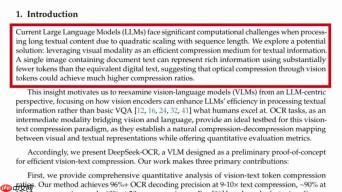
核心思想是将大量的文本信息通过某种方式“编码”进一张图像中,再通过AI模型将这些信息“解码”出来。 这种方法类似于将文本数据转换成一种视觉密码,从而实现高效率的信息存储和传递。
DeepSeek OCR 所展现的能力,已经远超简单的文档读取,它揭示了 AI 记忆和长语境处理的全新思路。
语境光学压缩的优势在于:

- 极高的压缩率:一张图像可以存储相当于数千字的信息,大幅减少存储空间占用。
- 快速的信息读取:AI 模型能够迅速解码图像中的信息,实现高效的信息检索。
- 潜在的应用前景:该技术为 AI 记忆、长语境处理以及其他相关领域带来了革命性的可能性。
DeepSeek OCR 技术细节
DeepSeek OCR的技术架构
DeepSeek OCR的技术架构是什么?让我们来深入了解DeepSeek OCR模型的技术细节,从而更好的理解这个模型。
- Deep Encoder:这个是核心引擎,旨在保持高分辨率输入下的低激活状态,同时实现高压缩比,确保视觉token的数量控制在最佳和可管理范围内。
- DeepSeek3B-MoE-A570M:这是解码器,用于将压缩后的视觉token转换回文本。
这样的双组件设计使得 DeepSeek OCR 能够在保证高精度的前提下,实现对长文本的高效压缩和解码。这为解决当前大型语言模型在处理长文本内容时面临的计算挑战提供了一种可行的方案。
以下表格可以帮助我们更清晰的了解 Deep Encoder 的具体技术参数指标:
| 组件 | 技术指标 |
|---|---|
| 输入 | 文档图像,分割成 n×16×16 的图像块 |
| 局部注意力 Tokenizer | 使用 ViTDet 80M 和 SAM |
| 卷积 (Conv) | 用于 16 倍的下采样,减少 vision tokens 的数量 |
| Embedding 层 (CLIP) | 使用 ViT 300M 实现全局注意力机制 |
| DeepSeek-3B (解码器) | MoE-A570M,用于从 vision tokens 中解码文本,并利用提示词提高生成质量 |
论文中指出,该模型在OCR解码方面达到了超过96%的精度。当文本token的数量在视觉token的10倍以内时,模型可以实现97%的解码精度。即使在压缩率高达20倍的情况下,OCR的准确率仍然保持在60%左右。
DeepSeek OCR 的潜在应用场景
OCR任务
DeepSeek OCR 本身可以用于执行各种 OCR 任务,例如扫描文档,识别图片中的文字,从图像中提取信息等。
- 自动文档处理:DeepSeek OCR 可以应用于自动处理大量文档,提取关键信息,减少人工录入的工作量。
- 图像文字识别:帮助识别图像中的文字信息,例如交通标志识别,商品标签识别等。
- 信息无障碍: 帮助视力障碍人士读取图片中的文字,提高信息获取的便利性。
AI 内存优化
通过将长文本压缩到图像中,DeepSeek OCR 有助于降低 AI 模型的内存占用,从而提升模型的性能和效率。可以应用到AI的各个领域,例如对话机器人、文本摘要、机器翻译等等。
- 长文本对话:在对话系统中,DeepSeek OCR 可以帮助压缩对话历史,从而支持更长程的对话。
- 高效文本摘要:可以用于提取文档的关键信息,生成简洁的摘要,提高信息获取效率。
- 更快的机器翻译: 压缩原文信息有助于提升翻译速度和质量。
长文本处理
DeepSeek OCR 的语境光学压缩技术可以有效扩展 AI 模型处理长文本的能力,使其能够处理更复杂的任务。对提升AI模型在阅读理解,知识图谱,内容创作方面的能力至关重要。
- 深入阅读理解: 支持 AI 模型理解长篇文章的复杂逻辑和细节。
- 构建大型知识图谱: 可以帮助 AI 模型从海量信息中提取知识,构建更全面的知识图谱。
- 高质量内容创作: 提升 AI 模型生成长篇文章、剧本等复杂内容的能力。
DeepSeek OCR 的优缺点分析
? Pros
高效的文本压缩能力
高精度的 OCR 性能
对 AI 内存和长文本处理的潜在价值
? Cons
仍处于研究阶段,实际应用效果有待验证
技术实现较为复杂,需要一定的技术门槛
常见问题解答
DeepSeek OCR 与传统 OCR 技术有什么不同?
传统 OCR 技术主要关注于文字识别的准确性,而 DeepSeek OCR 在此基础上,更侧重于利用视觉压缩技术来优化 AI 内存和长文本处理。它不仅能识别文字,还能将文字信息编码到图像中,实现更高的压缩率和信息读取效率。
DeepSeek OCR 的“语境光学压缩”技术是什么?
“语境光学压缩”是一种利用视觉作为文本压缩算法的技术。它将大量的文本信息通过某种方式“编码”进一张图像中,再通过 AI 模型将这些信息“解码”出来。这种方法类似于将文本数据转换成一种视觉密码,从而实现高效率的信息存储和传递。
DeepSeek OCR 在实际应用中的优势是什么?
DeepSeek OCR 在实际应用中的优势主要体现在以下几个方面: 极高的压缩率:一张图像可以存储相当于数千字的信息,大幅减少存储空间占用。 快速的信息读取:AI 模型能够迅速解码图像中的信息,实现高效的信息检索。 潜在的应用前景:该技术为 AI 记忆、长语境处理以及其他相关领域带来了革命性的可能性。
DeepSeek OCR 的技术架构是怎样的?
DeepSeek OCR 的技术架构主要包含两个组件:DeepEncoder 和 DeepSeek3B-MoE-A570M。 DeepEncoder 是核心引擎,旨在保持高分辨率输入下的低激活状态,同时实现高压缩比,确保视觉 token 的数量控制在最佳和可管理范围内。 DeepSeek3B-MoE-A570M 是解码器,用于将压缩后的视觉 token 转换回文本。 这样的双组件设计使得 DeepSeek OCR 能够在保证高精度的前提下,实现对长文本的高效压缩和解码。
相关问题探讨
视觉Transformer(ViT)模型如何帮助 DeepSeek OCR 实现视觉压缩?
视觉Transformer(ViT)模型在 DeepSeek OCR 中扮演着至关重要的角色,它负责将图像信息转换成 AI 模型可以理解的 token 序列,从而实现视觉压缩。 Vision Transformer (ViT) 的工作原理可以概括为以下几个步骤: 图像分割:首先,ViT 将输入图像分割成一系列固定大小的图像块(patches)。每个图像块都可以看作是图像的一个局部特征。 线性嵌入:然后,ViT 将每个图像块通过一个线性变换层,将其映射到一个高维向量空间中。这个过程称为线性嵌入(Linear Embedding)。 位置编码:为了让模型能够理解图像块之间的位置关系,ViT 会为每个图像块添加一个位置编码(Position Embedding)。 Transformer 编码器:接下来,嵌入后的图像块序列会被送入 Transformer 编码器中进行处理。Transformer 编码器利用自注意力机制(Self-Attention)来捕捉图像块之间的依赖关系,从而提取图像的全局特征。 输出分类:最后,Transformer 编码器的输出会被送入一个分类头(Classification Head),用于进行图像分类或其他任务。 在 DeepSeek OCR 中,ViT 模型主要用于将文档图像分割成小的图像块,然后通过线性嵌入和 Transformer 编码器提取这些图像块的特征。这些特征经过压缩和编码后,就可以存储在图像中,并通过 AI 模型进行解码。






