随着人工智能技术的飞速发展,代码生成语言模型正逐渐成为软件开发领域的一颗新星。这些模型利用深度学习技术,能够根据自然语言描述或其他形式的指令,自动生成计算机代码。这种能力不仅极大地提高了开发效率,还降低了软件开发的门槛,使得更多的人能够参与到编程过程中来。 从最初的辅助代码片段生成到如今能够构建完整的应用程序,代码生成语言模型的能力正在不断增强。它们通过学习大量的代码库和相关的文档资料,理解编程语言的语法、语义以及最佳实践,从而能够生成高质量、可维护的代码。然而,尽管代码生成语言模型取得了显著的进展,但仍然面临着诸多挑战。例如,如何保证生成代码的正确性、如何处理复杂的编程逻辑、如何适应不同的编程风格和规范等问题,都是当前研究的热点。此外,随着模型规模的不断扩大,如何降低计算成本、提高训练效率也成为了亟待解决的问题。本文旨在对代码生成语言模型的现状、挑战以及未来的发展趋势进行全面的探讨,为相关领域的研究者和开发者提供参考。
关键要点
代码生成语言模型旨在提升软件开发效率并降低编程门槛。
这些模型通过学习大量代码和文档,理解编程语言的规则。
尽管进步显著,但保证生成代码的正确性仍是一个挑战。
计算成本和训练效率是模型规模扩展的重要考量因素。
未来的研究将着重于提高模型的智能和适应性。
预训练多任务语言模型是解决单任务模型局限性的有效方法。
收集标注的训练数据需要大量的精力和成本。
模型的参数规模在不断增大,计算需求也在增长。
Transformer架构已成为主流,并不断演进。
自动化代码生成将支持开发人员完成代码相关任务,以提高生产力
代码生成语言模型的概述
什么是代码生成语言模型?
代码生成语言模型是一种人工智能模型,它使用自然语言处理(nlp)技术来理解人类的意图,并将这些意图转化为可执行的计算机代码。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
这种模型通常基于深度学习架构,例如循环神经网络(RNN)和Transformer,并经过大量的代码数据训练,使其能够理解各种编程语言的语法和语义。简单来说,代码生成语言模型就像一个智能的程序员助手,它可以根据你的需求,自动生成相应的代码,从而极大地提高编程效率和降低开发成本。 代码生成语言模型的核心功能在于它能够将高级的、人类可读的描述(例如自然语言指令)转化为低级的、机器可执行的代码。这种转化过程涉及多个步骤,包括:
- 自然语言理解:模型首先需要理解输入的自然语言描述,提取出用户的意图和需求。
- 代码生成:模型根据理解的意图,生成相应的代码片段或完整的代码文件。
- 代码优化:模型对生成的代码进行优化,例如去除冗余代码、提高代码效率等。
在实际应用中,代码生成语言模型可以用于各种不同的编程任务,例如:
- 自动化测试:自动生成测试用例,提高测试覆盖率。
- 代码补全:根据已有的代码,预测并生成后续的代码片段。
- API调用:自动生成API调用代码,简化API的使用。
- 软件开发:根据需求描述,自动生成完整的软件应用程序。通过自动代码生成可以支持开发人员完成代码相关任务,以提高生产力。
经典单任务语言模型及其局限性
在代码生成语言模型的发展初期,研究人员主要关注单任务语言模型。
这些模型通常针对特定的编程任务进行训练,例如代码补全、代码翻译等。虽然这些模型在各自的任务上取得了不错的效果,但由于缺乏通用性和泛化能力,难以适应不同的编程场景。具体来说,经典单任务语言模型存在以下几个主要的局限性:
- 数据依赖性:单任务模型通常需要大量的标注数据进行训练,而标注数据的获取往往需要耗费大量的人力和时间。
- 任务局限性:单任务模型只能解决特定的编程任务,难以应对复杂多变的编程需求。
- 鲁棒性不足:单任务模型对于输入数据的变化非常敏感,容易受到噪声和异常数据的影响。
-
迁移能力差:单任务模型难以将学习到的知识迁移到其他相关的编程任务中。
单任务模型 trained on labeled data,经常缺乏鲁棒性和灵活性,无法应对实际开发中复杂多变的场景。
例如,一个专门用于代码补全的模型,可能无法很好地完成代码翻译的任务;一个在Java代码上训练的模型,可能无法很好地处理Python代码。这种局限性严重阻碍了代码生成语言模型在实际应用中的推广。 此外,收集标注的训练数据涉及大量的精力和成本,包括自然语言和代码,需要专业的编程知识来正确标注代码片段。
为了克服单任务模型的局限性,研究人员开始探索多任务语言模型。这些模型通过共享参数和学习通用表示,能够同时处理多个不同的编程任务,从而提高模型的泛化能力和鲁棒性。 多任务语言模型使用大量未标记的数据进行无监督的预训练,然后适应各种任务,可以减少任务范围内标记数据的需求。
预训练多任务语言模型:解决之道
为了克服经典单任务语言模型的局限性,研究人员提出了预训练多任务语言模型
。这种模型首先在大规模的未标注数据上进行预训练,学习通用的语言表示,然后在特定的编程任务上进行微调,从而能够快速适应不同的编程场景。预训练多任务语言模型的核心思想在于迁移学习。通过在大规模数据上进行预训练,模型能够学习到通用的语言知识和编程规则,这些知识可以被迁移到各种不同的编程任务中。这样,模型在新的任务上只需要进行少量的微调,就能够取得不错的效果。 预训练多任务语言模型不仅可以提高模型的泛化能力,还可以减少对标注数据的依赖。由于模型已经学习到了通用的语言知识,因此在新的任务上只需要少量的标注数据就可以进行微调。这大大降低了标注数据的获取成本,使得代码生成语言模型能够更容易地应用于各种不同的编程场景。
预训练多任务语言模型的优势主要体现在以下几个方面:
- 提高泛化能力:通过学习通用语言表示,模型能够更好地适应不同的编程任务。
- 降低数据依赖:减少对标注数据的依赖,降低数据获取成本。
- 加速模型训练:通过迁移学习,模型能够更快地适应新的任务。
- 提高模型鲁棒性:通过学习大规模数据,模型能够更好地处理噪声和异常数据。
预训练多任务语言模型已经成为代码生成领域的主流方法,例如:

librosa 是一个用于音频和音乐分析的 Python 库。它提供了特征提取、频谱分析、节拍跟踪、起始检测和音频可视化的工具,基于 NumPy 和 SciPy 构建,用于科学音频计算。
- CodeBERT:一种基于Transformer的代码表示模型,通过学习代码和自然语言之间的映射关系,能够用于各种不同的代码理解和生成任务。
- PLBART:一种用于代码翻译的模型,通过学习不同编程语言之间的映射关系,能够实现代码在不同语言之间的自动翻译。
- GPT-Neo/GPT-J: 是 EleutherAI 使用 Mesh Transformer JAX 重新实现 GPT-3 和 GPT-J 的开源项目。通过开源预训练和微调策略,可以构建强大的代码生成模型,降低开发成本。
参数规模的爆炸式增长
近年来,代码生成语言模型的参数规模呈现出爆炸式增长的趋势。
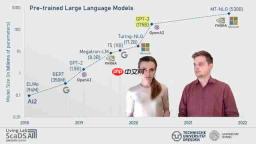
从最初的几百万参数到如今的数千亿参数,模型的规模不断扩大,这也带来了模型能力的显著提升。模型规模的增长主要得益于以下几个方面:
- 计算能力的提升:随着GPU等硬件设备的不断发展,计算能力得到了极大的提升,使得训练更大规模的模型成为可能。
- 数据规模的扩大:互联网上的代码数据越来越多,为模型提供了丰富的训练资源。
- 算法的改进:新的算法不断涌现,使得模型能够更有效地利用大规模数据。
模型规模的增长对代码生成语言模型的能力产生了深远的影响:
- 提高代码质量:更大规模的模型能够学习到更多的代码知识和编程规则,从而生成更高质量的代码。
- 提高代码理解能力:更大规模的模型能够更好地理解代码的语义和上下文关系,从而更好地完成代码理解任务。
- 提高代码生成能力:更大规模的模型能够生成更复杂的代码结构和更长的代码序列,从而更好地完成代码生成任务。
尽管模型规模的增长带来了诸多好处,但也带来了一些挑战:
- 计算成本:训练更大规模的模型需要消耗更多的计算资源,增加了计算成本。
- 存储成本:更大规模的模型需要消耗更多的存储空间,增加了存储成本。
- 训练难度:训练更大规模的模型需要更复杂的训练技巧,增加了训练难度。
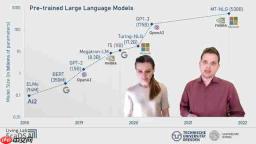
随着模型规模的不断扩大,如何降低计算成本、提高训练效率将成为未来的研究重点。 下面展示了模型大小在参数规模上的增长:
| 模型名称 | 发布时间 | 参数规模 (亿) | 架构 |
|---|---|---|---|
| ELMo | 2018 | 0.94 | RNN |
| BERT | 2018 | 3.5 | Transformer |
| GPT-2 | 2019 | 15 | Transformer |
| T5 | 2020 | 110 | Transformer |
| GPT-3 | 2020 | 1750 | Transformer |
| MT-NLG | 2021 | 5300 | Transformer |
| WuDao | 未知 | 17500 | Transformer |
| Switch Transformer | 未知 | 16000 | Transformer |
代码相关任务的语言模型
代码相关任务的语言模型盘点
为了更好地应用于代码相关的任务,研究人员针对性地开发了一系列语言模型 。这些模型通过在大量的代码数据上进行训练,能够更好地理解代码的特性和规律,从而在代码生成、代码补全、代码翻译等任务上取得更好的效果。以下是一些比较有代表性的代码相关任务语言模型:
- CodeGPT:基于GPT架构的代码生成模型,通过学习代码的语法和语义,能够自动生成高质量的代码片段。
- CodeBERT:基于BERT架构的代码表示模型,通过学习代码和自然语言之间的映射关系,能够用于各种不同的代码理解和生成任务。
- CodeT5:一种用于代码翻译的模型,通过学习不同编程语言之间的映射关系,能够实现代码在不同语言之间的自动翻译。
- CuBERT:这是谷歌开发的一款模型,主要用于理解代码的语义。
- TabNine:一款商业代码补全工具,使用了深度学习技术来预测和生成代码。
- PyMT5: 一款基于 T5 架构的预训练模型,专门为 Python 代码生成和理解而设计。
- PLBART:基于BART架构的代码翻译模型,通过学习不同编程语言之间的映射关系,能够实现代码在不同语言之间的自动翻译。
- CodeParrot: 是一个开源的语言模型,专门为代码生成任务设计,它基于 GPT-2 架构,并在大量代码数据上进行了训练。
- GPT-Neo: 是 EleutherAI 使用 Mesh Transformer JAX 重新实现 GPT-3 的开源项目。使用开源预训练和微调策略,可以降低开发成本。
- PolyCoder: 由 Salesforce Research 开发,是一个自回归语言模型,经过 160GB 的代码数据训练,支持多种编程语言的代码生成。
- GPT-J: 是一个由 EleutherAI 发布的自回归语言模型,拥有 60 亿个参数,在代码生成方面表现出色。
- Codex:由OpenAI开发,是一种基于GPT-3架构的代码生成模型,具有强大的代码生成能力,可以根据自然语言描述生成各种不同的代码。
- GPT-NeoX: 是 EleutherAI 的 GPT-3 模型的开源替代品。能够生成高质量的代码和文本。
- AlphaCode: 由 DeepMind 开发,专门为解决编程竞赛问题而设计,通过生成大量候选解决方案,然后进行筛选,从而在编程竞赛中取得优异成绩。
- Austin '21: 模型在代码生成和理解方面都表现出很高的水平,能够处理复杂的编程任务。
这些模型在代码相关任务上取得了显著的进展,但也存在一些问题,例如:
- 模型的可解释性不足:这些模型通常是黑盒模型,难以理解其内部的工作原理。
- 模型的鲁棒性不足:这些模型对于输入数据的变化非常敏感,容易受到噪声和异常数据的影响。
未来的研究将着重于提高模型的可解释性和鲁棒性,使得代码相关任务的语言模型能够更好地应用于实际的软件开发中。
如何有效地使用代码生成语言模型
选择合适的模型
根据您的具体需求选择合适的代码生成模型。不同的模型在不同的编程任务上表现不同,有些模型擅长代码补全,有些模型擅长代码翻译,还有些模型擅长代码生成。确保选择的模型与您的需求相符。
可以考虑模型参数规模、训练数据类型、模型架构等因素。
提供清晰明确的指令
代码生成模型是根据您提供的指令来生成代码的,因此,提供清晰明确的指令至关重要。指令越清晰明确,模型生成代码的质量就越高。例如,如果您需要模型生成一个计算两个数之和的函数,您可以这样描述:
"请生成一个Python函数,该函数接收两个数字作为输入,并返回它们的和。" 模糊或不明确的指令可能导致模型生成不符合您要求的代码。
进行代码审查和测试
即使代码生成模型生成的代码看起来没有问题,也需要进行代码审查和测试,以确保代码的正确性和安全性。可以使用代码安全分析工具来检查代码中是否存在潜在的安全漏洞,并进行单元测试来验证代码的功能是否符合预期。人工审查过程,可以帮助识别潜在的缺陷或漏洞。
理解模型的局限性
代码生成模型不是万能的,它们在处理复杂逻辑、适应不同编程风格和规范以及保证生成代码的正确性等方面仍然存在局限性。因此,在使用代码生成模型时,需要理解其局限性,并采取相应的措施来弥补这些局限性。结合人类的专业知识和判断,可以更好地利用代码生成模型。
持续学习和实践
代码生成模型是一个快速发展的领域,新的模型和技术不断涌现。因此,需要持续学习和实践,了解最新的进展,并将其应用到实际的开发工作中。通过参与开源项目、阅读相关论文和博客,可以不断提高您在使用代码生成模型方面的技能。 参与社区讨论可以帮助理解代码生成模型的使用技巧。
代码生成语言模型的优缺点
? Pros
提高开发效率:自动化代码生成可以极大地提高开发效率,减少重复性劳动。
降低开发门槛:使得非专业的开发人员也能够快速构建应用程序。
提高代码质量:更大规模的模型能够学习到更多的代码知识和编程规则,从而生成更高质量的代码。
降低开发成本:减少对专业开发人员的依赖,降低人力成本。
? Cons
难以处理复杂逻辑:对于复杂的编程逻辑,模型可能难以生成正确的代码。
安全风险:模型可能会生成包含漏洞或不安全的代码,导致安全问题。
模型的可解释性不足:这些模型通常是黑盒模型,难以理解其内部的工作原理。
需要大量的训练数据:训练这些模型需要消耗大量的计算资源和数据。
常见问题解答(FAQ)
代码生成语言模型能够完全取代程序员吗?
目前来看,代码生成语言模型还无法完全取代程序员。尽管它们在自动化代码生成方面取得了显著的进展,但仍然存在一些局限性。例如,它们难以处理复杂的编程逻辑、难以适应不同的编程风格和规范,以及难以保证生成代码的正确性。因此,在未来的很长一段时间内,代码生成语言模型更可能扮演一个辅助程序员的角色,帮助程序员提高编程效率和降低开发成本,而不是完全取代程序员。 自动代码生成可以帮助支持开发人员完成代码相关任务,以提高生产力。此外,程序员的创造性思维、问题解决能力和沟通能力,是代码生成语言模型难以替代的。
如何评估代码生成语言模型的好坏?
评估代码生成语言模型的好坏需要从多个方面进行考虑。首先,需要评估模型生成代码的正确性,即生成的代码是否能够正确地实现用户的意图。其次,需要评估模型生成代码的效率,即生成的代码是否能够高效地运行。此外,还需要评估模型生成代码的可读性和可维护性,即生成的代码是否易于理解和修改。常用的评估指标包括: BLEU:一种用于评估机器翻译质量的指标,可以用于评估代码翻译的质量。 CodeBLEU:一种专门用于评估代码生成质量的指标,考虑了代码的语法、语义以及风格等因素。 Execution Accuracy: 一种评估代码功能正确性的指标,通过测试生成的代码在预定义的测试用例上的执行结果来判断其是否正确实现了预期功能。 此外,还可以通过人工评估的方式来评估模型生成代码的质量。人工评估通常需要专业的程序员对生成的代码进行审查,并给出相应的评分。
代码生成语言模型未来的发展趋势是什么?
代码生成语言模型未来的发展趋势主要体现在以下几个方面: 模型规模的持续扩大:随着计算能力的不断提升和数据规模的不断扩大,代码生成语言模型的规模将继续扩大,从而提高模型的性能。 模型可解释性的提高:未来的研究将着重于提高模型的可解释性,使得人们能够更好地理解模型的内部工作原理。 模型鲁棒性的增强:未来的研究将着重于增强模型的鲁棒性,使得模型能够更好地处理噪声和异常数据。 模型通用性的提升:未来的研究将着重于提高模型的通用性,使得模型能够更好地适应不同的编程场景。 多模态输入的引入:未来的代码生成语言模型将能够处理多模态输入,例如图像、语音等,从而更好地理解用户的意图。 代码生成和验证的结合:未来的代码生成语言模型将能够与代码验证工具相结合,从而更好地保证生成代码的正确性。 特定领域的优化:未来会出现更多针对特定领域(如金融、医疗等)优化的代码生成模型。
相关问题
代码生成模型中的Transformer架构有何优势?
Transformer 架构在代码生成模型中占据了主导地位,这得益于其独特的优势: 并行计算能力:Transformer 模型依赖自注意力机制,允许模型并行处理输入序列中的所有位置,这大大加快了训练速度,使其能够处理大规模的代码数据集。 长距离依赖建模:自注意力机制能够有效地捕捉代码中长距离的依赖关系,这对于理解代码的上下文至关重要。例如,理解一个函数调用需要知道该函数在何处定义,即使定义位置距离调用位置很远。 上下文理解能力:Transformer 模型能够同时考虑代码的上下文信息,从而更准确地生成代码。例如,在代码补全任务中,模型可以根据已有的代码,预测并生成后续的代码片段。 可扩展性:Transformer 架构易于扩展,可以通过增加模型层数或调整模型参数来提高模型的性能。 迁移学习能力:Transformer 模型在大规模代码数据集上预训练后,可以快速迁移到其他代码相关的任务中,例如代码翻译、代码摘要等。 Transformer 的这些优点,使得它成为构建高性能代码生成模型的理想选择。许多先进的代码生成模型,如 CodeBERT、GPT-3 和 Codex,都基于 Transformer 架构。
如何解决代码生成模型生成不安全代码的问题?
代码生成模型在提高开发效率的同时,也带来了一些安全风险。模型可能会生成包含漏洞或不安全的代码,从而导致安全问题。为了解决这个问题,可以采取以下措施: 安全意识的训练数据:在训练模型时,使用包含安全漏洞信息的代码数据,让模型学习到哪些代码是不安全的。 安全规则的嵌入:将安全规则嵌入到模型中,例如禁止使用某些不安全的函数或API。 代码安全分析工具的集成:将代码安全分析工具与模型集成,在生成代码后,自动对代码进行安全分析,并修复潜在的安全问题。 强化学习的应用:使用强化学习技术来训练模型,让模型学习到生成安全代码的策略。 对抗训练:使用对抗训练技术来提高模型的鲁棒性,防止模型生成容易受到攻击的代码。 人工审查:对模型生成的代码进行人工审查,确保代码的安全性和正确性。 人工审核通过确保自动生成的代码遵循最佳实践和安全标准来帮助识别潜在的缺陷或漏洞。 通过以上措施,可以有效地解决代码生成模型生成不安全代码的问题,从而保证软件系统的安全性。
代码生成模型在低代码/无代码平台中的应用前景如何?
代码生成模型在低代码/无代码平台中具有广阔的应用前景。低代码/无代码平台旨在降低软件开发的门槛,使得非专业的开发人员也能够快速构建应用程序。代码生成模型可以作为低代码/无代码平台的核心组件,帮助用户自动生成代码,从而简化开发过程。具体来说,代码生成模型可以在以下几个方面发挥作用: 可视化编程:用户可以通过拖拽组件、连接流程等方式进行可视化编程,代码生成模型可以将这些可视化操作转化为实际的代码。 自然语言编程:用户可以通过自然语言描述应用程序的需求,代码生成模型可以将这些描述转化为实际的代码。 自动化测试:代码生成模型可以自动生成测试用例,提高测试覆盖率。 通过代码生成模型的应用,低代码/无代码平台能够进一步降低软件开发的门槛,提高开发效率,并为用户提供更加灵活和强大的开发能力。 值得提到的是,微软的Power Platform, Salesforce的Lightning Platform 都属于low code平台。