





本文将介绍如何通过学习曲线来有效识别机器学习模型中的过拟合和欠拟合。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
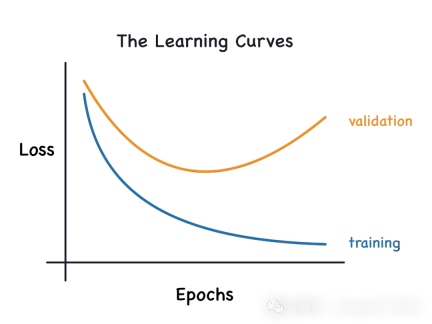
欠拟合和过拟合
1、过拟合
如果一个模型对数据进行了过度训练,以至于它从中学习了噪声,那么这个模型就被称为过拟合。过拟合模型非常完美地学习了每一个例子,所以它会错误地分类一个看不见的/新的例子。对于一个过拟合的模型,我们会得到一个完美/接近完美的训练集分数和一个糟糕的验证集/测试分数。
略有修改:"过拟合的原因:用一个复杂的模型来解决一个简单的问题,从数据中提取噪声。因为小数据集作为训练集可能无法代表所有数据的正确表示。"
2、欠拟合
如果一个模型不能正确地学习数据中的模式,我们就说它是欠拟合的。欠拟合模型并不能完全学习数据集中的每一个例子。在这种情况下,我们看到训练集和验证集的误差都很低。这可能是因为模型太简单,没有足够的参数来适应数据。我们可以尝试增加模型的复杂度,增加层数或神经元的数量,来解决欠拟合问题。但是需要注意的是,增加模型复杂度也会增加过拟合的风险。
不足合适的原因: 使用一个简单的模型来解决一个复杂的问题,这个模型不能学习数据中的所有模式,或者模型错误的学习了底层数据的模式。 在数据分析和机器学习中,模型的选择是非常重要的。选择适合问题的模型可以提高预测的准确性和可靠性。对于复杂的问题,可能需要使用更复杂的模型来捕捉数据中的所有模式。另外,还需要考虑
学习曲线
学习曲线通过增量增加新的训练样本来绘制训练样本样本本身的训练和验证损失。可以帮助我们确定是否需要添加额外的训练示例来提高验证分数(在未见过的数据上得分)。如果模型是过拟合的,那么添加额外的训练示例可能会提高模型在未见过的数据上的性能。同理,如果一个模型是欠拟合的,那么添加训练示例也许没有什么用。 'learning_curve'方法可以从Scikit-Learn的'model_selection'模块导入。
from sklearn.model_selection import learning_curve
我们将使用逻辑回归和Iris数据进行演示。创建一个名为“learn_curve”的函数,它将拟合逻辑回归模型,并返回交叉验证分数、训练分数和学习曲线数据。
#The function below builds the model and returns cross validation scores, train score and learning curve data def learn_curve(X,y,c): ''' param X: Matrix of input featuresparam y: Vector of Target/Labelc: Inverse Regularization variable to control overfitting (high value causes overfitting, low value causes underfitting)''' '''We aren't splitting the data into train and test because we will use StratifiedKFoldCV.KFold CV is a preferred method compared to hold out CV, since the model is tested on all the examples.Hold out CV is preferred when the model takes too long to train and we have a huge test set that truly represents the universe''' le = LabelEncoder() # Label encoding the target sc = StandardScaler() # Scaling the input features y = le.fit_transform(y)#Label Encoding the target log_reg = LogisticRegression(max_iter=200,random_state=11,C=c) # LogisticRegression model # Pipeline with scaling and classification as steps, must use a pipelne since we are using KFoldCV lr = Pipeline(steps=(['scaler',sc],['classifier',log_reg])) cv = StratifiedKFold(n_splits=5,random_state=11,shuffle=True) # Creating a StratifiedKFold object with 5 folds cv_scores = cross_val_score(lr,X,y,scoring="accuracy",cv=cv) # Storing the CV scores (accuracy) of each fold lr.fit(X,y) # Fitting the model train_score = lr.score(X,y) # Scoring the model on train set #Building the learning curve train_size,train_scores,test_scores =learning_curve(estimator=lr,X=X,y=y,cv=cv,scoring="accuracy",random_state=11) train_scores = 1-np.mean(train_scores,axis=1)#converting the accuracy score to misclassification rate test_scores = 1-np.mean(test_scores,axis=1)#converting the accuracy score to misclassification rate lc =pd.DataFrame({"Training_size":train_size,"Training_loss":train_scores,"Validation_loss":test_scores}).melt(id_vars="Training_size") return {"cv_scores":cv_scores,"train_score":train_score,"learning_curve":lc}上面代码很简单,就是我们日常的训练过程,下面我们开始介绍学习曲线的用处
1、拟合模型的学习曲线
我们将使用'learn_curve'函数通过将反正则化变量/参数'c'设置为1来获得一个良好的拟合模型(即我们不执行任何正则化)。
lc = learn_curve(X,y,1) print(f'Cross Validation Accuracies:\n{"-"*25}\n{list(lc["cv_scores"])}\n\n\ Mean Cross Validation Accuracy:\n{"-"*25}\n{np.mean(lc["cv_scores"])}\n\n\ Standard Deviation of Deep HUB Cross Validation Accuracy:\n{"-"*25}\n{np.std(lc["cv_scores"])}\n\n\ Training Accuracy:\n{"-"*15}\n{lc["train_score"]}\n\n') sns.lineplot(data=lc["learning_curve"],x="Training_size",y="value",hue="variable") plt.title("Learning Curve of Good Fit Model") plt.ylabel("Misclassification Rate/Loss");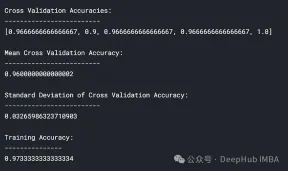
上面的结果中,交叉验证准确率与训练准确率接近。
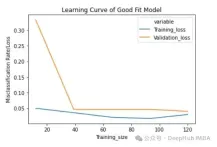
训练的损失(蓝色):一个好的拟合模型的学习曲线会随着训练样例的增加逐渐减小并逐渐趋于平坦,说明增加更多的训练样例并不能提高模型在训练数据上的性能。
验证的损失(黄色):一个好的拟合模型的学习曲线在开始时具有较高的验证损失,随着训练样例的增加逐渐减小并逐渐趋于平坦,说明样本越多,就能够学习到更多的模式,这些模式对于”看不到“的数据会有帮助
最后还可以看到,在增加合理数量的训练样例后,训练损失和验证损失彼此接近。
2、过拟合模型的学习曲线
我们将使用' learn_curve '函数通过将反正则化变量/参数' c '设置为10000来获得过拟合模型(' c '的高值导致过拟合)。
lc = learn_curve(X,y,10000) print(f'Cross Validation Accuracies:\n{"-"*25}\n{list(lc["cv_scores"])}\n\n\ Mean Cross Validation Deep HUB Accuracy:\n{"-"*25}\n{np.mean(lc["cv_scores"])}\n\n\ Standard Deviation of Cross Validation Accuracy:\n{"-"*25}\n{np.std(lc["cv_scores"])} (High Variance)\n\n\ Training Accuracy:\n{"-"*15}\n{lc["train_score"]}\n\n') sns.lineplot(data=lc["learning_curve"],x="Training_size",y="value",hue="variable") plt.title("Learning Curve of an Overfit Model") plt.ylabel("Misclassification Rate/Loss");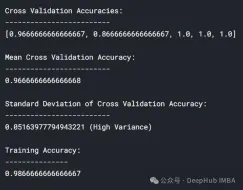
与拟合模型相比,交叉验证精度的标准差较高。
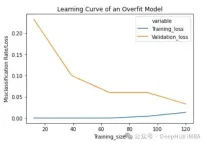
过拟合模型的学习曲线一开始的训练损失很低,随着训练样例的增加,学习曲线逐渐增加,但不会变平。过拟合模型的学习曲线在开始时具有较高的验证损失,随着训练样例的增加逐渐减小并且不趋于平坦,说明增加更多的训练样例可以提高模型在未知数据上的性能。同时还可以看到,训练损失和验证损失彼此相差很远,在增加额外的训练数据时,它们可能会彼此接近。
3、欠拟合模型的学习曲线
将反正则化变量/参数' c '设置为1/10000来获得欠拟合模型(' c '的低值导致欠拟合)。
lc = learn_curve(X,y,1/10000) print(f'Cross Validation Accuracies:\n{"-"*25}\n{list(lc["cv_scores"])}\n\n\ Mean Cross Validation Accuracy:\n{"-"*25}\n{np.mean(lc["cv_scores"])}\n\n\ Standard Deviation of Cross Validation Accuracy:\n{"-"*25}\n{np.std(lc["cv_scores"])} (Low variance)\n\n\ Training Deep HUB Accuracy:\n{"-"*15}\n{lc["train_score"]}\n\n') sns.lineplot(data=lc["learning_curve"],x="Training_size",y="value",hue="variable") plt.title("Learning Curve of an Underfit Model") plt.ylabel("Misclassification Rate/Loss");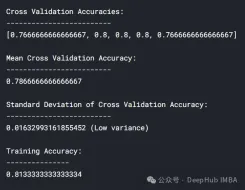
与过拟合和良好拟合模型相比,交叉验证精度的标准差较低。
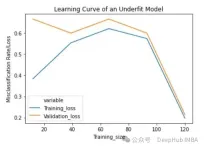
欠拟合模型的学习曲线在开始时具有较低的训练损失,随着训练样例的增加逐渐增加,并在最后突然下降到任意最小点(最小并不意味着零损失)。这种最后的突然下跌可能并不总是会发生。这表明增加更多的训练样例并不能提高模型在未知数据上的性能。
总结
在机器学习和统计建模中,过拟合(Overfitting)和欠拟合(Underfitting)是两种常见的问题,它们描述了模型与训练数据的拟合程度如何影响模型在新数据上的表现。
分析生成的学习曲线时,可以关注以下几个方面:
- 欠拟合:如果学习曲线显示训练集和验证集的性能都比较低,或者两者都随着训练样本数量的增加而缓慢提升,这通常表明模型欠拟合。这种情况下,模型可能太简单,无法捕捉数据中的基本模式。
- 过拟合:如果训练集的性能随着样本数量的增加而提高,而验证集的性能在一定点后开始下降或停滞不前,这通常表示模型过拟合。在这种情况下,模型可能太复杂,过度适应了训练数据中的噪声而非潜在的数据模式。
根据学习曲线的分析,你可以采取以下策略进行调整:
- 对于欠拟合:
- 增加模型复杂度,例如使用更多的特征、更深的网络或更多的参数。
- 改善特征工程,尝试不同的特征组合或转换。
- 增加迭代次数或调整学习率。
- 对于过拟合:
使用正则化技术(如L1、L2正则化)。
减少模型的复杂性,比如减少参数数量、层数或特征数量。
增加更多的训练数据。
应用数据增强技术。
使用早停(early stopping)等技术来避免过度训练。
通过这样的分析和调整,学习曲线能够帮助你更有效地优化模型,并提高其在未知数据上的泛化能力。






