canal的介绍
canal的历史由来
在早期的时候,阿里巴巴公司因为杭州和美国两个地方的机房都部署了数据库实例,但因为跨机房同步数据的业务需求 ,便孕育而生出了canal,主要是基于trigger(触发器)的方式获取增量变更。从2010年开始,阿里巴巴公司开始逐步尝试数据库日志解析,获取增量变更的数据进行同步,由此衍生出了增量订阅和消费业务。
当前的canal支持的数据源端mysql版本包括:5.1.x 、5.5.x 、5.6.x、5.7.x、8.0.x。
canal的应用场景
目前普遍基于日志增量订阅和消费的业务,主要包括:
基于数据库增量日志解析,提供增量数据订阅和消费
数据库镜像 数据库实时备份
索引构建和实时维护(拆分异构索引、倒排索引等)
业务cache刷新
带业务逻辑的增量数据处理
canal的工作原理
在介绍canal的原理之前,我们先来了解下mysql主从复制的原理。
mysql主从复制原理
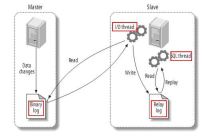
mysql master将数据变更的操作写入二进制日志binary log中, 其中记录的内容叫做二进制日志事件binary log events,可以通过show binlog events命令进行查看
mysql slave会将master的binary log中的binary log events拷贝到它的中继日志relay log
mysql slave重读并执行relay log中的事件,将数据变更映射到它自己的数据库表中
了解了mysql的工作原理,我们可以大致猜想到canal应该也是采用类似的逻辑去实现增量数据订阅的功能,那么接下来我们看看实际上canal的工作原理是怎样的?
canal工作原理
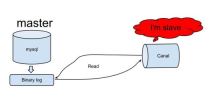
canal模拟mysql slave的交互协议,伪装自己为mysql slave,向mysql master发送dump协议
mysql master收到dump请求,开始推送binary log给slave(也就是canal)
canal解析binary log对象(数据为byte流)
基于这样的原理与方式,便可以完成数据库增量日志的获取解析,提供增量数据订阅和消费,实现mysql实时增量数据传输的功能。
既然canal是这样的一个框架,又是纯java语言编写而成,那么我们接下来就开始学习怎么使用它并把它用到我们的实际工作中。
canal的docker环境准备
因为目前容器化技术的火热,本文通过使用docker来快速搭建开发环境,而传统方式的环境搭建,在我们学会了docker容器环境搭建后,也能自行依葫芦画瓢搭建成功。由于本篇主要讲解canal,所以关于docker的内容不会涉及太多,主要会介绍docker的基本概念和命令使用。 如果你想和更多容器技术专家交流,可以加我微信liyingjiese,备注『加群』。群里每周都有全球各大公司的最佳实践以及行业最新动态 。
什么是docker
相信绝大多数人都使用过虚拟机vmware,在使用vmware进行环境搭建的时候,只需提供了一个普通的系统镜像并成功安装,剩下的软件环境与应用配置还是如我们在本机操作一样在虚拟机里也操作一遍,而且vmware占用宿主机的资源较多,容易造成宿主机卡顿,而且系统镜像本身也占用过多空间。
为了便于大家快速理解docker,便与vmware做对比来做介绍,docker提供了一个开始,打包,运行app的平台,把app(应用)和底层infrastructure(基础设施)隔离开来。docker中最主要的两个概念就是镜像(类似vmware的系统镜像)与容器(类似vmware里安装的系统)。
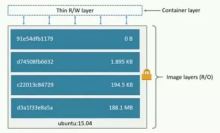
什么是image(镜像)
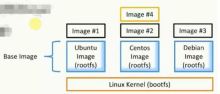
文件和meta data的集合(root filesystem)
分层的,并且每一层都可以添加改变删除文件,成为一个新的image
不同的image可以共享相同的layer
image本身是read-only的
什么是container(容器)
通过image创建(copy)
在image layer之上建立一个container layer(可读写)
类比面向对象:类和实例
image负责app的存储和分发,container负责运行app
docker的网络介绍
docker的网络类型有三种:
bridge:桥接网络。默认情况下启动的docker容器,都是使用bridge,docker安装时创建的桥接网络,每次docker容器重启时,会按照顺序获取对应的ip地址,这个就导致重启下,docker的ip地址就变了。
none:无指定网络。使用 --network=none,docker容器就不会分配局域网的ip。
host:主机网络。若使用--network=host,Docker容器将与主机共享网络,二者可以互相通信。当在一个容器中运行一个监听8080端口的web服务时,容器会自动映射到主机的8080端口。
创建自定义网络:(设置固定ip)
docker network create --subnet=172.18.0.0/16 mynetwork
查看存在的网络类型docker network ls:
搭建canal环境
附上docker的下载安装地址==> docker download 。
下载canal镜像docker pull canal/canal-server:
下载mysql镜像docker pull mysql,下载过的则如下图:

查看已经下载好的镜像docker images:
接下来通过镜像生成mysql容器与canal-server容器:
##生成mysql容器
docker run -d --name mysql --net mynetwork --ip 172.18.0.6 -p 3306:3306 -e mysql_root_password=root mysql
##生成canal-server容器
docker run -d --name canal-server --net mynetwork --ip 172.18.0.4 -p 11111:11111 canal/canal-server
## 命令介绍
--net mynetwork #使用自定义网络
--ip #指定分配ip
查看docker中运行的容器docker ps:
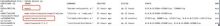
mysql的配置修改
以上只是初步准备好了基础的环境,但是怎么让canal伪装成salve并正确获取mysql中的binary log呢?
对于自建mysql,需要先开启binlog写入功能,配置binlog-format为row模式,通过修改mysql配置文件来开启bin_log,使用find / -name my.cnf查找my.cnf,修改文件内容如下:
[mysqld]
log-bin=mysql-bin # 开启binlog
binlog-format=row # 选择row模式
server_id=1 # 配置mysql replaction需要定义,不要和canal的slaveid重复
进入mysql容器docker exec -it mysql bash。
创建链接mysql的账号canal并授予作为mysql slave的权限,如果已有账户可直接grant:
mysql -uroot -proot
# 创建账号
create user canal identified by 'canal';
# 授予权限
grant select, replication slave, replication client on *.* to 'canal'@'%';
-- grant all privileges on *.* to 'canal'@'%' ;
# 刷新并应用
flush privileges;
数据库重启后,简单测试 my.cnf 配置是否生效:
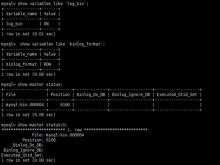
show variables like 'log_bin';
show variables like 'log_bin';
show master status;
canal-server的配置修改
进入canal-server容器docker exec -it canal-server bash。
编辑canal-server的配置vi canal-server/conf/example/instance.properties:
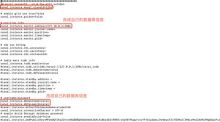
更多配置请参考==>canal配置说明 。

重启canal-server容器docker restart canal-server 进入容器查看启动日志:
docker exec -it canal-server bash
tail -100f canal-server/logs/example/example.log
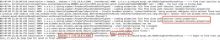
至此,我们的环境工作准备完成!
拉取数据并同步保存到elasticsearch
本文的elasticsearch也是基于docker环境搭建,所以读者可执行如下命令:
# 下载对镜像
docker pull elasticsearch:7.1.1
docker pull mobz/elasticsearch-head:5-alpine
# 创建容器并运行
docker run -d --name elasticsearch --net mynetwork --ip 172.18.0.2 -p 9200:9200 -p 9300:9300 -e "discovery.type=single-node" elasticsearch:7.1.1
docker run -d --name elasticsearch-head --net mynetwork --ip 172.18.0.5 -p 9100:9100 mobz/elasticsearch-head:5-alpine
环境已经准备好了,现在就要开始我们的编码实战部分了,怎么通过应用程序去获取canal解析后的binlog数据。首先我们基于spring boot搭建一个canal demo应用。结构如下图所示:
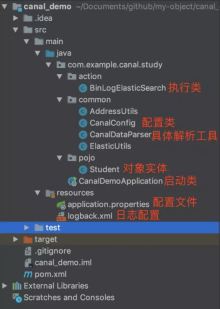
student.java
package com.example.canal.study.pojo;
import lombok.data;
import java.io.serializable;
// @data 用户生产getter、setter方法
@data
public class student implements serializable {
private string id;
private string name;
private int age;
private string sex;
private string city;
}
canalconfig.java
package com.example.canal.study.common;
import com.alibaba.otter.canal.client.canalconnector;
import com.alibaba.otter.canal.client.canalconnectors;
import org.apache.http.httphost;
import org.elasticsearch.client.restclient;
import org.elasticsearch.client.resthighlevelclient;
import org.springframework.beans.factory.annotation.value;
import org.springframework.context.annotation.bean;
import org.springframework.context.annotation.configuration;
import java.net.inetsocketaddress;
/**
* @author haha
*/
@configuration
public class canalconfig {
// @value 获取 application.properties配置中端内容
@value("${canal.server.ip}")
private string canalip;
@value("${canal.server.port}")
private integer canalport;
@value("${canal.destination}")
private string destination;
@value("${elasticsearch.server.ip}")
private string elasticsearchip;
@value("${elasticsearch.server.port}")
private integer elasticsearchport;
@value("${zookeeper.server.ip}")
private string zkserverip;
// 获取简单canal-server连接
@bean
public canalconnector canalsimpleconnector() {
 canalconnector canalconnector = canalconnectors.newsingleconnector(new inetsocketaddress(canalip, canalport), destination, "", "");
 return canalconnector;
}
// 通过连接zookeeper获取canal-server连接
@bean
public canalconnector canalhaconnector() {
 canalconnector canalconnector = canalconnectors.newclusterconnector(zkserverip, destination, "", "");
 return canalconnector;
}
// elasticsearch 7.x客户端
@bean
public resthighlevelclient resthighlevelclient() {
 resthighlevelclient client = new resthighlevelclient(
   restclient.builder(new httphost(elasticsearchip, elasticsearchport))
 );
 return client;
}
}
canaldataparser.java
由于这个类的代码较多,文中则摘出其中比较重要的部分,其它部分代码可从github上获取:
public static class twotuple<a> {
 public final a eventtype;
 public final b columnmap;
 public twotuple(a a, b b) {
  eventtype = a;
  columnmap = b;
 }
}
public static list<twotuple>> printentry(list<entry> entrys) {
 list<twotuple>> rows = new arraylist();
 for (entry entry : entrys) {
  // binlog event的事件事件
  long executetime = entry.getheader().getexecutetime();
  // 当前应用获取到该binlog锁延迟的时间
  long delaytime = system.currenttimemillis() - executetime;
  date date = new date(entry.getheader().getexecutetime());
  simpledateformat simpledateformat = new simpledateformat("yyyy-mm-dd hh:mm:ss");
  // 当前的entry(binary log event)的条目类型属于事务
  if (entry.getentrytype() == entrytype.transactionbegin || entry.getentrytype() == entrytype.transactionend) {
   if (entry.getentrytype() == entrytype.transactionbegin) {
    transactionbegin begin = null;
    try {
     begin = transactionbegin.parsefrom(entry.getstorevalue());
    } catch (invalidprotocolbufferexception e) {
     throw new runtimeexception("parse event has an error , data:" + entry.tostring(), e);
    }
    // 打印事务头信息,执行的线程id,事务耗时
    logger.info(transaction_format,
      new object[]{entry.getheader().getlogfilename(),
        string.valueof(entry.getheader().getlogfileoffset()),
        string.valueof(entry.getheader().getexecutetime()),
        simpledateformat.format(date),
        entry.getheader().getgtid(),
        string.valueof(delaytime)});
    logger.info(" begin ----> thread id: {}", begin.getthreadid());
    printxainfo(begin.getpropslist());
   } else if (entry.getentrytype() == entrytype.transactionend) {
    transactionend end = null;
    try {
     end = transactionend.parsefrom(entry.getstorevalue());
    } catch (invalidprotocolbufferexception e) {
     throw new runtimeexception("parse event has an error , data:" + entry.tostring(), e);
    }
    // 打印事务提交信息,事务id
    logger.info("----------------\n");
    logger.info(" end ----> transaction id: {}", end.gettransactionid());
    printxainfo(end.getpropslist());
    logger.info(transaction_format,
      new object[]{entry.getheader().getlogfilename(),
        string.valueof(entry.getheader().getlogfileoffset()),
        string.valueof(entry.getheader().getexecutetime()), simpledateformat.format(date),
        entry.getheader().getgtid(), string.valueof(delaytime)});
   }
   continue;
  }
  // 当前entry(binary log event)的条目类型属于原始数据
  if (entry.getentrytype() == entrytype.rowdata) {
   rowchange rowchage = null;
   try {
    // 获取储存的内容
    rowchage = rowchange.parsefrom(entry.getstorevalue());
   } catch (exception e) {
    throw new runtimeexception("parse event has an error , data:" + entry.tostring(), e);
   }
   // 获取当前内容的事件类型
   eventtype eventtype = rowchage.geteventtype();
   logger.info(row_format,
     new object[]{entry.getheader().getlogfilename(),
       string.valueof(entry.getheader().getlogfileoffset()), entry.getheader().getschemaname(),
       entry.getheader().gettablename(), eventtype,
       string.valueof(entry.getheader().getexecutetime()), simpledateformat.format(date),
       entry.getheader().getgtid(), string.valueof(delaytime)});
   // 事件类型是query或数据定义语言ddl直接打印sql语句,跳出继续下一次循环
   if (eventtype == eventtype.query || rowchage.getisddl()) {
    logger.info(" sql ----> " + rowchage.getsql() + sep);
    continue;
   }
   printxainfo(rowchage.getpropslist());
   // 循环当前内容条目的具体数据
   for (rowdata rowdata : rowchage.getrowdataslist()) {
    list<canalentry.column> columns;
    // 事件类型是delete返回删除前的列内容,否则返回改变后列的内容
    if (eventtype == canalentry.eventtype.delete) {
     columns = rowdata.getbeforecolumnslist();
    } else {
     columns = rowdata.getaftercolumnslist();
    }
    hashmap<string> map = new hashmap(16);
    // 循环把列的name与value放入map中
    for (column column: columns){
     map.put(column.getname(), column.getvalue());
    }
    rows.add(new twotuple(eventtype, map));
   }
  }
 }
 return rows;
}</string></canalentry.column></twotuple></entry></twotuple></a>
elasticutils.java
package com.example.canal.study.common;
import com.alibaba.fastjson.json;
import com.example.canal.study.pojo.student;
import lombok.extern.slf4j.slf4j;
import org.elasticsearch.client.resthighlevelclient;
import org.springframework.beans.factory.annotation.autowired;
import org.springframework.stereotype.component;
import org.elasticsearch.action.docwriterequest;
import org.elasticsearch.action.delete.deleterequest;
import org.elasticsearch.action.delete.deleteresponse;
import org.elasticsearch.action.get.getrequest;
import org.elasticsearch.action.get.getresponse;
import org.elasticsearch.action.index.indexrequest;
import org.elasticsearch.action.index.indexresponse;
import org.elasticsearch.action.update.updaterequest;
import org.elasticsearch.action.update.updateresponse;
import org.elasticsearch.client.requestoptions;
import org.elasticsearch.common.xcontent.xcontenttype;
import java.io.ioexception;
import java.util.map;
/**
* @author haha
*/
@slf4j
@component
public class elasticutils {
@autowired
private resthighlevelclient resthighlevelclient;
/**
 * 新增
 * @param student
 * @param index 索引
 */
public void savees(student student, string index) {
 indexrequest indexrequest = new indexrequest(index)
   .id(student.getid())
   .source(json.tojsonstring(student), xcontenttype.json)
   .optype(docwriterequest.optype.create);
 try {
  indexresponse response = resthighlevelclient.index(indexrequest, requestoptions.default);
  log.info("保存数据至elasticsearch成功:{}", response.getid());
 } catch (ioexception e) {
  log.error("保存数据至elasticsearch失败: {}", e);
 }
}
/**
 * 查看
 * @param index 索引
 * @param id _id
 * @throws ioexception
 */
public void getes(string index, string id) throws ioexception {
 getrequest getrequest = new getrequest(index, id);
 getresponse response = resthighlevelclient.get(getrequest, requestoptions.default);
 map<string> fields = response.getsource();
 for (map.entry<string> entry : fields.entryset()) {
  system.out.println(entry.getkey() + ":" + entry.getvalue());
 }
}
/**
 * 更新
 * @param student
 * @param index 索引
 * @throws ioexception
 */
public void updatees(student student, string index) throws ioexception {
 updaterequest updaterequest = new updaterequest(index, student.getid());
 updaterequest.upsert(json.tojsonstring(student), xcontenttype.json);
 updateresponse response = resthighlevelclient.update(updaterequest, requestoptions.default);
 log.info("更新数据至elasticsearch成功:{}", response.getid());
}
/**
 * 根据id删除数据
 * @param index 索引
 * @param id _id
 * @throws ioexception
 */
public void deletees(string index, string id) throws ioexception {
 deleterequest deleterequest = new deleterequest(index, id);
 deleteresponse response = resthighlevelclient.delete(deleterequest, requestoptions.default);
 log.info("删除数据至elasticsearch成功:{}", response.getid());
}
}</string></string>
binlogelasticsearch.java
package com.example.canal.study.action;
import com.alibaba.otter.canal.client.canalconnector;
import com.alibaba.otter.canal.protocol.canalentry;
import com.alibaba.otter.canal.protocol.message;
import com.example.canal.study.common.canaldataparser;
import com.example.canal.study.common.elasticutils;
import com.example.canal.study.pojo.student;
import lombok.extern.slf4j.slf4j;
import org.springframework.beans.factory.annotation.autowired;
import org.springframework.beans.factory.annotation.qualifier;
import org.springframework.stereotype.component;
import java.io.ioexception;
import java.util.list;
import java.util.map;
/**
* @author haha
*/
@slf4j
@component
public class binlogelasticsearch {
@autowired
private canalconnector canalsimpleconnector;
@autowired
private elasticutils elasticutils;
//@qualifier("canalhaconnector")使用名为canalhaconnector的bean
@autowired
@qualifier("canalhaconnector")
private canalconnector canalhaconnector;
public void binlogtoelasticsearch() throws ioexception {
 opencanalconnector(canalhaconnector);
 // 轮询拉取数据
 integer batchsize = 5 * 1024;
 while (true) {
  message message = canalhaconnector.getwithoutack(batchsize);
//   message message = canalsimpleconnector.getwithoutack(batchsize);
  long id = message.getid();
  int size = message.getentries().size();
  log.info("当前监控到binlog消息数量{}", size);
  if (id == -1 || size == 0) {
   try {
    // 等待2秒
    thread.sleep(2000);
   } catch (interruptedexception e) {
    e.printstacktrace();
   }
  } else {
   //1. 解析message对象
   list<canalentry.entry> entries = message.getentries();
   list<canaldataparser.twotuple>> rows = canaldataparser.printentry(entries);
   for (canaldataparser.twotuple<canalentry.eventtype> tuple : rows) {
    if(tuple.eventtype == canalentry.eventtype.insert) {
     student student = createstudent(tuple);
     // 2。将解析出的对象同步到elasticsearch中
     elasticutils.savees(student, "student_index");
     // 3.消息确认已处理
//     canalsimpleconnector.ack(id);
     canalhaconnector.ack(id);
    }
    if(tuple.eventtype == canalentry.eventtype.update){
     student student = createstudent(tuple);
     elasticutils.updatees(student, "student_index");
     // 3.消息确认已处理
//     canalsimpleconnector.ack(id);
     canalhaconnector.ack(id);
    }
    if(tuple.eventtype == canalentry.eventtype.delete){
     elasticutils.deletees("student_index", tuple.columnmap.get("id").tostring());
     canalhaconnector.ack(id);
    }
   }
  }
 }
}
/**
 * 封装数据至student
 * @param tuple
 * @return
 */
private student createstudent(canaldataparser.twotuple<canalentry.eventtype> tuple){
 student student = new student();
 student.setid(tuple.columnmap.get("id").tostring());
 student.setage(integer.parseint(tuple.columnmap.get("age").tostring()));
 student.setname(tuple.columnmap.get("name").tostring());
 student.setsex(tuple.columnmap.get("sex").tostring());
 student.setcity(tuple.columnmap.get("city").tostring());
 return student;
}
/**
 * 打开canal连接
 *
 * @param canalconnector
 */
private void opencanalconnector(canalconnector canalconnector) {
 //连接canalserver
 canalconnector.connect();
 // 订阅destination
 canalconnector.subscribe();
}
/**
 * 关闭canal连接
 *
 * @param canalconnector
 */
private void closecanalconnector(canalconnector canalconnector) {
 //关闭连接canalserver
 canalconnector.disconnect();
 // 注销订阅destination
 canalconnector.unsubscribe();
}
}</canalentry.eventtype></canalentry.eventtype></canaldataparser.twotuple></canalentry.entry>
canaldemoapplication.java(spring boot启动类)
package com.example.canal.study;
import com.example.canal.study.action.binlogelasticsearch;
import org.springframework.beans.factory.annotation.autowired;
import org.springframework.boot.applicationarguments;
import org.springframework.boot.applicationrunner;
import org.springframework.boot.springapplication;
import org.springframework.boot.autoconfigure.springbootapplication;
/**
* @author haha
*/
@springbootapplication
public class canaldemoapplication implements applicationrunner {
@autowired
private binlogelasticsearch binlogelasticsearch;
public static void main(string[] args) {
 springapplication.run(canaldemoapplication.class, args);
}
// 程序启动则执行run方法
@override
public void run(applicationarguments args) throws exception {
 binlogelasticsearch.binlogtoelasticsearch();
}
}
application.properties
server.port=8081
spring.application.name = canal-demo
canal.server.ip = 192.168.124124.5
canal.server.port = 11111
canal.destination = example
zookeeper.server.ip = 192.168.124124.5:2181
zookeeper.sasl.client = false
elasticsearch.server.ip = 192.168.124124.5
elasticsearch.server.port = 9200
canal集群高可用的搭建
通过上面的学习,我们知道了单机直连方式的canala应用。在当今互联网时代,单实例模式逐渐被集群高可用模式取代,那么canala的多实例集群方式如何搭建呢!
基于zookeeper获取canal实例
准备zookeeper的docker镜像与容器:
docker pull zookeeper
docker run -d --name zookeeper --net mynetwork --ip 172.18.0.3 -p 2181:2181 zookeeper
docker run -d --name canal-server2 --net mynetwork --ip 172.18.0.8 -p 11113:11113 canal/canal-server
1、机器准备:
运行canal的容器ip: 172.18.0.4 , 172.18.0.8
zookeeper容器ip:172.18.0.3:2181
mysql容器ip:172.18.0.6:3306
2、按照部署和配置,在单台机器上各自完成配置,演示时instance name为example。
3、修改canal.properties,加上zookeeper配置并修改canal端口:
canal.port=11113
canal.zkservers=172.18.0.3:2181
canal.instance.global.spring.xml = classpath:spring/default-instance.xml
4、创建example目录,并修改instance.properties:
canal.instance.mysql.slaveid = 1235
#之前的canal slaveid是1234,保证slaveid不重复即可
canal.instance.master.address = 172.18.0.6:3306
注意: 两台机器上的instance目录的名字需要保证完全一致,ha模式是依赖于instance name进行管理,同时必须都选择default-instance.xml配置。
启动两个不同容器的canal,启动后,可以通过tail -100f logs/example/example.log查看启动日志,只会看到一台机器上出现了启动成功的日志。
比如我这里启动成功的是 172.18.0.4:
查看一下zookeeper中的节点信息,也可以知道当前工作的节点为172.18.0.4:11111:
[zk: localhost:2181(connected) 15] get /otter/canal/destinations/example/running
{"active":true,"address":"172.18.0.4:11111","cid":1}
客户端链接, 消费数据
可以通过指定zookeeper地址和canal的instance name,canal client会自动从zookeeper中的running节点获取当前服务的工作节点,然后与其建立链接:
[zk: localhost:2181(connected) 0] get /otter/canal/destinations/example/running
{"active":true,"address":"172.18.0.4:11111","cid":1}
对应的客户端编码可以使用如下形式,上文中的canalconfig.java中的canalhaconnector就是一个ha连接:
canalconnector connector = canalconnectors.newclusterconnector("172.18.0.3:2181", "example", "", "");
链接成功后,canal server会记录当前正在工作的canal client信息,比如客户端ip,链接的端口信息等(聪明的你,应该也可以发现,canal client也可以支持ha功能):
[zk: localhost:2181(connected) 4] get /otter/canal/destinations/example/1001/running
{"active":true,"address":"192.168.124124.5:59887","clientid":1001}
数据消费成功后,canal server会在zookeeper中记录下当前最后一次消费成功的binlog位点(下次你重启client时,会从这最后一个位点继续进行消费):
[zk: localhost:2181(connected) 5] get /otter/canal/destinations/example/1001/cursor

{"@type":"com.alibaba.otter.canal.protocol.position.logposition","identity":{"slaveid":-1,"sourceaddress":{"address":"mysql.mynetwork","port":3306}},"postion":{"included":false,"journalname":"binlog.000004","position":2169,"timestamp":1562672817000}}
停止正在工作的172.18.0.4的canal server:
docker exec -it canal-server bash
cd canal-server/bin
sh stop.sh
这时172.18.0.8会立马启动example instance,提供新的数据服务:
[zk: localhost:2181(connected) 19] get /otter/canal/destinations/example/running
{"active":true,"address":"172.18.0.8:11111","cid":1}
与此同时,客户端也会随着canal server的切换,通过获取zookeeper中的最新地址,与新的canal server建立链接,继续消费数据,整个过程自动完成。
异常与总结
elasticsearch-head无法访问elasticsearch
es与es-head是两个独立的进程,当es-head访问es服务时,会存在一个跨域问题。所以我们需要修改es的配置文件,增加一些配置项来解决这个问题,如下:
[root@localhost /usr/local/elasticsearch-head-master]# cd ../elasticsearch-5.5.2/config/
[root@localhost /usr/local/elasticsearch-5.5.2/config]# vim elasticsearch.yml
# 文件末尾加上如下配置
http.cors.enabled: true
http.cors.allow-origin: "*"
修改完配置文件后需重启es服务。
elasticsearch-head查询报406 not acceptable
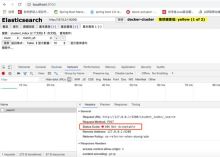
解决方法:
1、进入head安装目录;
2、cd _site/
3、编辑vendor.js 共有两处
#6886行 contenttype: "application/x-www-form-urlencoded
改成 contenttype: "application/json;charset=utf-8"
 #7574行 var inspectdata = s.contenttype === "application/x-www-form-urlencoded" &&
改成 var inspectdata = s.contenttype === "application/json;charset=utf-8" &&
使用elasticsearch-rest-high-level-client报org.elasticsearch.action.index.indexrequest.ifseqno
#pom中除了加入依赖
<dependency><groupid>org.elasticsearch.client</groupid><artifactid>elasticsearch-rest-high-level-client</artifactid><version>7.1.1</version></dependency>
#还需加入
<dependency><groupid>org.elasticsearch</groupid><artifactid>elasticsearch</artifactid><version>7.1.1</version></dependency>
相关参考: 。
为什么elasticsearch要在7.x版本不能使用type?
参考: 为什么elasticsearch要在7.x版本去掉type?
使用spring-data-elasticsearch.jar报org.elasticsearch.client.transport.nonodeavailableexception
由于本文使用的是elasticsearch7.x以上的版本,目前spring-data-elasticsearch底层采用es官方transportclient,而es官方计划放弃transportclient,工具以es官方推荐的resthighlevelclient进行调用请求。 可参考 resthighlevelclient api 。
设置docker容器开启启动
如果创建时未指定 --restart=always ,可通过update 命令
docker update --restart=always [containerid]
docker for mac network host模式不生效
host模式是为了性能,但是这却对docker的隔离性造成了破坏,导致安全性降低。 在性能场景下,可以用--netwokr host开启host模式,但需要注意的是,如果你用windows或mac本地启动容器的话,会遇到host模式失效的问题。原因是host模式只支持linux宿主机。
参见官方文档: 。
客户端连接zookeeper报authenticate using sasl(unknow error)
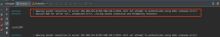
zookeeper.jar与dokcer中的zookeeper版本不一致
zookeeper.jar使用了3.4.6之前的版本
出现这个错的意思是zookeeper作为外部应用需要向系统申请资源,申请资源的时候需要通过认证,而sasl是一种认证方式,我们想办法来绕过sasl认证。避免等待,来提高效率。
在项目代码中加入system.setproperty("zookeeper.sasl.client", "false");,如果是spring boot项目可以在application.properties中加入zookeeper.sasl.client=false。
参考: increased cpu usage by unnecessary sasl checks 。
如果更换canal.client.jar中依赖的zookeeper.jar的版本
把canal的官方源码下载到本机git clone ,然后修改client模块下pom.xml文件中关于zookeeper的内容,然后重新mvn install:
把自己项目依赖的包替换为刚刚mvn install生产的包: