






分治思想算法
fork-join模式是基于分治思想的并行计算模式之一。该模式将一个大的任务分割成多个小的子任务,然后并行执行这些子任务,最后将它们的结果合并起来得到最终的结果。在这个过程中,每个子任务的执行可以进一步分解为更小的子任务,直到达到某个阈值,这时候任务将被串行执行。这种递归的分治思想使得fork-join模式可以有效地利用计算机的多核处理能力,从而提高程序的性能和效率。
归并排序
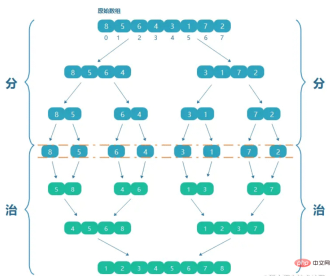
归并排序是一种基于分治思想的排序算法。其核心思想是将一个数组分成两个子数组,分别对其进行排序后再将其合并起来。具体实现过程如下:
分解:将一个数组分成两个子数组,分别对其进行排序。可以使用递归来实现这一步骤。
合并:将排序后的两个子数组合并成一个有序的数组。
递归:对两个子数组递归进行分解和排序,直到每个子数组的长度为1。
时间复杂度为O(nlogn)。
public class Merge {
    public static void main(String[] args) {
        int[] arr = { 5, 2, 8, 4, 7, 1, 3, 6 };
        mergeSort(arr, 0, arr.length - 1);
        System.out.println(Arrays.toString(arr));
    }
    /**
     * 拆分
     * @param arr 数组
     * @param left 数组第一个元素
     * @param right 数组最后一个元素
     */
    public static void mergeSort(int[] arr,int left,int right){
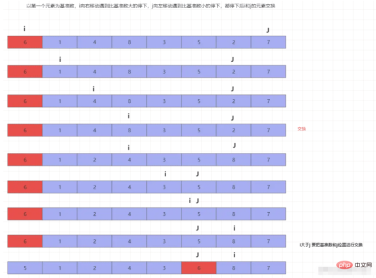
        if (left <h4>快速排序</h4><p>快速排序(Quick Sort)是一种基于分治思想的排序算法,它采用了递归的方式将一个大的数组分解成多个子数组,分别进行排序后再将它们合并起来。其基本思想是选取一个基准元素,将数组中小于该元素的值放在左边,大于该元素的值放在右边,然后递归地对左右两个子数组进行排序。具体的步骤如下:</p>
选取一个基准元素(通常是数组中的第一个元素)。
将数组中小于该元素的值放在左边,大于该元素的值放在右边。
对左右两个子数组分别递归进行快速排序。
-
合并左右两个已排序的子数组。
 FilePond 灵活的 JavaScript 文件上传库下载
FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
快速排序的时间复杂度为O(nlogn),它是一种原地排序算法,不需要额外的存储空间,因此空间复杂度为O(1)。虽然快速排序的最坏时间复杂度为O(n^2),但是在实际应用中,快速排序的平均时间复杂度和最好时间复杂度均为O(nlogn),因此是一种非常高效的排序算法
public class QuickSort {
    public static void main(String[] args) {
        int[] arr = { 5, 2, 8, 4, 7, 1, 3, 6 };
        quickSort(arr, 0, arr.length - 1);
        System.out.println(Arrays.toString(arr));
    }
    public static void quickSort(int[] arr,int left,int right){
        if(left<right> pivot){
                j--;
            }
            if(i<j><h3>Fork/Join</h3>
<p>Fork/Join框架的主要组成部分是ForkJoinPool、ForkJoinTask。ForkJoinPool是一个线程池,它用于管理ForkJoin任务的执行。ForkJoinTask是一个抽象类,用于表示可以被分割成更小部分的任务。</p>
<h4>ForkJoinPool</h4>
<p>ForkJoinPool是Fork/Join框架中的线程池类,它用于管理Fork/Join任务的线程。ForkJoinPool类包括一些重要的方法,例如submit()、invoke()、shutdown()、awaitTermination()等,用于提交任务、执行任务、关闭线程池和等待任务的执行结果。ForkJoinPool类中还包括一些参数,例如线程池的大小、工作线程的优先级、任务队列的容量等,可以根据具体的应用场景进行设置。</p>
<h5>构造器</h5>
<p>ForkJoinPool中有四个核心参数,用于控制线程池的并行数、工作线程的创建、异常处理和模式指定等。</p>
<ul class=" list-paddingleft-2">
<li><p>int parallelism:指定并行级别(parallelism level)。ForkJoinPool将根据这个设定,决定工作线程的数量。如果未设置的话,将使用Runtime.getRuntime().availableProcessors()来设置并行级别;</p></li>
<li><p>ForkJoinWorkerThreadFactory factory:ForkJoinPool在创建线程时,会通过factory来创建。注意,这里需要实现的是ForkJoinWorkerThreadFactory,而不是ThreadFactory。如果你不指定factory,那么将由默认的 DefaultForkJoinWorkerThreadFactory负责线程的创建工作;</p></li>
<li><p>UncaughtExceptionHandler handler:指定异常处理器,当任务在运行中出错时,将由设定的处理器处理;</p></li>
<li><p>boolean asyncMode:设置队列的工作模式。当asyncMode为true时,将使用先进先出队列,而为false时则使用后进先出的模式。</p></li>
</ul>
<h4>工作窃取法</h4>
<p>在Fork-Join模式中,任务被分配给一个线程池中的工作线程来执行。当一个工作线程执行完自己分配的任务后,它可以从其他工作线程的任务队列中偷取(Steal)任务来执行,这就是所谓的工作窃取(Work Stealing)。</p>
<h5>使用</h5>
<pre class="brush:java;">public class SumTask extends RecursiveTask<integer> {
    private static final int THRESHOLD = 1000;
    private int[] array;
    private int start;
    private int end;
    public SumTask(int[] array, int start, int end) {
        this.array = array;
        this.start = start;
        this.end = end;
    }
    @Override
    protected Integer compute() {
        if (end - start </integer>
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南














