






用python处理文本数据
实验目的
熟悉python的基本数据结构,以及文件的输入与输出。
实验数据

当现有的脚本或服务需要将作用域化的仓库工作委托给 Claude Code 并以编程方式消费结构化响应时,请使用 Claude Agent SDK for Python。
利用xxxx年xx机器学习会议的评测数据和评测任务,数据包括训练集和测试集,评测任务为通过给定的训练数据,预测测试集中的关系是正例还是负例,在每个样本最后给出1或者0。
数据描述如下,第一列为关系类型,第二列和第三列为人名,第四列是标题,第五列是关系为正例还是负例,1为正例,0为负例;第六列表示训练集。
| 事件 | 人物1 | 人物2 | 标题 | 关系(0 or 1) | 训练集 |
|---|
测试集描述如下图,格式基本与训练集类似,唯一不同的是第五列没有关系是正例还是负例的标记。
| 关系 | 人物1 | 人物2 | 事件 |
|---|
实验内容
对训练集数据进行处理,只留下前面五列,输出文本命名为exp1_1.txt。
在第一步得到的数据的基础上对19类关系进行分类,生成的文本存放在exp1_train文件夹下,按照关系类别出现的顺序,第一个关系类别的数据存放在1.txt中,第二个关系类别存放在2.txt中,直到19.txt。
测试集按照训练集的19个类别的顺序将各个样本按照关系类别归类,即相同关系类型的数据放到一个文本文件中,同样生成19个类别的测试文件,格式仍旧和测试文件保持一致。存放在exp1_test文件夹下,每个类别的文件仍旧命名为1_test.txt,2_test.txt…同时对每个样本在原测试集中出现的位置进行记录,和19个测试文件一一对应起来。比如第一类“传闻不和”的每个样本在原文中处于第几行,在索引文件中进行记录,保存在文件index1.txt,index2.txt….
解题思路
1.第一题是考察我们文件操作与列表的知识,主要考察的难点是对new文件的读取,根据要求处理后在生成一个txt文件,让我们看一下具体的代码实现:
import os
# 创建一个列表用来存储新的内容
list = []
with open("task1.trainSentence.new", "r",encoding='xxx') as file_input: # 打开.new文件,xxx根据自己的编码格式填写
    with open("exp1_1.txt", "w", encoding='xxx') as file_output:        # 打开exp1_1.txt,xxx根据自己的编码格式填写文件如果没有就创建一个

        for Line in file_input:                                         # 遍历每一行的文件
            arr = Line.split('\t')                                      # 以\t为分隔符读取
            if arr[0] not in list:                                      # if the word is not in the list
                list.append(arr[0])                                     # add the word to the list
            file_output.write(arr[0]+"\t"+arr[1]+"\t"+arr[2]+"\t"+arr[3]+"\t"+arr[4]+"\n")  # write the line to the file
file_input.close()                                                      #关闭.new文件
file_output.close()                                                     #关闭创建的txt文件
2.第二题依旧考察了文件操作,在题目一生成的文件基础上,按照同一类型的事件对事件进行分类,是否能高效的分组需要利用循环条件来解决,我们来看看具体的
代码实现
import os
file_1 = open("exp1_1.txt", encoding='xxx')             # 打开文件,xxx根据自己的编码格式填写
os.mkdir("exp1_train")                                  # 创建目录
os.chdir("exp1_train")                                  # 修改进程的工作目录(使用该目录)
a = file.readline()                                     # 按行读取exp1_1.txt文件
arr = a.split("\t")                                     # 按\t间隔符作为分割
b = 1                                                   #设置分组文件的序列
file_2 = open("{}.txt".format(b), "w", encoding="xxx")  # 打开文件,xxx根据自己的编码格式填写
for line in file_1:                                     # 按行读取文件
    arr_1 = line.split("\t")                            # 按\t间隔符作为分割
    if arr[0] != arr_1[0]:                              # 如果读取文件的第一列内容与存入新文件的第一列类型不同
        file_2.close()                                  # 关掉该文件
        b += 1                                          # 文件序列加一
        f_2 = open("{}.txt".format(b), "w", encoding="xxx") # 创建新文件,以另一种类型分类,xxx根据自己的编码格式填写
    arr = line.split("\t")                              # 按\t间隔符作为分割
    f_2.write(arr[0]+"\t"+arr[1]+"\t"+arr[2]+"\t"+arr[3]+"t"+arr[4]+"\t""\n") # 将相同类型的文件写入
f_1.close()                                             # 关闭题目一创建的exp1_1.txt文件
f_2.close()                                             # 关闭创建的最后一个类型的文件
3.将训练集的19个类别按照人物的关系进行进一步的分类,我们可以通过字典对数据进行遍历,查找关系,把关系相同的内容放到一个文件夹中,不同则新建一个。
import os

with open("exp1_1.txt", encoding='xxx') as file_in1: # 打开文件,xxx根据自己的编码格式填写
    i = 1                                            # 类型序列
    arr2 = {}                                        # 创建字典
    for line in file_in1:                            # 按行遍历
        arr3 = line[0:2]                             # 读取关系
        if arr3 not in arr2.keys():
            arr2[arr3] = i
            i += 1                                   # 类型+1
    file_in = open("task1.test.new")                 # 打开文件task1.test.new
    os.mkdir("exp1_test")                            # 创建目录
    os.chdir("exp1_test")                            # 修改进程的工作目录(使用该目录)
    for line in file_in:
        arr = line[0:2]
        with open("{}_test.txt".format(arr2[arr]), "a", encoding='xxx') as file_out:
            arr = line.split('\t')
            file_out.write(line)
    i = 1
    file_in.seek(0)
    os.mkdir("exp1_index")
    os.chdir("exp1_index")
    for line in file_in:
        arr = line[0:2]
        with open("index{}.txt".format(arr2[arr]), "a", encoding='xxx') as file_out:
            arr = line.split('\t')
            line = line[0:-1]
            file_out.write(line + '\t' + "{}".format(i) + "\n")
        i += 1
用python处理数值型数据
实验目的
熟悉python的基本数据结构,以及文件的输入与输出。
实验数据
xxxx年xx天池大赛,也是中国高校第x届大数据挑战赛的数据。数据包括两个表,分别是用户行为表mars_tianchi_user_actions.csv和歌曲艺人表mars_tianchi_songs.csv。大赛开放抽样的歌曲艺人数据,以及和这些艺人相关的6个月内(20150301-20150831)的用户行为历史记录。选手需要预测艺人随后2个月,即60天(20150901-20151030)的播放数据。
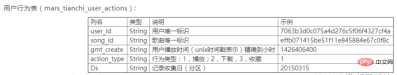
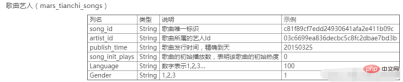
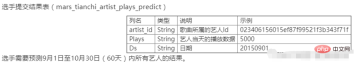
实验内容
对歌曲艺人数据mars_tianchi_songs进行处理,统计出艺人的个数以及每个艺人的歌曲数量。输出文件格式为exp2_1.csv,第一列为艺人的ID,第二列为该艺人的歌曲数目。最后一行输出艺人的个数。
将用户行为表和歌曲艺人表以歌曲song_id作为关联,合并为一个大表。各列名称为第一到第五列与用户行为表的列名一致,第六到第十列为歌曲艺人表中的第二列到第六列的列名。输出文件名为exp2_2.csv。
按照艺人统计每个艺人每天所有歌曲的播放量,输出文件为exp2_3.csv,各个列名为艺人id,日期Ds,歌曲播放总量。注意:这里只统计歌曲的播放量,不包括下载和收藏的数量。
解题思路:(利用pandas库)
1.
(1)利用.drop_duplicates() 删除重复值
(2)利用.loc[:,‘artist_id’].value_counts() 求出歌手重复次数,即每个歌手的歌曲数目
(3)利用.loc[:,‘songs_id’].value_counts() 求出歌曲没有重复
import pandas as pd
data = pd.read_csv(r"C:\mars_tianchi_songs.csv")       # 读取数据
Newdata = data.drop_duplicates(subset=['artist_id'])   # 删除重复值
artist_sum = Newdata['artist_id'].count()
#artistChongFu_count = data.duplicated(subset=['artist_id']).count() artistChongFu_count = data.loc[:,'artist_id'].value_counts() 重复次数,即每个歌手的歌曲数目
songChongFu_count = data.loc[:,'songs_id'].value_counts()  # 没有重复(歌手)
artistChongFu_count.loc['artist_sum'] = artist_sum         # 没有重复(歌曲)artistChongFu_count.to_csv('exp2_1.csv')                   # 输出文件格式为exp2_1.csv
利用merge()合并两个表
import pandas as pd import os

data = pd.read_csv(r"C:\mars_tianchi_songs.csv")
data_two = pd.read_csv(r"C:\mars_tianchi_user_actions.csv")
num=pd.merge(data_two, data) num.to_csv('exp2_2.csv')
利用groupby()[].sum()进行重复性相加
import pandas as pd
data =pd.read_csv('exp2_2.csv')
DataCHongfu = data.groupby(['artist_id','Ds'])['gmt_create'].sum()#重复项相加DataCHongfu.to_csv('exp2_3.csv')
Python免费学习笔记(深入):立即使用
在学习笔记中,你将探索 Python 的核心概念和高级技巧!







