随着stable diffusion的开源,用自然语言进行图像生成也逐渐普及,许多aigc的问题也暴露了出来,比如ai不会画手、无法理解动作关系、很难控制物体的位置等。
其主要原因还是在于「输入接口」只有自然语言,无法做到对画面的精细控制。
最近来自威斯康星大学麦迪逊分校、哥伦比亚大学和微软的研究热源提出了一个全新的方法GLIGEN,以grounding输入为条件,对现有「预训练文本到图像扩散模型」的功能进行扩展。

论文链接:https://arxiv.org/pdf/2301.07093.pdf
项目主页:https://gligen.github.io/
体验链接:https://huggingface.co/spaces/gligen/demo
为了保留预训练模型的大量概念知识,研究人员没有选择对模型进行微调,而是通过门控机制将输入的不同grounding条件注入到新的可训练层中,以实现对开放世界图像生成的控制。
目前GLIGEN支持四种输入。

(左上)文本实体+box (右上)图像实体+box
(左下)图像风格+文本+box (右下)文本实体+关键点
实验结果也显示,GLIGEN 在 COCO 和 LVIS 上的zero-shot性能大大优于目前有监督layout-to-image基线。
可控图像生成
在扩散模型之前,生成对抗网络(GANs)一直是图像生成领域的一哥,其潜空间和条件输入在「可控操作」和「生成」方面得到了充分的研究。
文本条件自回归和扩散模型表现出惊人的图像质量和概念覆盖率,得益于其更稳定的学习目标和对网络图像-文本配对数据的大规模训练,并迅速出圈,成为辅助艺术设计和创作的工具。
但现有的大规模文本-图像生成模型不能以「文本之外」的其他输入模式为条件,缺乏精确定位概念或使用参考图像来控制生成过程的能力,限制了信息的表达。
比如说,使用文本很难描述一个物体的精确位置,而边界框(bounding
boxes)或关键点(keypoints)则可以很容易实现。
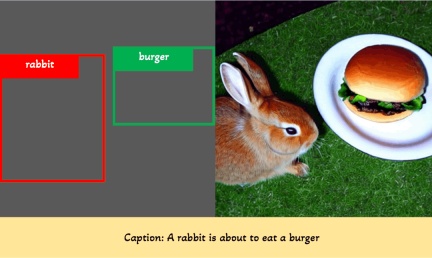
现有的一些工具如inpainting, layout2img生成等可以利用除文本以外的模态输入,但却很少将这些输入结合起来用于可控的text2img生成。
此外,先前的生成模型通常是在特定任务的数据集上独立训练的,而在图像识别领域,长期以来的范式是通过从「大规模图像数据」或「图像-文本对」上预训练的基础模型开始建立特定任务的模型。
扩散模型已经在数十亿的图像-文本对上进行了训练,一个很自然的问题是:我们能否在现有的预训练的扩散模型的基础上,赋予它们新的条件输入模式?
由于预训练模型所具有的大量概念知识,可能能够在其他生成任务上取得更好的性能,同时获得比现有文本-图像生成模型更多的可控性。
GLIGEN
基于上述目的和想法,研究人员提出的GLIGEN模型仍然保留文本标题作为输入,但也启用了其他输入模态,如grounding概念的边界框、grounding参考图像和grounding部分的关键点。
这里面的关键难题是在学习注入新的grounding信息的同时,还保留预训练模型中原有的大量概念知识。
为了防止知识遗忘,研究人员提出冻结原来的模型权重,并增加新的可训练的门控Transformer层以吸收新的grouding输入,下面以边界框为例。
指令输入
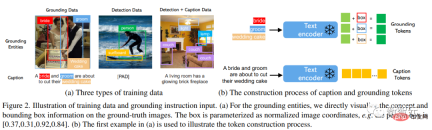
每个grouding文本实体都被表示为一个边界框,包含左上角和右下角的坐标值。
需要注意的是,现有的layout2img相关工作通常需要一个概念词典,在评估阶段只能处理close-set的实体(如COCO类别),研究人员发现使用编码图像描述的文本编码器即可将训练集中的定位信息泛化到其他概念上。
训练数据
用于生成grounding图像的训练数据需要文本c和grounding实体e作为条件,在实践中可以通过考虑更灵活的输入来放松对数据的要求。
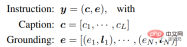
主要有三种类型的数据

1. grounding数据
每张图片都与描述整张图片的标题相关联;名词实体从标题中提取,并标上边界框。
由于名词实体直接取自自然语言的标题,它们可以涵盖更丰富的词汇,有利于开放世界词汇的grounding生成。
2. 检测数据 Detection data
名词实体是预先定义的close-set类别(例如COCO中的80个物体类别),选择使用classifier-free引导中的空标题token作为标题。
检测数据的数量(百万级)大于基础数据(千级),因此可以大大增加总体训练数据。
3. 检测和标题数据 Detection and Caption data
名词实体与检测数据中的名词实体相同,而图像是单独用文字标题描述的,可能存在名词实体与标题中的实体不完全一致的情况。
比如标题只给出了对客厅的高层次描述,没有提到场景中的物体,而检测标注则提供了更精细的物体层次的细节。
门控注意力机制
研究人员的目标是为现有的大型语言-图像生成模型赋予新的空间基础能力,
大型扩散模型已经在网络规模的图像文本上进行了预训练,以获得基于多样化和复杂的语言指令合成现实图像所需的知识,由于预训练的成本很高,性能也很好,在扩展新能力的同时,在模型权重中保留这些知识是很重要的,可以通过调整新的模块来逐步适应新能力。
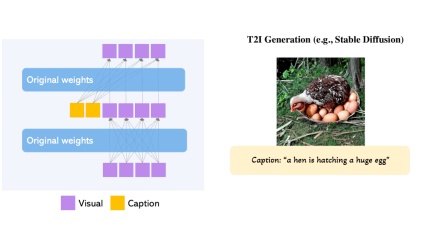
在训练过程中,使用门控机制逐渐将新的grounding信息融合到预训练的模型中,这种设计使生成过程中的采样过程具有灵活性,以提高质量和可控性。
实验中也证明了,在采样步骤的前半部分使用完整的模型(所有层),在后半部分只使用原始层(没有门控Transformer层),生成的结果能够更准确反映grounding条件,同时具有较高的图像质量。
实验部分
在开放集合grounded文本到图像生成任务中,首先只用COCO(COCO2014CD)的基础标注进行训练,并评估GLIGEN是否能生成COCO类别以外的基础实体。

可以看到,GLIGEN可以学会新的概念如「蓝鸦」、「羊角面包」,或新的物体属性如「棕色木桌」,而这些信息没有出现在训练类别中。
研究人员认为这是因为GLIGEN的门控自注意力学会了为接下来的交叉注意力层重新定位与标题中的接地实体相对应的视觉特征,并且由于这两层中的共享文本空间而获得了泛化能力。
实验中还定量评估了该模型在LVIS上的zero-shot生成性能,该模型包含1203个长尾物体类别。使用GLIP从生成的图像中预测边界框并计算AP,并将其命名为GLIP得分;将其与为layout2img任务设计的最先进的模型进行比较,
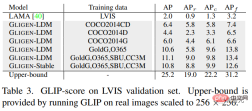
可以发现,尽管GLIGEN模型只在COCO标注上进行了训练,但它比有监督的基线要好得多,可能因为从头开始训练的基线很难从有限的标注中学习,而GLIGEN模型可以利用预训练模型的大量概念知识。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
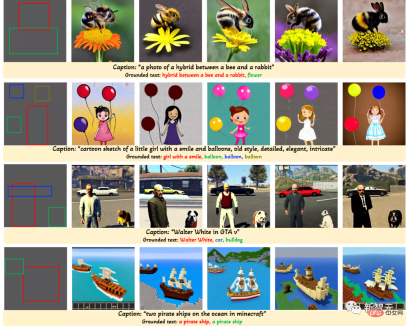
总的来说,这篇论文:
1. 提出了一种新的text2img生成方法,赋予了现有text2img扩散模型新的grounding可控性;
2. 通过保留预训练的权重和学习逐渐整合新的定位层,该模型实现了开放世界的grounded text2img生成与边界框输入,即综合了训练中未观察到的新的定位概念;
3. 该模型在layout2img任务上的zero-shot性能明显优于之前的最先进水平,证明了大型预训练生成模型可以提高下游任务的性能