





视觉基础模型近两年取得了瞩目发展。从一方面而言,基于大规模互联网数据的预训练已经给模型预置了大量的语义概念,从而具有良好的泛化性能;但另一方面,为充分利用大规模数据集带来的模型尺寸增长,使得相关模型在迁移到下游任务时面临着低效率问题,尤其是对于需要处理多帧的视频理解模型。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
- 论文链接:https://arxiv.org/abs/2208.03550
- 代码链接:https://github.com/OpenGVLab/efficient-video-recognition
基于上述两方面特点,来自香港中文大学、上海人工智能实验室等机构的研究者提出了高效的视频理解迁移学习框架 EVL,通过固定骨干基础模型的权重,节省了训练计算量和内存消耗;同时通过利用多层次、细粒度的中间特征,尽可能保持了传统端到端微调的灵活性。
下图 1 展示了 EVL 方法在视频理解数据集 Kinetics-400 上的结果。实验显示,本文方法在节省训练开销的同时,仍然充分发掘了视觉基础模型在视频理解任务中的潜力。
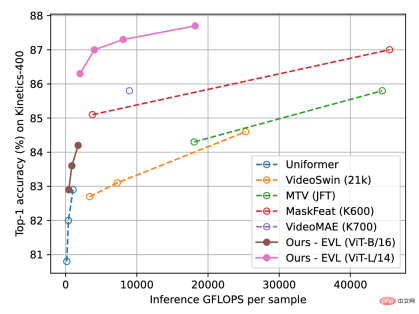
图 1:Kinetics-400 识别精度比较,横轴为推理计算量,纵轴为精度。
方法
算法的总体示意图如图 2(a)所示。对于一个视频样本,我们取其中的 T 帧输入一个图像识别网络(以 CLIP 为例)并提取特征。与传统方法相比,我们从图像识别网络的最后几层中提取多层、未池化的特征,从而获取更丰富、更细粒度的图像信息;并且图像识别网络的参数权重在视频学习中始终保持固定。随后,多层特征图依次输入一个 Transformer 解码器进行视频级信息聚合。经多层解码后的 [CLS] 特征将用于生成最终的分类预测。
如图 2(b)所示,由于 Transformer 解码器聚合特征时的无序性,我们在网络中添加了额外的时序信息建模模块,以更好地提取位置有关的细粒度时序信息。具体而言,我们添加 3 种额外的位置有关时序信息:第一是时间位置嵌入(Position Embeddings),第二是时间维度深度可分卷积(Depthwise Convolution),第三是相邻帧间的注意力信息。对于帧间注意力信息,我们从图像识别网络中提取对应层的 Query 和 Key 特征,并在相邻帧之间计算注意力图(不同于图像识别网络中,注意力图是由来自同一帧内的 Query 和 Key 特征得到)。所得的注意力图能显式地反映出相邻帧之间物体的位置变化。注意力图经过线性投影后得到反应物体位移特征的向量组,并以逐元素相加的形式融合入图像特征中。
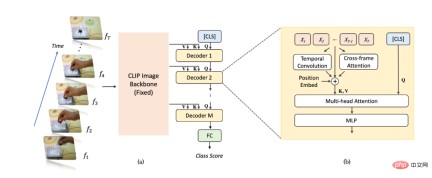
图 2:EVL 算法结构图。(a)总体结构,(b)时序信息建模模块。

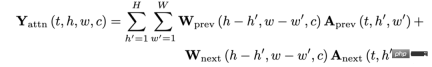
图 3:帧间注意力特征的数学表达。
实验
在图 1 和表 1 中,我们引用了之前视频理解中的部分重要方法。尽管着力于减小训练开销,我们的方法仍然能在精度方面领先于现有方法(相同计算量下)。
表 2 中我们展示了固定骨干网络带来的训练开销降低。内存方面,在 V100 16GB GPU 上,固定骨干网络可以使单卡 batch size 最高达到 64,而端到端训练则只能达到 8;时间方面,固定骨干网络可以节省 3 至 4 倍的训练时间。
表 3 中我们展示了细粒度特征图对识别性能的提升。多层的未经池化特征使得我们在固定骨干网络权值时仍然能保持相当程度的灵活性。使用未经池化的特征带来的提升最为显著(大约 3%),其次,使用多层解码器和中间层特征也能分别带来大约 1% 的性能提升。
最后我们在表 4 中展示了细粒度时序信息模块的效果。尽管细粒度时序信息对 Kinetics-400 的性能影响有限,但它们对于 Something-Something-v2 的性能十分重要:3 种细粒度时序信息模块在 Kinetics-400 和 Something-Something-v2 上分别合计带来大约 0.5% 和大约 14% 的性能提升。
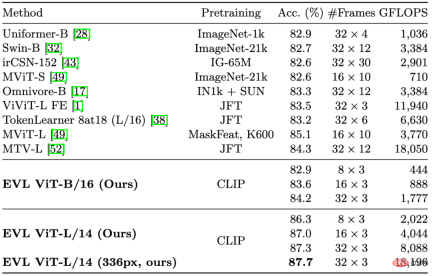
表 1:Kinetics-400 上与现有方法的对比结果
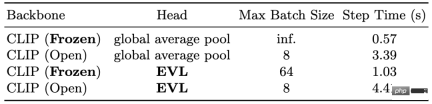
表 2:固定骨干网络权重带来的训练开销降低

表 3:细粒度特征图对精度的影响
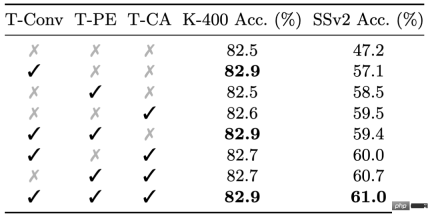
表 4:细粒度时序信息建模在不同数据集上的效果
总结
本文提出了 EVL 视频理解学习框架,首次展示了固定的图像骨干网络在视频理解问题上的巨大潜力,也使得高性能的视频理解对于计算资源有限的研究群体更加友好。我们也相信随着视觉基础模型在质量及规模上的提升,我们的方法能为后续的轻量级迁移学习算法研究提供参考。





