本篇文章带大家了解一下node中的异步实现与事件驱动,希望对大家有所帮助!
Node的特点
计算机中的一些任务一般可以划分为两个类别,一个类别叫做IO密集型,一个叫做计算密集型;对于计算密集型的任务,只能不断榨干CPU的性能,但是对于IO密集型的任务来说,理想情况下却并不需要,只需要通知IO设备进行处理,过一段时间再来拿去数据就好了。【相关教程推荐:nodejs视频教程 、编程视频】
对于某些场景有一些互不相关的任务需要完成,现行的主流方法有如下两种:
- 多线程并行完成:多线程的代价在于创建线程和执行线程上下文切换的开销较大。另外,在复杂的业务中,多线程编程经常面临锁、状态同步等问题;
- 单线程顺序执行:易于表达,但串行执行的缺点在于性能,任意一个略慢的任务都会导致后续代码被组设
node在两者之前给出了它的方案:利用单线程,远离多线程死锁、状态同步等问题;利用异步IO,让单线程远离阻塞,以更好地使用CPU
Node是如何实现异步的
刚才讲了
node在多任务处理的方案,但是node内部想要实现却并不容易,下面介绍操作系统的几个概念,方面后续大家更好理解,后面再讲一讲异步的实现以及node的事件循环机制:
阻塞IO与非阻塞IO
- 阻塞IO:应用层面发起IO调用之后,就一直等待数据,等操作系统内核层面完成所有操作后,调用才结束;
操作系统中一切皆文件,输入输出设备同样被抽象为了文件,内核在执行IO操作时,通过文件描述符进行管理
- 非阻塞IO:差别为调用后立即返回一个文件描述符,并不等待,这时候CPU的时间片就可以用来处理其他事务,之后可以通过这个文件描述符进行结果的获取;
非阻塞IO存在的一些问题:虽然其让CPU的利用率提高了,但是由于立即返回的是一个文件描述符,我们并不知道IO操作什么时候完成,为了确认状态变更,我们只能作轮询操作
不同的轮询方法
-
read:最原始、性能最低的一种,通过重复检查IO状态来完成完整数据的获取 -
select:通过对文件描述符上的事件状态来进行判断,相对来说消耗更少;缺点就是它采用了一个1024长度的数组来存储状态,所以它最多可以同时检查1024个文件描述符 -
poll:由于select的限制,poll改进为链表的存储方式,其他的基本都一致;但是当文件描述符较多的时候,它的性能还是非常低下的 -
eopll:该方案是linux下效率最高的IO事件通知机制,在进入轮询的时候如果没有检查IO事件,将会进行休眠,直到事件发生将它唤醒 -
kqueue:与epoll类似,不过仅在FreeBSD系统下存在
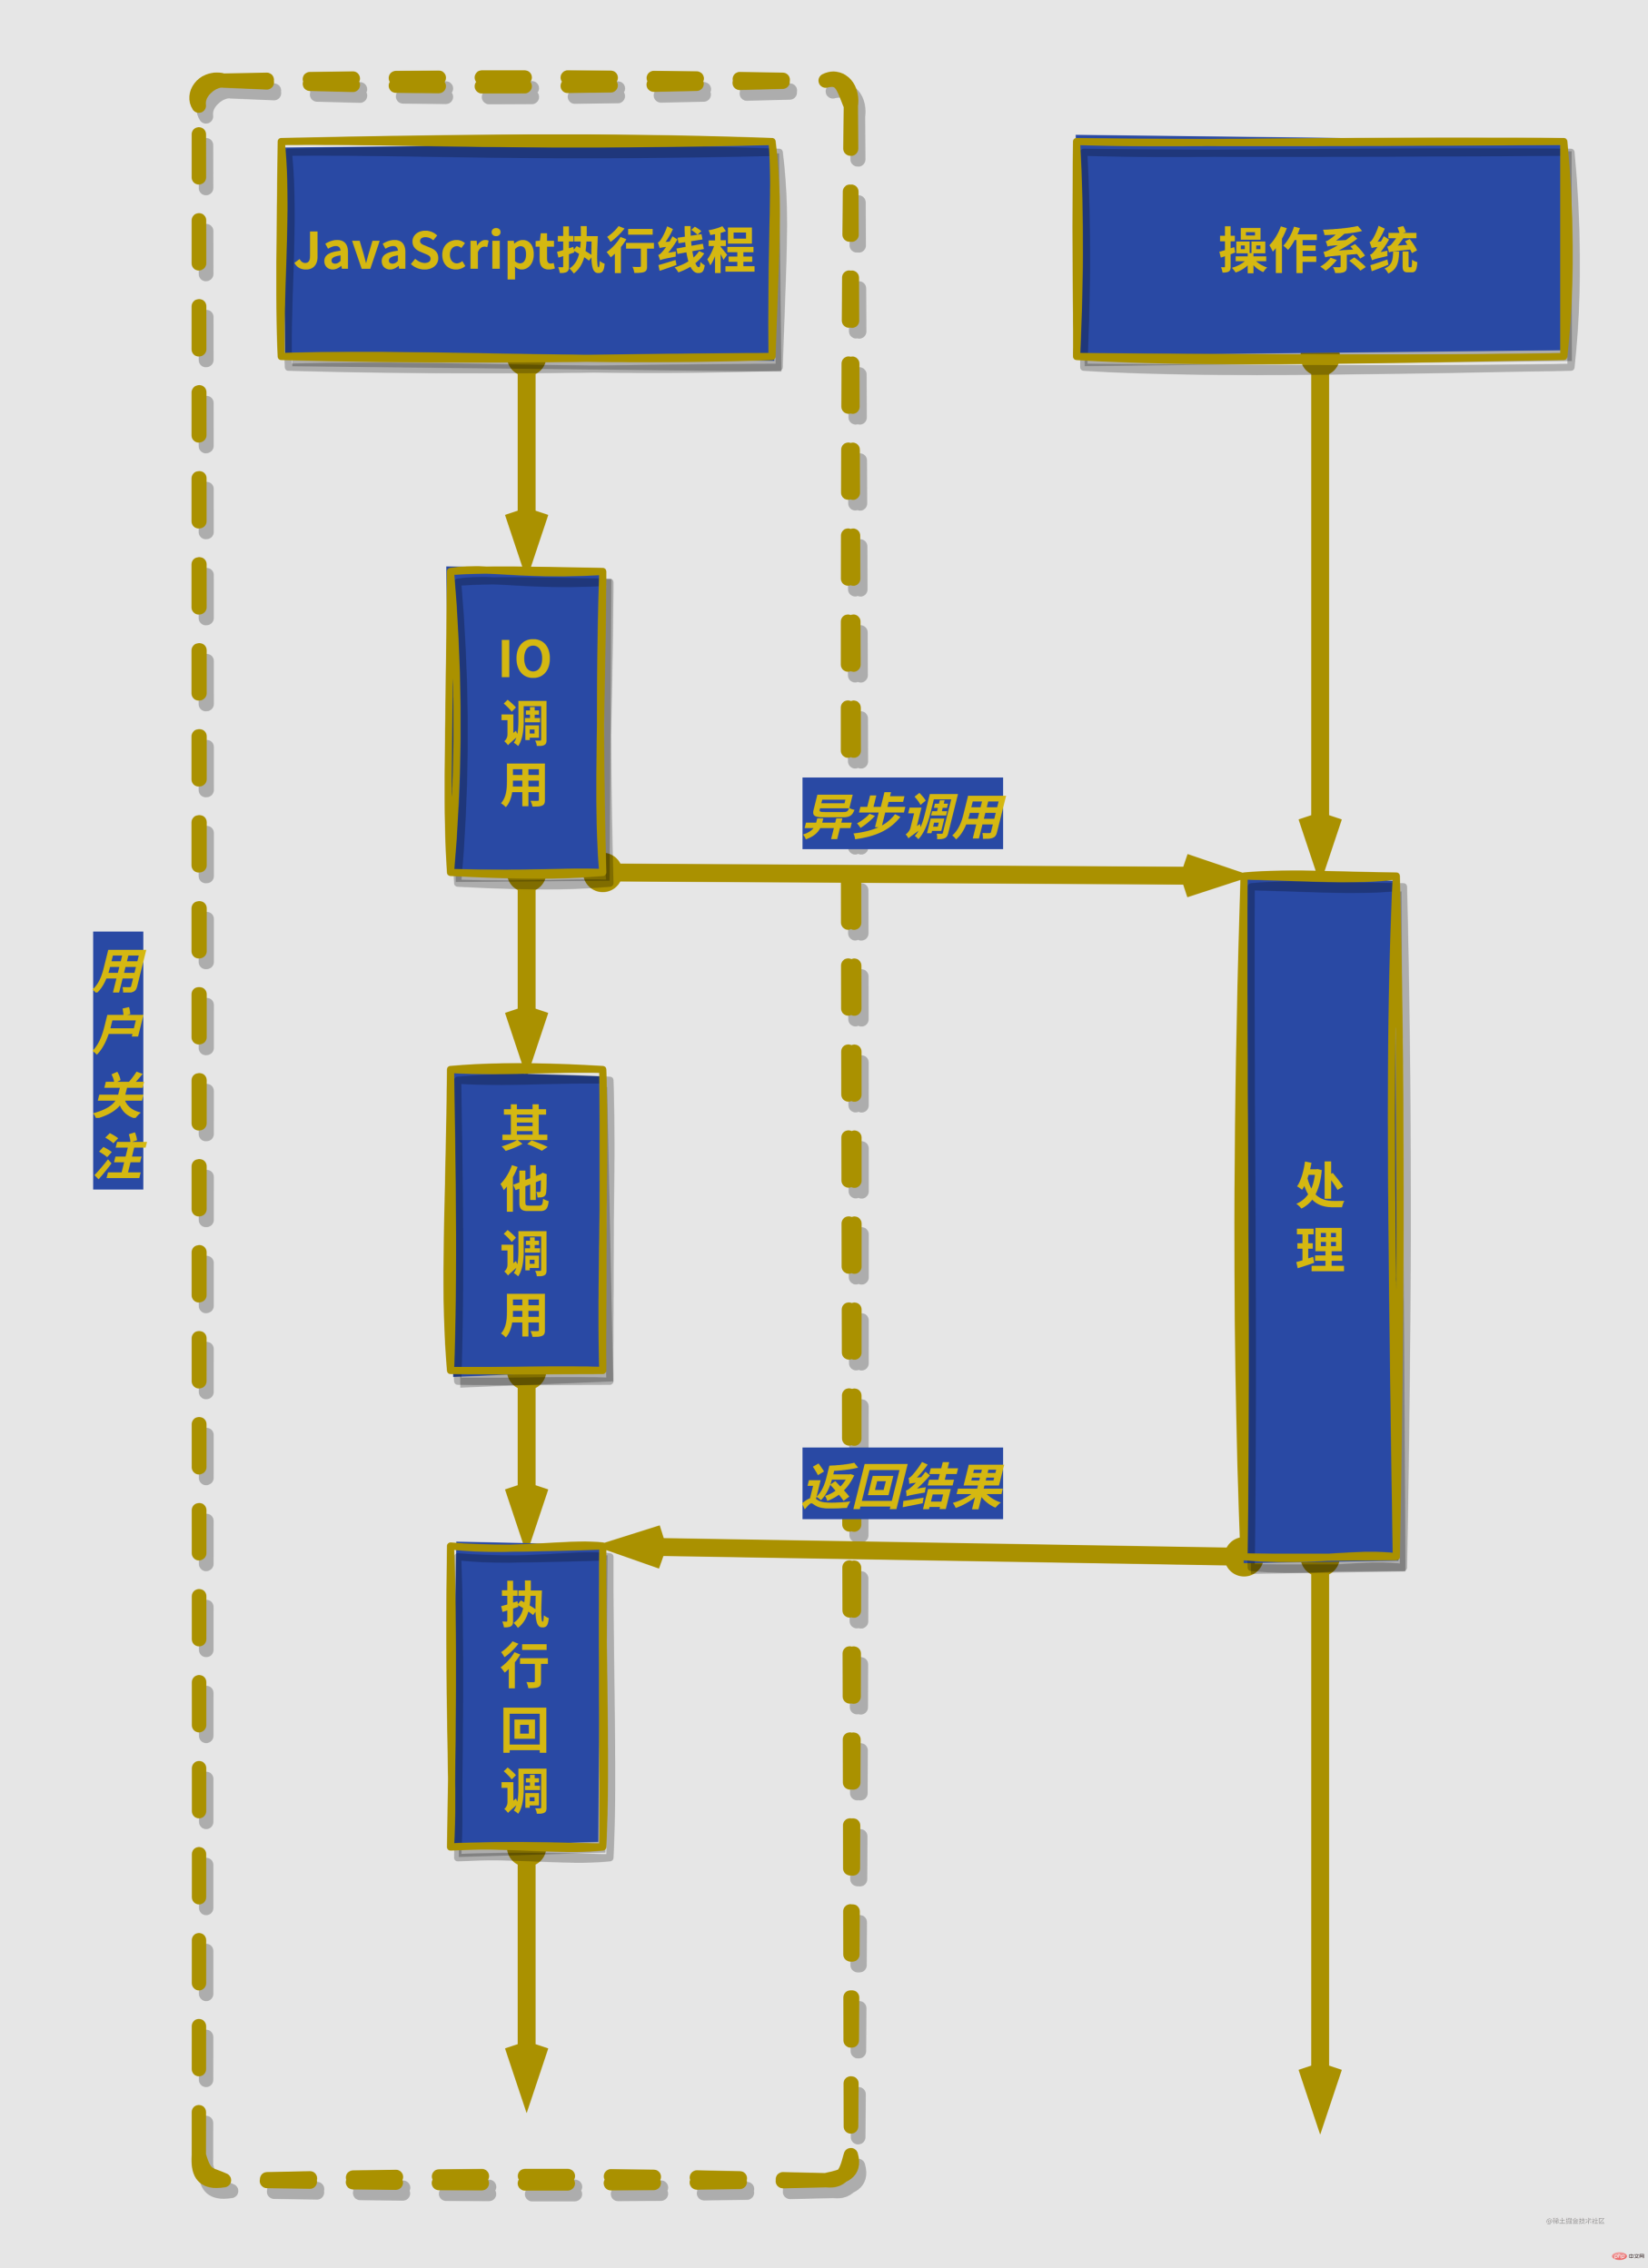
尽管epoll利用了事件来降低对CPU的耗用,但休眠期间CPU几乎是闲置的;我们期待的异步IO应该是应用程序发起非阻塞调用,无须通过遍历或事件唤醒等方式轮询,可以直接处理下一个任务,只需IO完成后通过信号或者回调将数据传递给应用程序即可。
linux下还有中AIO方式就是通过信号或回调来传递数据的,不过只有Linux有,并且有限制无法利用系统缓存
node中对于异步IO的实现
先说结论,node对异步IO的实现是通过多线程实现的。可能会混淆的地方就是node内部虽然是多线程的,但是我们程序员开发的JavaScript代码却仅仅是运行在单线程上的。
node通过部分线程进行阻塞IO或者非阻塞IO加上轮询技术来完成数据获取,让一个线程进行计算处理,通过线程之间的通信将IO得到的数据进行传递,这就轻松实现了异步IO的模拟。
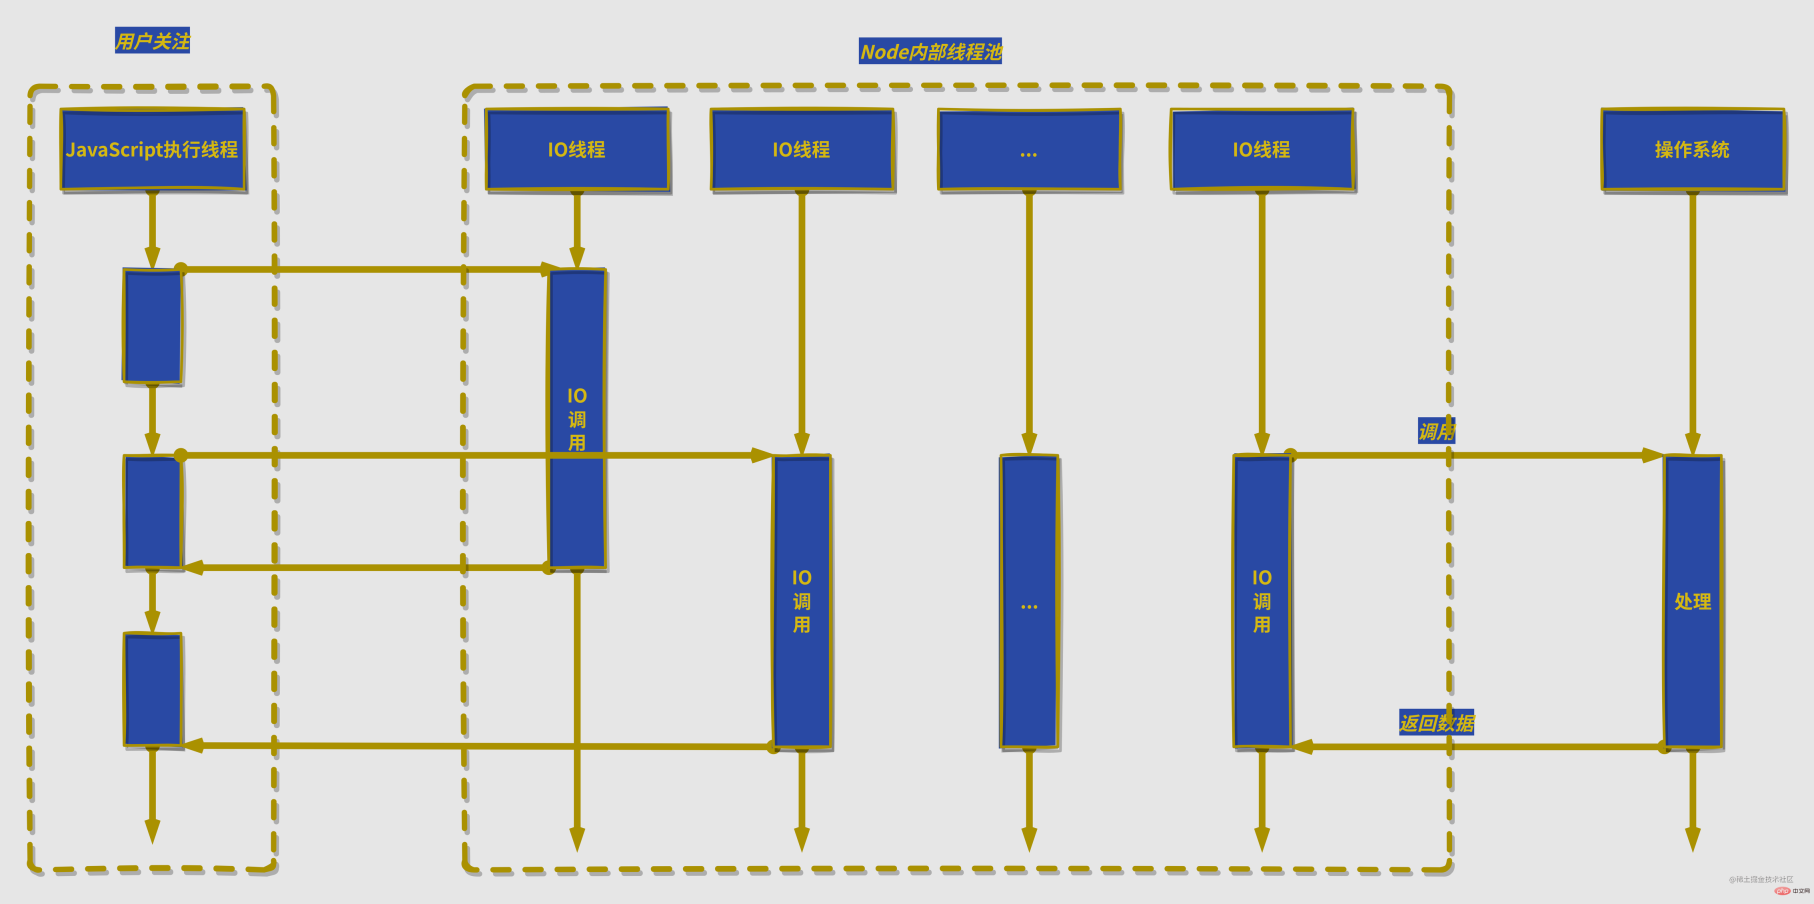
除了异步IO,计算机中的其他资源也适用,因为linux中一切皆文件,磁盘、硬件、套接字等几乎所有计算机资源都被抽象为了文件,接下来介绍对计算机资源的调用都以IO为例子。
事件循环
在进程启动时,node便会创建一个类似与while(true)的循环,每执行一次循环体的过程我们成为Tick;
下方为node中事件循环流程图:
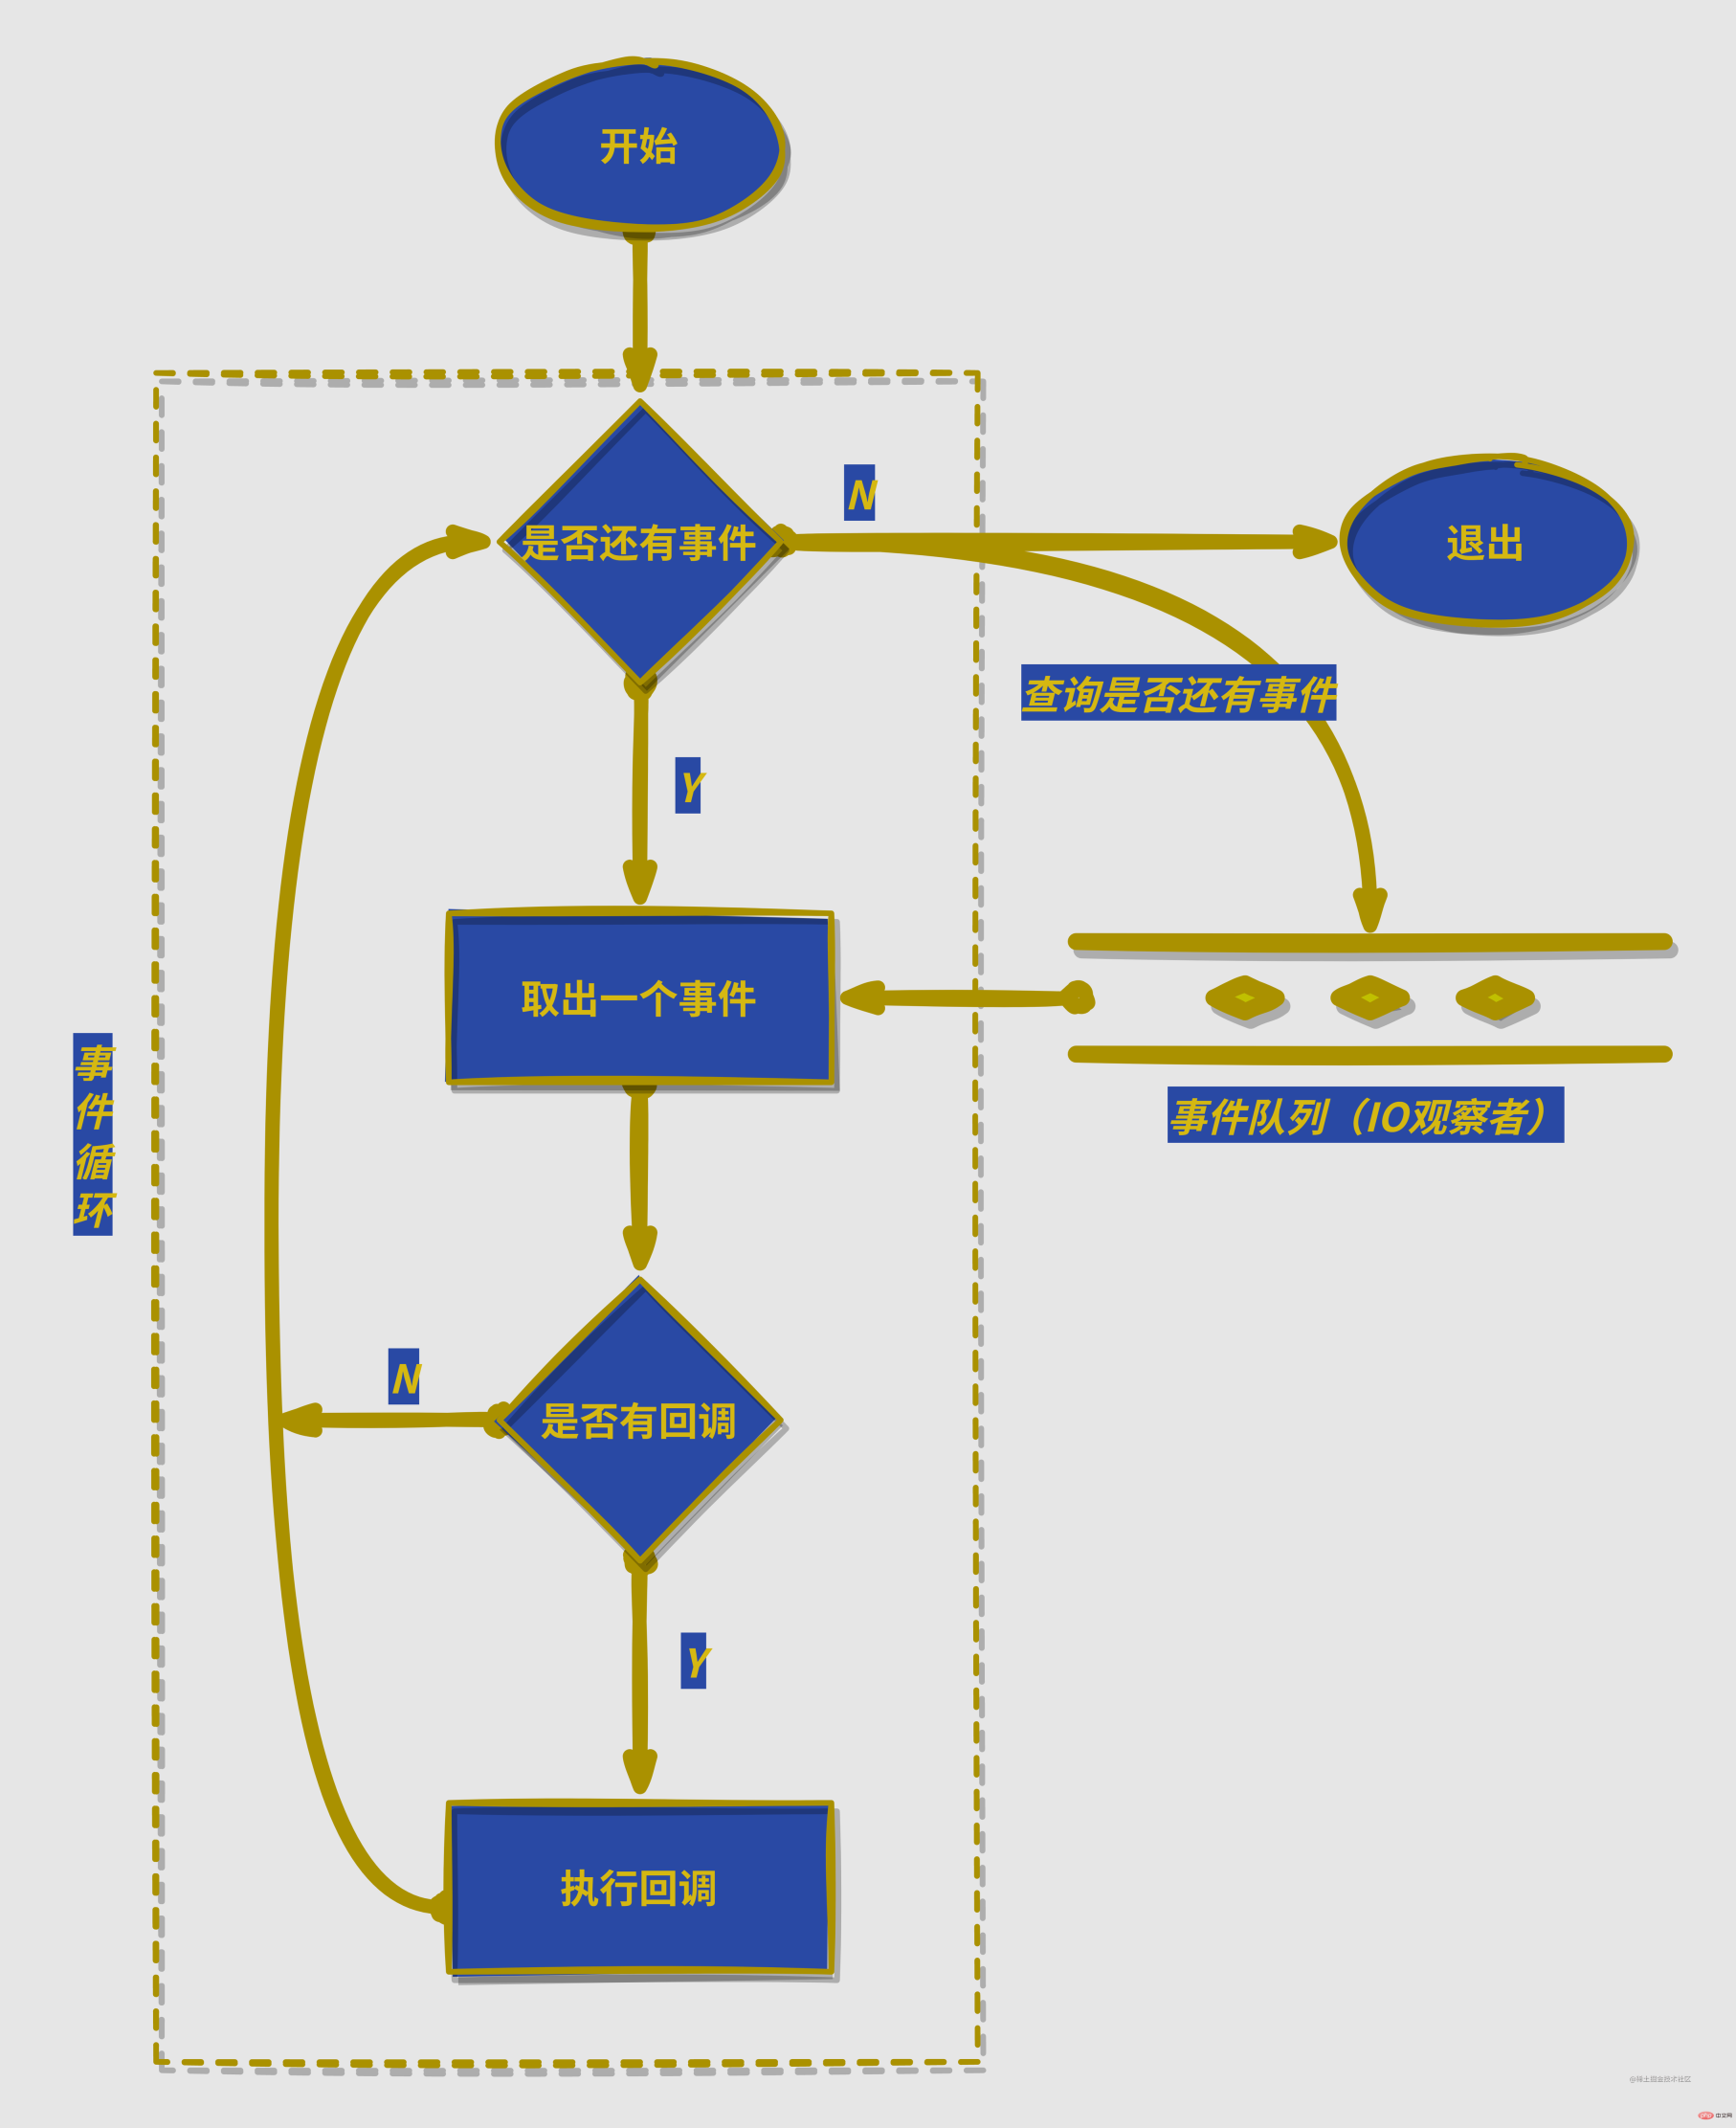
很简单的一张图,简单解释一下:就是每次都从IO观察者里面获取执行完成的事件(是个请求对象,简单理解就是包含了请求中产生的一些数据),然后没有回调函数的话就继续取出下一个事件(请求对象),有回调就执行回调函数
异步IO细节
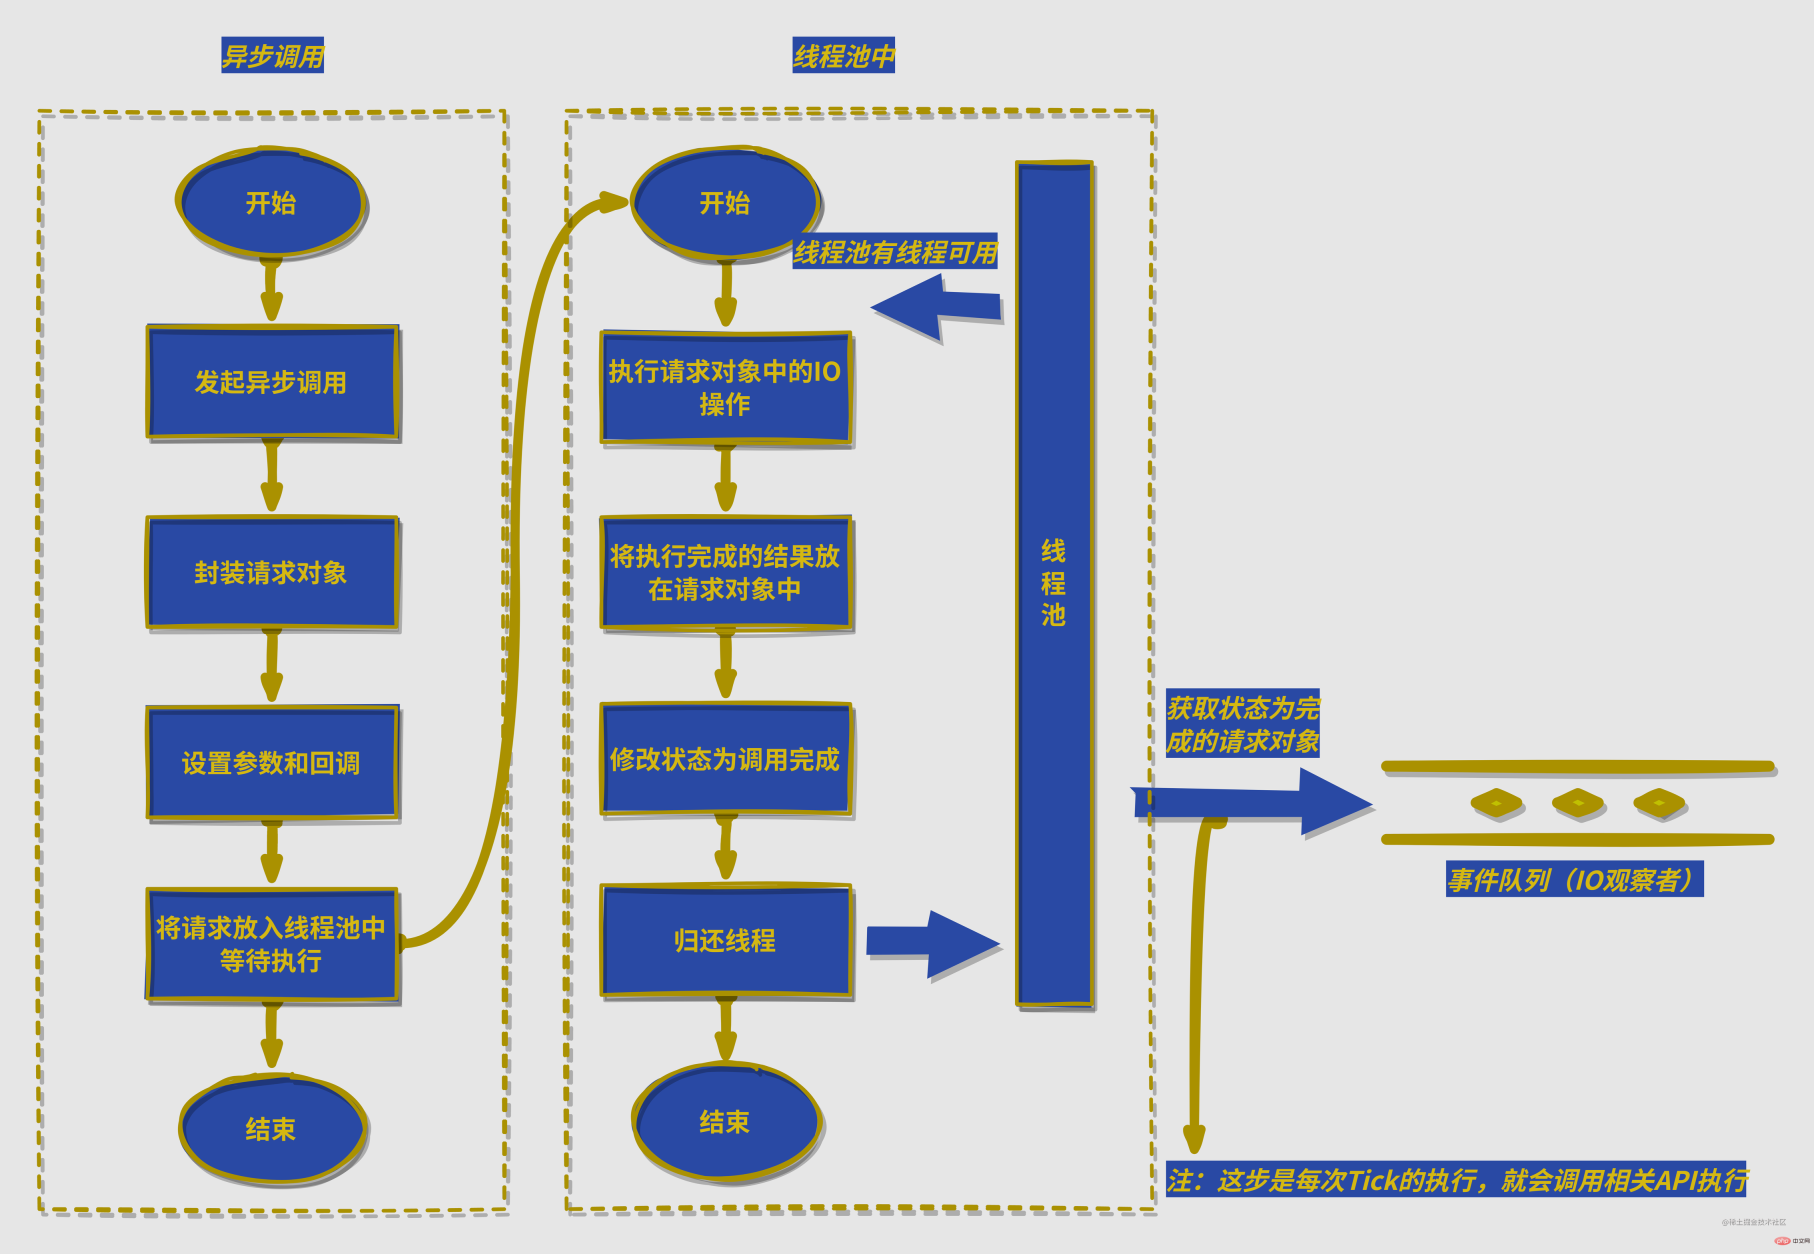
注:不同平台有不同的细节实现,这张图隐藏了相关平台兼容细节,比如windows下使用IOCP中的
PostQueuedCompletionStatus()提交执行状态,通过GetQueuedCompletionStatus获取执行完成的请求,并且IOCP内部实现了线程池的细节,而linux等平台通过eopll实现这个过程,并在libuv下自实现了线程池
setTimtout与setInterval
除了IO等计算机资源需要异步调用之外,node本身还存在一些与异步IO无关的一些其他异步API:

HISUI 前端框架基础开发指南。HISUI 是基于 easyui 二次开发的 jQuery UI 组件库,专为医疗信息系统设计。当涉及 HISUI 组件开发、jQuery easyui 表格/表单/布局/窗口、医疗系统前端页面编写时使用此 skill。 涵盖 40 个组件的官方文档参考,支持声明式与编程式两种初始化方式,提供 $cm/$m 数据访问方法。
setTimeoutsetIntervalsetImmediateprocess.nextTick
该小节先讲解前面两个api
它们的实现原理与异步IO比较类似,只是不需要IO线程池的参与:
-
setTimtout与setInterval创建的定时器会被插入到定时器观察者内部的一个红黑树中 - 每次
tick执行的时候,会从该红黑树中迭代取出定时器对象,检查是否超过定时时间 - 如果超过,就将这个事件(请求对象)推入到事件队列中,在事件循环中执行其中的回调函数
红黑树:这里简单提一下,就是一种特殊化的平衡二叉树,可以自平衡,查找效率基本上就是该二叉树的深度了
你有考虑过这个问题吗,为什么定时器不需要线程池的参与了呢,如果你理解了之前章节对于异步IO实现原理的话,相信你应该能解释出来,这里简单说说原因来加深记忆:
node中的IO线程池是用来调用IO并等待数据返回(看具体实现)的一种方式,它使JavaScript单线程得以异步调用IO,并且不需要等待IO执行完成(因为是IO线程池做了),并且能获取到最终的数据(通过观察者模式:IO观察者从线程池获取执行完成的事件,事件循环机制执行后续的回调函数)
上述这段话可能有点简略,如果你还不明白,可以看下之前的那几种图~
process.nextTick与setImmediate
这两个函数都是代表立即异步执行一个函数,那为什么不用setTimeout(() => { ... }, 0)来完成呢?
- 定时器精度不够
- 定时器使用红黑树来创建定时器对象和迭代操作,浪费性能
- 即
process.nextTick更加轻量
轻量具体来说:我们在每次调用process.nextTick的时候,只会将回调函数放入队列中,在下一轮Tick时取出执行。定时器中采用红黑树的方式时,nextTick为
那process.nextTick与setImmediate又有什么区别呢?毕竟它们都是将回调函数立即异步执行
-
process.nextTick的回调执行优先级高于setImmediate -
process.nextTick的回调函数保存在一个数组中,每轮事件循环下全部执行,setImmediate的结果则是保存在链表中,每轮循环按序执行第一个回调
注意:之所以process.nextTick的回调执行优先级高于setImmediate,因为事件循环对观察者的检查是有顺序的,process.nextTick属于idle观察者,setImmediate属于check观察者。iedl观察者 > IO 观察者 > check观察者
高性能服务器
对于网络套接字的处理,
node也应用到了异步IO,网络套接字上侦听到的请求都会形成事件交给IO观察者,事件循环会不停地处理这些网络IO事件,如果我们在JavaScrpt层面上有传入对应的回调函数,这些回调函数就会在事件循环中执行(处理这些网络请求)
常见的服务器模型:
- 同步式
- 每进程-->每请求
- 每线程-->每请求
而node采用的是事件驱动的方式处理这些请求,无需对每个请求创建额外的对应线程,可以省略掉创建线程和销毁线程的开销,同时操作系统的调度任务因为线程较少(只有node内部实现的一些线程)上下文切换的代价很低。
经典问题--雪崩问题的解决:
问题描述:服务器在刚启动时,缓存无数据,如果访问量巨大,同一条SQL会被发送到数据库中反复查询,影响性能。
解决方案:
const proxy = new events.EventEmitter();
let status = "ready"; // 状态锁,避免反复查询

const select = function(callback) {
    proxy.once("selected", callback);  // 绑定一个只执行一次名为selected的事件
    if(status === "ready") {
        status = "pending";
        // sql
        db.select("SQL", (res) => {
            proxy.emit("selected", res); // 触发事件,返回查询数据
            status = "ready";
        })
    }
}
使用once将所有请求的回调都压入了事件队列中,利用其只执行一次就会将监视器移除的特点,保证每一个回调函数只会被执行一次。对于相同的SQL语句,保证在同一个查询开始到结束的过程中永远只有一次。新到来的相同调用只需在队列中等待数据就绪即可,一旦查询到结果,得到的结果就可以被这些调用共同使用。
更多编程相关知识,请访问:编程教学!!