本篇文章带大家了解一下工作中可以怎么使用node,怎么利用它来提升工作效率,希望对大家有所帮助!
在工作项目中需要依赖外部文件,此文件由其他团队维护,使用 jenkins 构建,构建产物推送至 [Amazon S3](aws.amazon.com/pm/serv-s3/…),我们需要从 S3 手动下载文件然后复制到工程中,整个过程可以考虑自动化完成。
另外还遇到了一个严重的问题:我们需要的构建产物在 S3 中的路径类似 'a/b//c/',多余的一个 / 实际上是一个名为 '/' 的文件夹,此文件夹使用 windows 的 S3 Browser 可以正常识别,在 mac 下大概是因为 '/' 被看作文件分隔符,因此尝试几个 GUI 工具均无法正常识别目录,因此 mac 开发者还需要在虚拟机中使用 windows 下载产物,这个过程是极其浪费且无意义的。【推荐学习:《nodejs 教程》】
由于 Amazon 提供了 API 访问的方式,因此想到可以实现脚本来完成下载更新的工作。
流程梳理
未使用脚本:
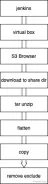
使用脚本:
jenkins → 产物名 → 执行脚本
这样直接就可以完成了,可以省去手动流程,还不会出现 '/' 的 bug 问题。
开发
连接 AWS
这里使用 Amazon 提供的 aws-sdk,使用 S3 client,传入 accessKeyId 和 secretAccessKey 就可以连接了:
import S3 from "aws-sdk/clients/s3";
const s3 = new S3({ credentials: { accessKeyId, secretAccessKey } });
下载文件
aws-sdk 中提供了 bucket 和文件的增删改查接口,这里我们可以提前拿到 jenkins 构建出的产物文件名,这里需要根据文件名和位置下载文件:
const rs = s3
  .getObject({ Bucket: "your bucket name", Key: "file dir + path" })
  .createReadStream();
Bucket 即存储文件的 Bucket 位置,Key 是文件在 S3 中的路径信息,整个路径相当于是目录名 + 文件名。
这里我们可以获取到一个 ReadStream,之后使用 node.js 可直接写入本地:
const ws = fs.createWriteStream(path.join(__dirname, outputfilename));
rs.pipe(ws);
解压
解压使用 node-tar 工具,直接安装即可:

生成Blender Python (bpy)脚本,该脚本使用node_groups API和GeometryNodeTree接口程序化地创建几何节点修改器树,用于参数化3D资产生成。
npm install tar
extract 别名为 x,这里直接使用 tar.x 方法,此方法可以直接处理 ReadStream,将原始数据解压后写入文件中,因此我们这里直接把 ReadStream 传入 tar.x 即可,不需要保存原始的 .tar 文件:
- const ws = fs.createWriteStream(path.join(__dirname, outputfilename));
- rs.pipe(ws);
+ rs.pipe(tar.x({ C: path.join(__dirname, outputfilename) }));
这里的 pipe 操作会返回 stream 对象,我们可以监听 finish 方法来处理后续流程:
const s = rs.pipe(tar.x({ C: path.join(__dirname, outputfilename) }));
s.on('finish', () => {
	// do something ...
})
Flatten 目录
原始文件有子文件夹,我们需要都移到最外层,因此需要做一个平铺文件夹的操作。
这里使用 fs 相关 API 进行读取,fs API 分为同步和异步两种,同步 API 函数名以 Sync 结尾,异步函数默认为 callback error first 风格,在 fs/promises 下提供了对应的 promise 风格异步 API,这里根据需要使用即可。
由于我们的目录只有一层,因此只做一层 flatten,如果有多层可以使用递归来实现:
async function flatten(dir) {
  const fileAndDirs = await fsp.readdir(dir);
  const dirs = fileAndDirs.filter((i) =>
    fs.lstatSync(path.join(dir, i)).isDirectory()
  );
  for (const innerDir of dirs) {
    const innerFile = await fsp.readdir(path.join(dir, innerDir));
    await Promise.all([
      innerFile
        .filter((item) => fs.lstatSync(path.join(dir, innerDir, item)).isFile())
        .map((item) =>
          fsp.rename(path.join(dir, innerDir, item), path.join(dir, item))
        ),
    ]);
    remove(path.join(dir, innerDir));
  }
}
复制到目标位置
之后复制到我们的工程目录即可,复制只需要调用 copyFile API,对于不需要的文件这里使用正则表达式配置 exclude 黑名单:
async function copy(from, to) {
  const files = await fsp.readdir(from);
  await Promise.all(
    files
      .filter((item) => !exclude.test(item))
      .map((item) => fsp.copyFile(path.join(from, item), path.join(to, item)))
  );
}
配置文件
在实际使用时,配置文件要和代码分离,这里的 accessKeyId 和 secretAccessKey 应该由每个使用者自己配置,因此放在单独的配置文件中,此文件由用户本地创建,在主程序中读取相关配置内容:
// config.js
module.exports = {
  s3: {
    accessKeyId: 'accessKeyId',
    secretAccessKey: 'secretAccessKey',
  }
};
// main.js
if (!fs.existsSync('config.js')) {
  console.error('please create a config file');
  return;
}
const config = require(path.resolve(__dirname, 'config.js'));
传递参数
每次下载的文件名需要在调用时传入,写在文件中会频繁修改,这里直接作为参数传递。
node.js 中可以通过 process.argv 来读取,argv 是一个数组,这个数组第一个元素是 node 所在的安装路径,第二个元素是当前执行的脚本所在路径,从第三个元素开始是自定义参数,因此需要从 process.argv[2] 开始。如果有复杂的命令行参数需求可以使用命令行参数解析库如 commander,由于本例只需要一个参数,这里直接读即可:
const filename = process.argv[2];
if (!filename) {
	console.error('please run script with params');
	return;
}
至此,一个可用的命令行工具就完成了。
总结
node.js 可以开发后端,但是 node.js 意义最大的地方绝不是使用 JS 开发后端。对前端开发者而言,node.js 真正的价值在于它是一个非常实用的工具,前端工具 Webpack、rollup、dev-server 等都是 node 创造的价值,由于 NPM 丰富的生态,使用 node 可以快速完成脚本的开发,处理开发中遇到的一些工具链与效率的问题很有效,在工作中遇到问题时可以考虑尝试。
更多编程相关知识,请访问:编程入门!!