mysql优化综合性的问题:
A、表的是设计合理化(符合 3范式)
B、添加适当的索引(index)[四种:普通索引,主键索引,唯一索引,unique,全文索引]
C、分表技术(水平分割,垂直分割)
D、读写[写:update/delete/add]分离
E、存储过程[模块化编程,可以提高速度]
F、对mysql配置优化[配置最大并发数,my.ini调整缓存大小]
G、Mysql服务器引荐升级
H、定时的去清楚不需要的数据,定时进行碎片整理
推荐Mysql相关视频教程:https://www.php.cn/course/list/51/type/2.html
1、数据库表的设计
第一范式:1NF是对属性的原子性约束,要求属性(列)具有原子性,不可再分解;(只要是关系型数据库都满足1NF)
第二范式:2NF是对记录的惟一性约束,要求记录有惟一标识,即实体的惟一性;
第三范式:3NF是对字段冗余性的约束,它要求字段没有冗余。没有冗余的数据库设计可以做到。
2、sql优化的一般步骤
操作步骤:
1、通过show status命令了解各种SQL的执行频率。
2、 定位执行效率较低的SQL语句-(重点select)
3、 通过explain分析低效率的SQL语句的执行情况
4、确定问题并采取相应的优化措施
MySQL通过使用show [session|global] status 命令可以提供服务器状态信息。
session来表示当前的连接的统计结果,global来表示自数据库上次启动至今的统计结果。默认是session级别的。
show status like ‘Com_%’;
其中Com_XXX表示XXX语句所执行的次数。Eg:Com_insert,Com_Select…
重点注意:Com_select,Com_insert,Com_update,Com_delete通过这几个参数,可以容易地了解到当前数据库的应用是以插入更新为主还是以查询操作为主,以及各类的SQL大致的执行比例是多少。
Connections:试图连接MySQL服务器的次数
Uptime:服务器工作的时间(单位秒)
Slow_queries:慢查询的次数 (默认是慢查询时间10s)
Show status like‘Handler_read%’使用查询的次数
定位慢查询:
在默认的情况下mysql是不记录满查询日志的,需要在启动的时候指定
\bin\mysqld.exe- -safe-mode – slow-query-log[mysql5.5可以在my.ini中指定]
\bin\mysqld.exe- -log-slow-queries=d:bac.log
具体操作如下:
如果启用了慢查询,默认存储在mysql.ini文件的此处

1、重启mysql,找到datadir的路劲,使用cmd进入到data的上级目录
2、运行命令\bin\mysqld.exe –safe-mode –slow-query-log(注意执行前先关闭mysql服务)
3、生成的日志文件记录着所有的记录信息
显示慢查询的时间:Show variables like ‘long_query_time’;
重新设置满查询的时间:Set long_query_time=2;
修改命令结束符:(为了存储过程能够正常执行,我们需要把命令结束符号进行修修改)
Delimiter $$
如何把慢查询的sql语句记录到我们的日志中(默认情况下mysql是不会记录的,需要在启动mysql的时候,指定慢查询的)。
3、索引
♥索引的类型:
★四种索引①主键索引②唯一索引③普通索引④全文索引
一、添加
1.1主键索引添加
当把一张表的某列设置为主键的时候,则该列就是主键索引。
Createtable aaa(id int unsigned primary key auto_increment,
name varchar(32) not null default);
1.2普通索引
一般来说,普通索引是先创建表,然后创建普通索引。
比如:
Createindex索引名 from表名
1.3创建全文索引
全文索引,主要是针对文件,比如文章的索引全文索引针对MyISAM有用,针对innodb没有用
Create table articles(
Id int unsignedauto_increment not null primary key,
Title varchar(20),
Body text,
Fulltext (title,body)
)engine=myisam charsetutf8;
错误用法:
Select * from articles where body like ‘%mysql%’[不会使用到全文索引]
证明:
Explain select * from articles body like ‘%mysql%’;
正确的用法:
Select * from article wherematch(title,body)against(‘database’);[可以]
说明:
1、在mysql中fulltest索引值针对myisam生效
2、针对英文生效,àsphinx(coreseek)技术处理中文
3、使用的方法,match(字段名,…)against(‘关键词’)
4、全文索引一个叫停止词。因为在一个文本中,创建索引的是一个无穷大的书,因此,对一些常用词和字符就不会创建,这些词,称之为停止词
1.4创建唯一索引
当表的某列被指定为unique约束时,这列就是唯一索引
第一种、Create table ddd(id int primary keyauto_increment,name varchar(32) unique);
这时,name默认就是唯一索引
第二种、create table eee(id int primary keyauto_increment,name varchar(32));
Createunique index索引名 on表名(列名)
简单的说:PRIMARY KEY=UNIQUE+NOT NULL
Unique字段可以为null,并可以有多个null,但是如果是具体内容,则不能重复
主键字段,不能为null,也不能重复
二、查询
1.Desc表名[该方法的缺点,不能够现实索引名]
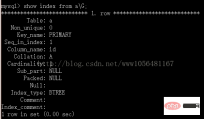
2.Show index from表名;
select index from表名\G
3.show keys from表名
三、删除
Altertable 表名 drop index 索引名,
Altertable 表名 drop primary key。(删除主键索引名)
四、修改
先删除,在全部
二、针对SQL编写导致的慢 SQL,优化起来还是相对比较方便的。正如上一节提到的正确的使用索引能加快查询速度,那么我们在编写 SQL 时就需要注意与索引相关的规则:
1.字段类型转换导致不用索引,如字符串类型的不用引号,数字类型的用引号等,这有可能会用不到索引导致全表扫描;
2.mysql 不支持函数转换,所以字段前面不能加函数,否则这将用不到索引;
3.不要在字段前面加减运算;
4.字符串比较长的可以考虑索引一部份减少索引文件大小,提高写入效率;
5.like % 在前面用不到索引;
6.根据联合索引的第二个及以后的字段单独查询用不到索引;
7.不要使用 select *;
8.排序请尽量使用升序 ;
9.or 的查询尽量用 union 代替(Innodb);
10.复合索引高选择性的字段排在前面;
11.order by / groupby 字段包括在索引当中减少排序,效率会更高。
除了上述索引使用规则外,SQL 编写时还需要特别注意一下几点:
1.尽量规避大事务的 SQL,大事务的 SQL 会影响数据库的并发性能及主从同步;
2.分页语句 limit 的问题;
3.删除表所有记录请用 truncate,不要用 delete;
4.不让 mysql 干多余的事情,如计算;
5.输写 SQL 带字段,以防止后面表变更带来的问题,性能也是比较优的 ( 涉及到数据字典解析,请自行查询资料);
6.在 Innodb上用 select count(*),因为 Innodb 会存储统计信息;
7.慎用 Oder by rand()。
三、显示慢查询的次数:show status like 'slow_queries';
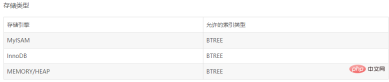
HEAP是较早的mysql版本
四、Explain分析低效率的SQL语句:
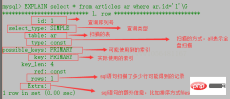
会产生如下信息:
select_type:表示查询的类型。
table:输出结果集的表
type:表示表的连接类型
possible_keys:表示查询时,可能使用的索引
key:表示实际使用的索引
key_len:索引字段的长度
rows:扫描出的行数(估算的行数)
Extra:执行情况的描述和说明
Select_type类型:
primary : 子查询中最外层查询
subquery : 子查询内层第一个select,结果不依赖于外部查询
dependent subquery : 子查询内层第一个select,依赖于外部查询
union:union语句中第二个select开始后面所有select
simple: 简单模式
union result: union中合并结果
type 类型:
all: 完整的表扫描 通常不好
system : 表仅有一行(=系统表) 这是const联接类型的一个特例
const : 表最多有一个匹配行
extra 类型:
no table: query语句中使用 from dual 或不含任何from子句
Using filesort : 当query中包含 order by 操作,而且无法利用索引完成排序
impossible WHERE noticed after readingconst tables:Mysql query optimizer
通过收集统计信息不可能存在结果
Using temporary : 某些操作必须使用临时表,常见 group by ,order by
Using where: 不用读取表中所有信息,仅通过索引就可以获取所需数据
4、为什么使用了索引后查询速度会变快
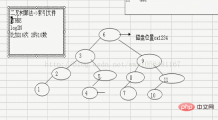
普通的查询如果没有索引,他会一直去执行,及时匹配到了还要继续查询,不能保证后面有没有要查询的。要全文索引。
■索引使用的注意事项
索引的代价:
1、占用磁盘空间
2、对DML(insert,update,create)操作有影响,变慢
■总结:满足以下条件,才应该创建索引
A、肯定在where经常使用
B、该字段的内容不是唯一的几个值(sex)
C、字段内容不是频繁变化
■使用索引的注意事项:
alter table dept add index myind (dname,loc); // dname就是左边的列,loc是右边的列
下列情况有可能使用到索引
a.对于创建的多列索引,只要查询条件使用了最左边的列,索引一般就会被使用 explain select * from dept where dname='aaa';
b.对于使用like的查询,查询条件如果是'%aaa'则不会使用到索引,'aaa%'会使用到索引
下列情况不会使用索引 :
a.如果条件中有or,即使其中有条件带索引也不会使用换言之,就是要求使用的所有字段都创建索引,建议:尽量避免使用or关键字
b.对于多列索引,不是使用的第一部分,则不会使用索引
explain select * from dept where loc='aaa';// 多列索引时,loc为右边列,索引不会使用到
c.like查询是以%开头如果一定要使用,则使用全文索引去查询
d.如果列类型是字符串,那一定要在条件中将数据使用引号引起来,否则不使用索引
e.如果MySQL估计使用全表扫描要比使用索引块,则不使用索引
如何选择mysql的存储引擎
1:myISAM
如果表对事务的要求不高,同事一查询和添加为主的,
比如BBS中的发帖,回帖。
2:InnoDB
对事务的要求高,保存的数据都是重要数据,
比如订单,账户表
3:Memory:
数据变化频繁,不需要入库同时又进场查询和修改。
myISAM和InnoDB的区别:
1、myISAM批量插入快,InnoDB插入慢,myISAM插入时候不排序。
2、InnoDB支持事务,myISAM不支持事务。
3、MyISAM支持全文索引,
4、锁机制,myISAM是表锁,InnoDB是行锁
5、myISAM不支持外键,InnoDB支持外健
① 在进度要求高的应用中,建议使用定点数据来存储数值,组U一保证数据的准确性,deciaml进度比float高,尽量使用
② 对于存储引擎的myISAM的数据库,如果进场要走删除和修改的操作,要定时执行optimize_table_name功能对表进行碎片整理。
③ 日期类型要根据实际需要选择引用的最小存储的早期类型,
手动备份数据库:
1、进入cmd
2、Mysqldump –uroot –proot数据库【表名1,表名2…】 > 文件路径
Eg: mysqldump -uroot -proot temp > d:/temp.bak
恢复备份文件数据:
Source d:/temp.bak(在mysql控制台)
合理的硬件资源和操作系统
Master
Slave1
Slave2
Slave3
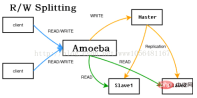
主库master用来写入,slave1—slave3都用来做select,每个数据库
分担的压力小了很多。
要实现这种方式,需要程序特别设计,写都操作master,读都操作
slave,给程序开发带来了额外负担。当然目前已经有中间件来实现这个
代理,对程序来读写哪些数据库是透明的。官方有个mysql-proxy,但是
还是alpha版本的。新浪有个amobe for mysql,也可达到这个目的,结构
如下:
5、表的分割
水平分割:
大数据量的表,我们在提供检索的时候,应该根据业务的需求,找到表的标准,并在检索页面约束用户的检索方式,而且要配合分页,
案例:大数据量的用户表
三张表:qqlogin0,qqlogin1,qqlogin2
将用户id%3,按结果放入不同的表当中
create tableqqlogin0(
id int unsigned not null primary key,/* 这个id不能设置自增长 */
name varchar(32)not null default'',
pwd varchar(32)not null default''
)engine = myisam default charset = utf8;
创建表qqlogin1(
id int unsigned not null主键,/ *这个id不能设置自增长* /
name varchar(32)not null default'',
pwd varchar(32)not null default''
)engine = myisam default charset = utf8;
创建表qqlogin2(
id int unsigned not null主键,/ *这个id不能设置自增长* /
name varchar(32)not null default'',
pwd varchar(32)not null default''
)engine = myisam default charset = utf8;
垂直分割:
把某个表的某些字段,这些字段,在查询时候并不关系,但是数据量很大,我们建议将这些字段放到一个表中,从而提高效率
6、优化的mysql的配置
MY.INI
port = 3306默认端口是3306,
如果想修改端口port = 3309,在mysql_connect('localhost:3309','root','root');要注意
query_cache_size = 15M这个是查询缓存的大小
InnoDB的参数也可以调大以下两个参数
innodb_additional_mem_pool_size = 64M
innodb_buffer_pool_size = 1G
myisam需要调整key_buffer_size
调整参数还要看状态,用show status可以看到当前状态,以决定该调整哪些参数
7、增量备份
实际案例:
如何进行增量备份,和恢复
步骤:
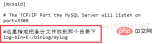
如图1所示,配置的my.ini文件或者是my.cof,启用二进制备份
2,重新启动的MySQL
启动之后会发现mylog目录下生成了一下文件
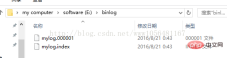
其中:E:\二进制日志\ mylog.index索引文件,有哪些备份文件
E:\二进制日志\ mylog.000001存放用户对象数据库操作的文件
3,当我们进行操作的时候(选择)
查看需要进入到MySQL的的安装目录下的bin中,然后执行mysqlbinlog可以文件,后面追加文件路径
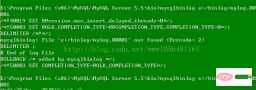
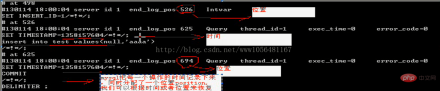
如图4所示,恢复到某个语句的时间点
4,1按照时间点回复
Mysqlbinlog -stop-datetime =“2013-01-17 12:00:23”d:/binlog/mylog.000001 | mysq -uroot -p
(恢复到停止时间之前的所有数据)
Mysqlbinlog-start-datetime =“2013-01-17 12:00:23”d:/binlog/mylog.000001 | mysq -uroot -p
(恢复开始时间到之后的所有数据)
4,2按照位置恢复
Mysqlbinlog-stop-position =“234”d:/binlog/mylog.000001 | mysq -uroot -p
(恢复到停止时间之前的所有数据)
Mysqlbinlog-start-position =“234”d:/binlog/mylog.000001 | mysq -uroot -p
(恢复开始时间到之后的所有数据)
更多相关问题,请访问PHP中文网:https://www.php.cn/