





Python抓取网页乱码的原因及解决方法

阿伟姑娘_3464

阿伟姑娘_3464

2019-03-16

4034人浏览

转载

本篇文章给大家带来的内容是关于python抓取网页乱码的原因及解决方法,有一定的参考价值,有需要的朋友可以参考一下,希望对你有所帮助。

在用 python2 抓取网页的时候,经常会遇到抓下来的内容显示出来是乱码。

发生这种情况的最大可能性就是编码问题: 运行环境的字符编码和网页的字符编码不一致。

比如,在 windows 的控制台(gbk)里抓取了一个 utf-8 编码的网站。或者,在 Mac / Linux 的终端(utf-8)里抓取了一个 gbk 编码的网站。因为多数网站采用 utf-8 编码,而不少人又是用 windows,所有这种情况相当常见。

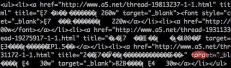
如果你发现你抓下来的内容,看上去英文、数字、符号都是对的,但中间夹杂了一些乱码,那基本可以断定是此情况。
2968579260-5c89ed890ab6d_articlex.jpg

解决这个问题的办法就是,把结果先按网页的编码方式 decode 解码成 unicode,再输出。如果不确定网页的编码,可参照以下代码:

import urllib
req = urllib.urlopen("http://some.web.site")
info = req.info()
charset = info.getparam('charset')
content = req.read()
print content.decode(charset, 'ignore')

'ignore' 参数的作用是忽略掉无法解码的字符。

不过这种方法不总是有效。还有种方式就是通过正则直接匹配网页代码中的编码设置:

<meta>

除了编码问题造成乱码之外,还有种常被忽视的情况,就是 目标网页启用了 gzip 压缩 。压缩后的网页传输数据少了,打开速度更快。在浏览器中打开时,浏览器会根据网页的 header 信息自动做解压。但直接用代码抓取则不会。因此很可能就被搞糊涂了,为什么明明打开网页地址是对的,但程序抓取就不行。连我自己也曾经被这个问题坑过。

这种情况的表现是抓取的内容几乎全是乱码,甚至无法显示。

要判断网页是否启用了压缩并对其解压,可参考以下代码:

Biopython
Biopython

全面的分子生物学工具集。适用于序列操作、文件解析(FASTA/GenBank/PDB)、系统发育分析,以及通过 Bio.Entrez 以编程方式访问 NCBI/

下载
import urllib
import gzip
from StringIO import StringIO
req = urllib.urlopen("http://some.web.site")
info = req.info()
encoding = info.getheader('Content-Encoding')
content = req.read()
if encoding == 'gzip':
    buf = StringIO(content)
    gf = gzip.GzipFile(fileobj=buf)
    content = gf.read()
print content

在我们教室的编程实例 查天气系列(点击查看) 中,这两个问题困扰了相当多人。在此特别讲解一下。

最后,还有个“利器”要介绍一下。如果一开始就用它,你甚至不知道还有上述两个问题的存在。

这就是 requests 模块。

同样抓取网页,只需要:

import requests
print requests.get("http://some.web.site").text

没有编码问题,没有压缩问题。

This is why I love Python.

至于如何安装 requests 模块,请参考之前的文章:

如何安装 Python 的第三方模块 - Crossin的编程教室 - 知乎专栏

pip install requests

Python免费学习笔记(深入):立即使用
在学习笔记中,你将探索 Python 的核心概念和高级技巧!
相关文章

python速学教程(入门到精通)
python速学教程(入门到精通)

python怎么学习?python怎么入门?python在哪学?python怎么学才快?不用担心,这里为大家提供了python速学教程(入门到精通),有需要的小伙伴保存下载就能学习啦!

下载

相关标签:

python

本站声明:本文内容由网友自发贡献,版权归原作者所有,本站不承担相应法律责任。如您发现有涉嫌抄袭侵权的内容,请联系admin@php.cn

相关专题

更多
Go-Zero API开发使用教程
Go-Zero API开发使用教程

本专题聚焦Go-Zero的API开发,拆解.api描述文件的语法结构、路由与分组定义、参数绑定与校验规则,说明统一响应体、JWT鉴权、跨域与接口文档生成的落地方式,并给出网关聚合与接口测试的实践建议。

2026.11.12

80

15

Go-Zero安装与goctl环境配置教程

本专题围绕Go-Zero的安装与工具链配置展开,讲清Go版本要求、goctl安装方式、代理镜像、protoc依赖与环境变量设置,说明多版本共存、升级回退与CI流水线安装的做法,并整理安装阶段的常见报错与验证步骤。

2026.11.12

60

15

Go-Zero零基础入门教程
Go-Zero零基础入门教程

本专题整理Go-Zero的入门知识,从框架定位、环境准备到跑通第一个API服务,讲清目录分层、配置加载、日志与中间件的基本用法,并对比Gin、Kratos的差异,帮助Go开发者建立整体认知,判断它是否适合当前项目。

2026.11.12

40

15

Postman身份认证怎么配置
Postman身份认证怎么配置

本专题从实际API接口调试场景出发,讲解Postman身份认证的完整配置流程,包括常见认证协议介绍、授权参数设置、访问令牌填写、OAuth 2.0授权及认证失败排查,帮助用户正确完成接口授权与访问验证。

2026.11.06

140

12

Postman请求头Headers怎么设置

围绕Postman HTTP请求头配置展开,讲解Headers选项的具体使用方式,包括Key和Value参数填写、请求头信息添加、常见Header字段设置及请求头修改方法,帮助用户解决接口调试过程中遇到的请求头配置问题。

2026.11.06

120

13

Postman接口请求发送教程
Postman接口请求发送教程

详细介绍Postman接口请求的创建与发送方法,涵盖GET和POST请求、URL配置、请求参数、Headers请求头、Body请求体设置以及响应结果查看,帮助用户掌握Postman接口请求的完整操作流程。

2026.11.06

120

10

DBeaver怎么导入数据
DBeaver怎么导入数据

DBeaver数据导入专题,整理Excel、CSV、SQL、TXT等常见文件的数据导入方法,涵盖目标数据库选择、数据表创建、字段映射、数据类型设置及导入参数配置等操作,帮助用户将本地文件中的数据写入数据库,并了解批量导入、重复数据处理和导入失败等常见问题的解决方法。

2026.11.05

100

12

DBeaver安全防护教程大全
DBeaver安全防护教程大全

DBeaver安全防护专题,围绕数据库连接安全、账号密码保护和访问权限管理展开,整理SSL/TLS加密连接、SSH隧道、数据库凭据保存及证书验证等配置方法,同时介绍敏感信息保护、远程连接风险和高权限账号使用等注意事项,帮助用户提高数据库日常管理的安全性。

2026.11.05

80

12

DBeaver连接创建与配置教程
DBeaver连接创建与配置教程

本专题聚焦DBeaver数据库连接配置与管理,覆盖从新建连接、选择数据库类型到填写连接参数和验证连接的完整流程。针对MySQL、PostgreSQL、SQL Server等常见数据库,整理相应的连接设置方法,并提供驱动缺失、认证失败和连接异常等问题的排查方向。

2026.11.04

100

16

热门下载

更多
网站特效
/
网站源码
/
网站素材
/
前端模板

精品课程

更多
相关推荐
/
热门推荐
/
最新课程



