本篇文章给大家带来的内容是关于Python数据可视化的四种方法介绍(附示例),有一定的参考价值,有需要的朋友可以参考一下,希望对你有所帮助。
摘要:本文讲述了热图、二维密度图、蜘蛛图、树形图这四种Python数据可视化方法。
数据可视化是任何数据科学或机器学习项目的一个重要组成部分。人们常常会从探索数据分析(EDA)开始,来深入了解数据,并且创建可视化确实有助于让问题更清晰和更容易理解,尤其是对于那些较大的高维度数据集。在项目结束的时候,能够以清晰的、简洁的和令人信服的方式呈现最终结果,这是非常重要的,让你的用户能够理解和明白。
你可能已经看过了我之前的文章《5种快速和简单的Python数据可视化方法(含代码)》(5 Quick and Easy Data Visualizations in Python with Code),其中介绍了5种基本可视化方法:散点图、线图、柱状图、条形图和箱形图。这五个是简单而强大的可视化方法,你绝对可以通过这些方法从数据集中得到巨大的收获。在本文中,将介绍另外4个数据可视化方法,但稍微复杂一些,你可以在看完上一篇文章介绍的基本方法之后再用。
热图(Heat Map)
热图是数据的矩阵表示方式,其中每个矩阵的值用一种颜色来表示。不同的颜色代表不同的级别,矩阵指数将两个对比的列或特征连接在一起。热图可以很好地显示出多个特征变量之间的关系,因为可以直接把一个级别看作一种颜色。还可以通过观察热图中的一些点来查看每个关系是如何与数据集中的其它关系进行比较的。这些颜色的确提供了简单的表示方式,因为这是非常直观的。
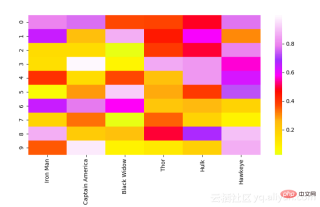
现在来看下代码:与matplotlib库相比,seaborn库可用于更高级的图表,通常也需要更多的组件,如更多的颜色、图形或者变量。Matplotlib库用于显示图表,numpy用于生成数据,而pandas用于控制。绘图只是调用一个简单的seaborn函数,如果你发现了一些在视觉上很特别的东西,通过这个函数,还可以设置颜色映射。
# Importing libs
importseaborn as sns
import pandas aspd
importnumpyasnp
importmatplotlib.pyplotasplt

# Create a random dataset
data=pd.DataFrame(np.random.random((10,6)), columns=["Iron Man","CaptainAmerica","BlackWidow","Thor","Hulk", "Hawkeye"])

print(data)

# Plot the heatmap
heatmap_plot=sns.heatmap(data, center=0, cmap='gist_ncar')

plt.show()
二维密度图(2D Density Plot)
二维密度图是一维版本的简单扩展,能够看到关于2个变量的概率分布。让我们看看下面的二维密度图,右边的刻度用颜色表示每一点的概率。最高的概率,看下数据集,似乎大约是0.5的大小和1.4-ish的速度。正如你所看到的,二维密度图对于快速确定数据对于两个变量最集中的区域非常地显著,而不是像一维密度图那样只集中一个变量。当你有两个对输出结果非常重要的变量,并且希望了解它们如何一起对输出结果分布起作用的时候,二维密度图尤其适合。
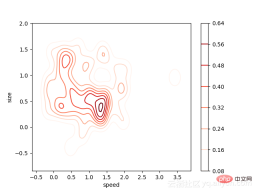
Seaborn的代码超级简单,我们将通过创建一个偏态分布介绍它。如果你发现某些颜色和阴影在视觉上更特别,那么大多数的可选参数都是为了看起来更清晰。

蜘蛛图(Spider Plot)
蜘蛛图是显示一对多关系最好的方法之一。也就是说,你可以绘制并查看区别于单个变量或类别的多个变量的值。在蜘蛛图中,一个变量相对于另一个变量的特性是显而易见的,因为面积和长度在一些方向上变化了。如果你希望了解几个类别关于这些变量是如何叠加起来的,可以并排绘制一下。在下图中,很容易比较三个电影角色的不同属性,并了解他们的优势所在!
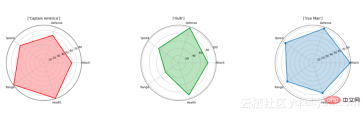
这次我们将能够直接使用matplotlib来创建可视化,而不是用seaborn。需要计算每个属性所在的角度,因为我们希望它们沿圆周被平均地分隔开。我们将在每个计算的角度放置标签,然后把值绘制成一个点,该点到中心的距离取决于它的值或是级别。最后,为了清晰起见,我们将使用半透明的颜色填充由连接各属性点的线所包含的区域。
# Import libs
import pandas aspd
importseabornassns
importnumpyasnp
importmatplotlib.pyplotasplt

# Get the data
df=pd.read_csv("avengers_data.csv")
print(df)

"""
   #             Name  Attack  Defense  Speed  Range  Health
0  1         Iron Man      83       80     75     70      70
1  2  Captain America      60       62     63     80      80
2  3             Thor      80       82     83    100     100
3  3             Hulk      80      100     67     44      92
4  4      Black Widow      52       43     60     50      65
5  5          Hawkeye      58       64     58     80      65

"""

# Get the data for Iron Man
labels=np.array(["Attack","Defense","Speed","Range","Health"])
stats=df.loc[0,labels].values

# Make some calculations for the plot
angles=np.linspace(0, 2*np.pi, len(labels), endpoint=False)
stats=np.concatenate((stats,[stats[0]]))
angles=np.concatenate((angles,[angles[0]]))

# Plot stuff
fig=plt.figure()
ax=fig.add_subplot(111, polar=True)
ax.plot(angles, stats, 'o-', linewidth=2)
ax.fill(angles, stats, alpha=0.25)
ax.set_thetagrids(angles *180/np.pi, labels)
ax.set_title([df.loc[0,"Name"]])
ax.grid(True)

plt.show()
树形图(Tree Diagram)
我们从小学就开始使用树形图了,树形图既自然又直观,还易于解释。直接连接的节点关系密切,而与有多个连接的节点差别很大。在下图中,我已经根据统计绘制了一小部分来自Kaggle的Pokemon with stats数据集:
HP、攻击、防御、特殊攻击、特殊防御、速度
因此,与stats wise最匹配的Pokemon将紧密连接在一起。例如,我们看到,在顶部,Arbok和Fearow是直接连接的,而且,如果我们查看数据,Arbok总共有438个,而Fearow有442个,非常接近。但是一旦我们移动到Raticate,我们得到的总数是413,这与Arbok和Fearow的差别很大,这就是它们被分开的原因。当我们移动树的时候,基于相似性,Pokemon被分的组越来越多。在绿色组中的Pokemon相互之间比红色组中的更相似,即使没有直接的绿色连接。
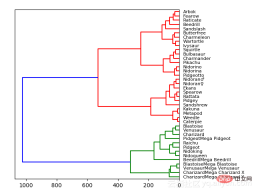
对于树形图,我们实际上要使用Scipy的。在查看了数据集之后,我们将去掉字符串类型的列。我们这么做只是为了要得到正确的可视化结果,但在实践中,最好是把这些字符串转换成分类变量,为了得到更好的结果和进行比较,我们还设置了数据帧索引,以便能够适当地用它作为引用每个节点的列。最后,在Scipy中计算和绘制树形图是非常简单的事了。
# Import libs
import pandas aspd
frommatplotlibimportpyplotasplt
fromscipy.clusterimport hierarchy
importnumpyasnp
# Read in the dataset
# Drop any fields that are strings
# Only get the first 40 because this dataset is big
df=pd.read_csv('Pokemon.csv')
df=df.set_index('Name')
del df.index.name
df=df.drop(["Type 1", "Type 2", "Legendary"], axis=1)
df=df.head(n=40)
# Calculate the distance between each sample
Z =hierarchy.linkage(df, 'ward')
# Orientation our tree
hierarchy.dendrogram(Z, orientation="left", labels=df.index)
plt.show()
Python免费学习笔记(深入):立即使用
在学习笔记中,你将探索 Python 的核心概念和高级技巧!