爬虫问题解决的相关问题

冬伟同学_6456

冬伟同学_6456

2017-06-23

1741人浏览

原创

  继续上一篇文章的内容,上一篇文章中已经将url管理器和下载器写好了。接下来就是url解析器,总的来说这个模块是几个模块中比较难的。因为通过下载器下载完页面之后,我们虽然得到了页面,但是这并不是我们想要的结果。而且由于页面的代码很多,我们很难去里面找到自己想要的数据。所幸,我们下载的是html页面,它是一种由多个多层次的节点组成的树型结构的文本文件。所以,相较于txt文件,我们更加容易定位到我们要找的数据块。现在我们要做的就是去原页面去分析一下,我们想要的数据到底在哪。

  打开百度百科pyton词条的页面,然后按F12调出开发者工具。通过使用工具,我们就能定位到页面的内容:
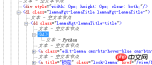
  这样我们就找到了我们想要的信息处在哪个标签里了。

 1 import bs4 2 import re 3 from urllib.parse import urljoin 4 class HtmlParser(object): 5     """docstring for HtmlParser""" 6     def _get_new_urls(self, url, soup): 7         new_urls = set() 8         links = soup.find_all('a', href = re.compile(r'/item/.')) 9         for link in links:10             new_url = re.sub(r'(/item/)(.*)', r'\1%s' % link.getText(), link['href'])11             new_full_url = urljoin(url, new_url)12             new_urls.add(new_full_url)13         return new_urls14 15     def _get_new_data(self, url, soup):16         res_data = {}17         #url18         res_data['url'] = url19         #
20         title_node = soup.find('dd', class_ = "lemmaWgt-lemmaTitle-title").find('h1')21         res_data['title'] = title_node.getText()22         #
23         summary_node = soup.find('div', class_ = "lemma-summary")24         res_data['summary'] = summary_node.getText()25         return res_data26 27     def parse(self, url, html_cont):28         if url is None or html_cont is None:29             return 30         soup = bs4.BeautifulSoup(html_cont, 'lxml')31         new_urls = self._get_new_urls(url, soup)32         new_data = self._get_new_data(url, soup)33         return new_urls, new_data

  解析器只有一个外部方法就是parse方法,

    a.首先它会接受url, html_cont两个参数,然后进行判断页面内容是否为空

    b.调用bs4模块的方法来解析网页内容,'lxml'为文档解析器,默认的为html.parser,bs官方推荐我们用lxml,那就听它的吧,谁让人家是官方呢。

    c.接下来就是调用两个内部函数来获取新的url列表和数据

    d.最后将url列表和数据返回

  这里有一些注意点

    1.bs的方法调用还有一个参数,from_encoding 这个和我在下载器那里的重复了,所以我就取消了,两个的功能是一样的。

    2.获取url列表的内部方法,需要用到正则表达式,这里我也是摸着石头过河,不是很会,中间也调试过许多次。

Python 环境工具基础版
Python 环境工具基础版

管理 Python 项目环境,支持虚拟环境创建、依赖安装与环境诊断

下载

    3.数据是放在字典中的,这样可以通过key来增改删除数据。


最好,就直接数据输出了,这个比较简单,直接上代码。


 1 class HtmlOutputer(object): 2     """docstring for HtmlOutputer""" 3     def __init__(self): 4         self.datas = [] 5     def collect_data(self, new_data): 6         if new_data is None: 7             return 8         self.datas.append(new_data) 9     def output_html(self):10         fout = open('output1.html', 'w', encoding = 'utf-8')11         fout.write('')12         fout.write('<meta>')13         fout.write('')14         fout.write('
')15         for data in self.datas:16             fout.write('')17             fout.write('' % data['url'])18             fout.write('' % data['title'])19             fout.write('' % data['summary'])20             fout.write('')21         fout.write('
%s%s%s
')22         fout.write('')23         fout.write('')24         fout.close()

  这里也有两个注意点

    1.fout = open('output1.html', 'w', encoding = 'utf-8'),这里的encoding参数一定要加,不然会报错,在windows平台,它默认是使用gbk编码来写文件的。

    2.fout.write('

'),这里的meta标签也要加上,因为要告诉浏览器使用什么编码来渲染页面,这里我一开始没加弄了很久,我打开页面的内容,发现里面是中文的,结果浏览器展示的就是乱码。总的来说,因为整个页面采集过程结果好几个模块,所以编码问题要非常小心,不然少不留神就会出错。


  最后总结,这段程序还有许多方面可以深入探讨:

  1.页面的数据量过小,我尝试了10000个页面的爬取。一旦数据量剧增之后,就会带来一下问题,第一是待爬取url和已爬取url就不能放在set集合中了,要么放到radi缓存服务器里,要么放到mysql数据库中

  2.第二,数据也是同样的,字典也满足不了了,需要专门的数据库来存放

  3.第三量上去之后,对爬取效率就有要求了,那么多线程就要加进来

  4.第四,一旦布置好任务,单台服务器的压力会过大,而且一旦宕机,风险很大,所以分布式的高可用架构也要跟上来

  5.一方面是页面的内容过于简单,都是静态页面,不涉及登录,也不涉及ajax动态获取

  6.这只是数据采集,后续还有建模,分析…………

综上所述,路还远的很呢,加油!


相关文章

PHP速学视频免费教程(入门到精通)
PHP速学视频免费教程(入门到精通)

PHP怎么学习?PHP怎么入门?PHP在哪学?PHP怎么学才快?不用担心,这里为大家提供了PHP速学教程(入门到精通),有需要的小伙伴保存下载就能学习啦!

下载

相关标签:

python 爬虫

本站声明:本文内容由网友自发贡献,版权归原作者所有,本站不承担相应法律责任。如您发现有涉嫌抄袭侵权的内容,请联系admin@php.cn

相关专题

更多
Navicat创建数据库教程
Navicat创建数据库教程

本专题整理Navicat创建数据库相关教程,介绍新建前的准备、基础设置和创建后的检查方法。内容兼顾入门学习及实际使用需求,帮助用户了解不同数据库类型下的操作差异,为后续建表、保存数据和日常管理提供参考。

2026.11.20

20

7

Navicat入门教程大全
Navicat入门教程大全

本专题整理Navicat入门教程,从认识软件界面到开展数据库操作,介绍初次使用需要了解的知识和方法。内容兼顾连接配置、数据管理及日常使用中的疑问,方便用户按学习进度查阅,为后续实践和独立操作打好基础。

2026.11.20

20

17

Navicat数据库连接配置指南
Navicat数据库连接配置指南

从确认数据库信息到建立可用连接,本专题串联Navicat连接数据库的相关知识和操作方法。既有初次配置时需要了解的基础内容,也有连接后的检查思路,方便用户按实际需求查阅教程,逐步熟悉数据库连接的设置流程。

2026.11.20

0

10

PHP8.6数组与数据处理教程
PHP8.6数组与数据处理教程

本专题汇总PHP8.6数组与数据处理教程,涵盖CSV读取和导出、引用遍历删除、array_filter回调模式、配置键名冲突、pathinfo文件名校验、GMP大整数进制转换及UTF-8正则筛选,说明升级兼容变化、输入范围和失败处理方法。

2026.11.20

60

8

PHP8.6升级迁移教程
PHP8.6升级迁移教程

本专题汇总PHP8.6升级迁移与弃用接口改造教程,涵盖反射调用、对象属性赋值、标识符更名、构造函数与__debugInfo调整,以及插件类名检查、常量导出、ArrayIterator排序、SPL和DTO查询参数转换,帮助梳理弃用提示并完成代码兼容改造。

2026.11.20

0

10

PHP8.6安装配置与FPM运维教程
PHP8.6安装配置与FPM运维教程

本专题汇总PHP8.6正式版安装部署与FPM运维教程,涵盖Linux并存安装、独立ini配置、扩展重新编译、Nginx切换与回滚、FPM状态监控和慢日志排查,以及环境变量、请求超时、OPcache刷新和预加载配置。

2026.11.20

40

10

Nginx CVE-2026-123007排查与防护指南

Nginx HTTP/2漏洞该怎么修复?本专题围绕CVE-2026-123007,介绍安全版本升级、模块兼容检查和配置恢复方法,以及日志排查、权限设置等后续加固操作,方便你按实际部署情况查找对应教程。

2026.11.20

40

8

GoFrame框架Web开发与路由中间件

本专题聚焦GoFrame框架的Web开发,拆解路由注册与匹配规则、请求参数获取、参数校验与中间件执行顺序,说明统一响应、JWT鉴权、文件上传与接口文档生成的落地方式,并补充优雅重启与测试实践。

2026.11.17

80

15

GoFrame框架安装与gf命令行工具
GoFrame框架安装与gf命令行工具

本专题围绕GoFrame框架的安装与工具链配置展开,讲清Go版本要求、gf命令行的安装方式、代理镜像与依赖准备,说明项目初始化、热编译、交叉编译打包的做法,并整理安装阶段的常见报错与验证步骤。

2026.11.17

100

15

热门下载

更多
网站特效
/
网站源码
/
网站素材
/
前端模板

精品课程

更多
相关推荐
/
热门推荐
/
最新课程