






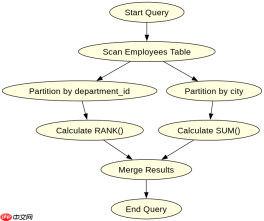
在sql中无法在一个窗口函数调用里同时使用多个不同的partition by子句,因为每个窗口函数的定义是独立的。要实现基于不同维度的并行计算,必须为每个维度编写单独的窗口函数,并在同一select语句中并列执行。例如,若需同时按部门统计员工薪资排名和按城市统计累计薪资,只需在同一查询中分别定义两个窗口函数即可。

如何按不同维度并行计算排名与累计值
通过在同一SELECT列表中声明多个窗口函数,可以基于不同的PARTITION BY条件独立计算结果。每个窗口函数拥有自己的OVER子句,互不干扰。这种写法避免了自连接或子查询的性能损耗,直接利用数据库的窗口计算引擎并行处理数据。
SELECT
    employee_id,
    department_id,
    city,
    salary,
    RANK() OVER (PARTITION BY department_id ORDER BY salary DESC) AS dept_rank,
    SUM(salary) OVER (PARTITION BY city ORDER BY employee_id ROWS UNBOUNDED PRECEDING) AS city_cumulative_salary
FROM employees;
上述代码中,dept_rank 仅依据 department_id 进行分组排序,而 city_cumulative_salary 仅依据 city 进行分组累加。两者共享同一行数据源,但计算逻辑完全隔离。执行时,数据库会分别为这两个窗口操作构建内存结构,最终合并输出。这种方式比先按部门聚合再按城市聚合的子查询更高效,因为它只扫描一次基表。
如何处理多窗口函数中的空值与默认行为
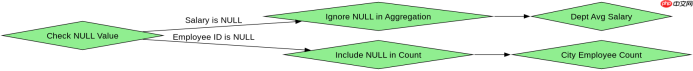
当多个窗口函数同时存在时,空值(NULL)的处理遵循各自窗口函数的默认规则,不会相互影响。例如,RANK() 遇到相同值会跳过后续排名,而 SUM() 遇到空值会忽略该值并继续累加。若某一行在某个分区内无数据,对应窗口函数返回NULL。开发者需注意,不同窗口函数的默认帧(Frame)可能不同,RANK() 默认为全部分区,而 SUM() 若未指定帧则默认为全部分区,但若指定了 ROWS 则仅作用于指定范围。因此,明确指定帧边界可避免意外结果。

SELECT
    employee_id,
    department_id,
    city,
    salary,
    AVG(salary) OVER (PARTITION BY department_id) AS dept_avg_salary,
    COUNT(*) OVER (PARTITION BY city) AS city_employee_count
FROM employees;
-- 预期结果:
-- 若某员工salary为NULL,dept_avg_salary会忽略该NULL值计算平均值;
-- city_employee_count统计的是非NULL的员工ID数量,若employee_id为NULL则不计入。
在上述示例中,dept_avg_salary 计算部门内所有非空薪资的平均值,而 city_employee_count 统计城市内非空员工ID的数量。若 salary 为NULL,AVG() 会将其排除,而 COUNT(*) 会统计该行。这种差异源于各聚合函数的内部实现。开发者应根据业务需求选择是否过滤空值,或在窗口函数前使用 COALESCE() 预处理数据。此外,若某城市无员工,city_employee_count 将返回0,而 dept_avg_salary 若无部门数据则返回NULL。这些行为均符合SQL标准,无需额外处理。
基于程序中某个输入、条件或结果的具体问题
当输入数据中存在重复的 department_id 和 city 组合时,多个窗口函数的计算结果是否会相互覆盖?答案是不会。每个窗口函数独立维护其分区状态,即使分区键相同,只要PARTITION BY条件不同,计算结果就不会冲突。例如,若 department_id 和 city 在某些行上相同,dept_rank 和 city_cumulative_salary 仍会分别基于各自的分区逻辑计算,最终结果并存于同一行。这种独立性确保了复杂分析的可扩展性,开发者可自由添加任意数量的窗口函数,无需担心状态污染。


