






javascript 代码覆盖率多环境合并的核心做法是收集各环境的原始覆盖率数据,通过工具统一解析为 json 格式后,按文件路径进行逻辑或(or)聚合,最终生成一份包含所有环境覆盖信息的完整报告。具体实现时,通常利用 istanbul 库提供的 api 读取各个环境的 .json 覆盖率文件,遍历其中的文件键值对,将不同环境下的覆盖状态合并到一个新的对象中,确保只要任一环境覆盖了某行代码,该结果即为已覆盖。

如何配置测试以输出独立的覆盖率文件
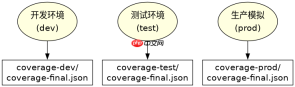
要实现多环境合并,第一步是让每个运行环境都能独立生成标准的覆盖率数据文件。在使用 Jest 等现代测试框架时,可以通过配置 collectCoverageFrom 和 coverageReporters 来指定输出格式。关键在于设置 coverageDirectory 或使用自定义脚本在每次测试运行后保存结果,确保每个环境(如开发、测试、生产模拟)的数据被隔离存储,例如分别保存在 coverage-dev/ 和 coverage-test/ 目录下,且文件格式必须为 JSON,以便后续程序读取。
const { execSync } = require('child_process');
const path = require('path');

// 定义不同的环境配置
const environments = ['dev', 'test'];

environments.forEach(env => {
  // 执行测试并指定输出目录
  const cmd = `jest --coverage --coverageDirectory=./coverage-${env} --json --outputFile=./coverage-${env}/results.json`;
  try {
    execSync(cmd, { stdio: 'inherit' });
    console.log(`Environment ${env} coverage generated.`);
  } catch (error) {
    console.error(`Failed to generate coverage for ${env}:`, error.message);
  }
});
上述代码展示了如何通过命令行参数控制 Jest 的输出。运行后,会在当前目录下生成对应的文件夹,其中包含 lcov.info 和 coverage-final.json 等文件。这些 JSON 文件包含了详细的行、分支覆盖信息,是多环境合并的基础数据源。开发者需要确保测试脚本能正确捕获这些文件,而不是仅依赖控制台输出。
如何使用 Node.js 脚本合并多个覆盖率 JSON 文件
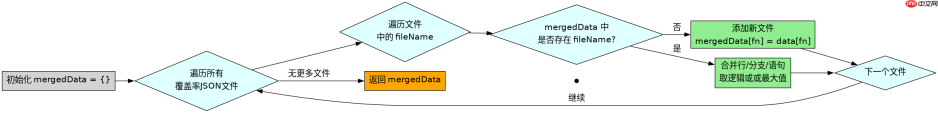
获取到各环境的 JSON 文件后,编写一个 Node.js 脚本来执行合并逻辑是最灵活的方式。该脚本需要读取所有生成的 coverage-final.json 文件,初始化一个空的总覆盖率对象,然后逐个处理每个文件中的文件路径及其对应的覆盖详情。对于每一行代码,如果当前环境未覆盖但之前环境已覆盖,则保留已覆盖状态;反之亦然。这种逻辑确保了合并后的覆盖率反映的是“至少在一个环境中被测试过”的代码范围。

使用 Husky 将 pre-commit、pre-push 和 commit-msg 检查集成到仓库中,以便代理和开发人员在更改离开工作站之前运行相同的本地防护措施。
const fs = require('fs');
const path = require('path');

function mergeCoverageFiles(filePaths) {
  const mergedData = {};

  filePaths.forEach(filePath => {
    const content = fs.readFileSync(filePath, 'utf8');
    const data = JSON.parse(content);

    Object.keys(data).forEach(fileName => {
      if (!mergedData[fileName]) {
        mergedData[fileName] = data[fileName];
      } else {
        // 合并行覆盖信息
        const existingLines = mergedData[fileName].l;
        const newLines = data[fileName].l;
        Object.keys(newLines).forEach(lineNum => {
          if (!existingLines[lineNum] || !existingLines[lineNum].length) {
            existingLines[lineNum] = newLines[lineNum];
          } else {
            // 如果是数组(表示多次命中),取最大值或合并计数
            if (Array.isArray(newLines[lineNum])) {
              existingLines[lineNum] = newLines[lineNum];
            } else {
              existingLines[lineNum] = Math.max(existingLines[lineNum], newLines[lineNum]);
            }
          }
        });
        // 类似地合并分支 b 和语句 s
      }
    });
  });

  return mergedData;
}

// 使用示例
const devCoverage = './coverage-dev/coverage-final.json';
const testCoverage = './coverage-test/coverage-final.json';
const result = mergeCoverageFiles([devCoverage, testCoverage]);
fs.writeFileSync('./merged-coverage.json', JSON.stringify(result));
这段代码演示了核心的合并算法。它首先检查目标文件是否已在合并对象中,若不存在则直接赋值。若存在,则逐行比对覆盖状态。对于行覆盖(l),如果某行在原数据中为空或未覆盖,而新数据中有覆盖记录,则更新为新状态。对于分支(b)和语句(s)也采用类似的逻辑。最终输出的 merged-coverage.json 可以直接用于生成最终的 HTML 报告,从而得到一份综合的多环境覆盖率视图。
合并后的覆盖率数据如何验证其准确性
在完成合并后,验证数据的准确性至关重要。开发者应选取几个关键文件,对比合并前后的覆盖率数值。例如,如果一个函数在开发环境中未被调用,但在测试环境中被完全覆盖,那么合并后的结果应显示该函数为 100% 覆盖。可以通过编写简单的断言脚本来检查特定文件的行覆盖率总和是否与预期一致。此外,还可以将合并后的 JSON 文件输入到 Istanbul 的 nyc report 命令中,生成 HTML 报告,人工抽查报告中显示的覆盖颜色是否与预期相符,确保没有遗漏或错误标记。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南





