






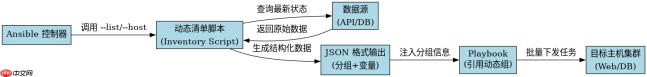
ansible 清单配置动态分组批量管理的核心做法是编写可执行的 inventory plugin 脚本或使用支持动态输出的 inventory script,使其在运行时输出符合 json 格式的资产数据。调用时需在 `ansible.cfg` 或主机清单文件中指定该插件,并配合 `groups` 字段定义逻辑分组,从而实现对服务器资产的自动化发现与分类。
如何编写符合规范的动态清单脚本
动态清单脚本必须是一个可执行文件,当被 Ansible 调用时,它需要接收一个参数来区分当前请求是获取所有变量(`--list`)还是获取特定主机的变量(`--host
{
  "_meta": {
    "hostvars": {
      "192.168.1.10": {
        "ansible_user": "root"
      }
    }
  },
  "webservers": [
    "192.168.1.10"
  ],
  "dbservers": [
    "192.168.1.20"
  ]
}
上述 JSON 结构展示了最基础的动态清单格式。其中 `_meta` 部分用于存放每个主机的特定变量,例如 SSH 登录用户;而顶层的键如 `webservers` 和 `dbservers` 则直接对应 Ansible 中的分组名称,其值为包含该组内所有主机名或 IP 的列表。在实际开发中,可以使用 Python 的 `json` 模块构建这个字典,并通过 `sys.stdout.write` 输出。确保脚本具有执行权限且返回合法的 JSON 是关键,任何语法错误都会导致 Ansible 无法解析清单。
如何在 Playbook 中引用动态分组
一旦动态清单脚本能够正确输出分组信息,Playbook 就可以像操作静态清单一样,直接使用这些动态生成的组名进行批量任务下发。这种机制的优势在于,当底层资产发生变化(如新增一台 Web 服务器)时,只需更新清单脚本的数据源,无需修改 Playbook 代码,实现了基础设施即代码中的解耦。
- name: Deploy Nginx
  hosts: webservers
  tasks:
    - name: Install nginx
      apt: name=nginx state=present

- name: Setup MySQL
  hosts: dbservers
  tasks:
    - name: Install mysql
      apt: name=mysql-server state=present
在上面的 Playbook 示例中,`hosts` 字段直接指向了动态清单中定义的 `webservers` 和 `dbservers` 组。Ansible 在执行前会先运行清单插件获取最新的主机列表,然后将任务分发给属于这些组的所有目标主机。这种方式特别适用于弹性伸缩的云环境,因为每次执行 Playbook 时,清单都是实时计算的,确保了管理的准确性。
动态分组如何处理主机变量冲突
在使用动态分组时,如果同一个主机同时出现在多个组中,或者在 `_meta` 中定义的变量与全局变量发生冲突,Ansible 会依据特定的优先级规则进行处理。通常情况下,主机级别的变量(Host Vars)优先级高于组级别的变量(Group Vars),而显式定义的变量又高于默认值。理解这一机制对于排查配置覆盖问题至关重要。
假设主机 `192.168.1.10` 既属于 `webservers` 组,又属于 `dbservers` 组,且在 `_meta` 中指定了 `ansible_user: root`。如果在 `webservers` 组的 `group_vars` 中定义了 `ansible_user: deploy`,Ansible 在执行针对该主机的任务时,会优先使用 `_meta` 中提供的 `root`,因为主机级变量的权重更高。若未在 `_meta` 中指定,则会回退到组变量。开发者应确保在动态脚本中明确为每个主机提供必要的连接变量,以避免因依赖隐式组变量而导致的连接失败。











