






Nginx 代理超时怎么配置负载均衡探测超时
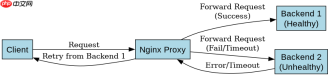
在 nginx 中,所谓的“负载均衡探测”通常指的是后端服务器健康检查机制。对于标准的 http/https 反向代理(`proxy_pass`),nginx 默认并不主动发送独立的探测请求,而是通过“被动式”的健康检查来工作:即当客户端的请求被转发到后端服务器时,如果连接建立失败或读取响应超时,nginx 会将该后端标记为不可用,并在后续一段时间内不再向其分发流量。要实现更精细的“主动探测”,通常需要借助第三方模块(如 `nginx_upstream_check_module`)或在应用层实现。这里我们主要讨论如何通过配置代理超时参数来控制这种被动探测的行为,以及如何在特定场景下模拟主动探测。
如何配置 proxy_connect_timeout 和 proxy_read_timeout
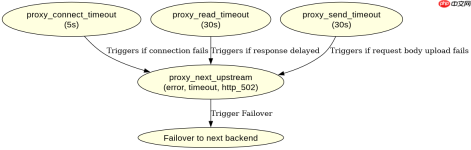
要控制 Nginx 与后端服务器之间的通信超时,你需要配置 `proxy_connect_timeout` 和 `proxy_read_timeout`。前者定义 Nginx 尝试与后端建立 TCP 连接的等待时间,后者定义 Nginx 等待后端返回完整响应的最长时间。这两个参数直接决定了“探测”失败的判定标准。例如,设置 `proxy_connect_timeout 5s;` 意味着如果 Nginx 在 5 秒内无法连接到后端,它将认为该次探测失败并切换至其他后端节点。
server {
    listen 80;
    server_name example.com;

    upstream backend_pool {
        server 192.168.1.10:8080;
        server 192.168.1.11:8080;
        # 注意:标准 Nginx 开源版不支持 active health check
        # 这里仅展示被动探测相关的超时配置
    }

    location / {
        proxy_pass http://backend_pool;

        # 连接超时:Nginx 与后端建立连接的等待时间
        proxy_connect_timeout 5s;

        # 读取超时:等待后端返回数据的最大时间
        proxy_read_timeout 30s;

        # 发送超时:向后端发送请求体的最大时间
        proxy_send_timeout 30s;

        # 错误重试策略:当后端返回 502/504 等错误时,最多重试 2 次
        proxy_next_upstream error timeout invalid_header http_502 http_504;
        proxy_next_upstream_tries 2;
    }
}
在上述配置中,`proxy_next_upstream` 是关键指令。它定义了哪些情况被视为“探测失败”并触发故障转移。常见的值包括 `error`(连接错误或超时)、`timeout`(读取或发送超时)、`invalid_header`(无效响应头)以及特定的 HTTP 状态码如 `http_502` 或 `http_504`。通过调整这些超时时间和错误类型,你可以精确控制 Nginx 对后端健康状况的判断逻辑。
如何实现主动健康检查(Active Health Check)
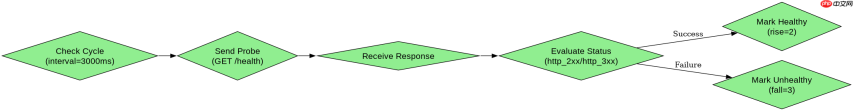
如果需要真正的主动探测,即 Nginx 定期向所有后端发送测试请求以确认其可用性,而不依赖客户端流量,则需要使用第三方模块。最常用的是 `nginx_upstream_check_module`。该模块允许你配置 `check` 指令,指定探测间隔、超时时间和失败阈值。例如,每 3 秒向每个后端发送一次 HTTP GET 请求,如果连续 2 次失败,则将该后端从池中移除。

# 假设已编译安装了 nginx_upstream_check_module
upstream backend_pool {
    server 192.168.1.10:8080;
    server 192.168.1.11:8080;

    # 主动健康检查配置
    check interval=3000 rise=2 fall=3 timeout=1000 type=http;
    check_http_send "GET /health HTTP/1.0\r\n\r\n";
    check_http_expect_alive http_2xx http_3xx;
}

server {
    listen 80;
    server_name example.com;

    location / {
        proxy_pass http://backend_pool;
    }

    # 暴露健康检查状态页面
    location /nginx_status {
        stub_status on;
        allow 127.0.0.1;
        deny all;
    }
}
在这个配置中,`interval=3000` 表示每 3000 毫秒(3 秒)执行一次检查。`rise=2` 表示后端需要连续成功响应 2 次才能被重新加入可用池。`fall=3` 表示连续失败 3 次后被标记为宕机。`timeout=1000` 是单次检查的超时时间。`check_http_send` 定义了发送的探测请求内容,这里是一个简单的 GET 请求到 `/health` 路径。`check_http_expect_alive` 指定了哪些 HTTP 状态码被视为成功。这种主动探测方式能更早地发现后端服务异常,避免将流量发送到已知不可用的节点。
基于 proxy_next_upstream 中 http_502 条件的具体行为分析
当 `proxy_next_upstream` 中包含 `http_502` 时,Nginx 的行为是:如果后端服务器返回了 502 Bad Gateway 状态码,Nginx 会立即将该请求视为“探测失败”,并根据 `proxy_next_upstream_tries` 的设置,尝试将请求转发给下一个可用的后端服务器。这不同于连接超时,因为连接已经成功建立,但业务逻辑可能出错。例如,如果后端应用崩溃但进程仍在运行,可能会返回 502。此时,Nginx 不会等待 `proxy_read_timeout` 结束,而是立即触发故障转移。这种机制确保了即使后端部分功能异常,只要还有其他健康节点,用户请求仍能得到处理。需要注意的是,如果所有后端都返回 502,且重试次数耗尽,Nginx 最终会向客户端返回 502 错误。


