






在c#中忽略大小写比较字符串时,不建议先转小写是因为这会分配新的内存对象并增加gc压力,且无法正确处理所有文化(culture)下的特殊字符映射。正确的做法是使用 string.equals 方法配合 stringcomparison.ordinalignorecase 参数,或者使用 string.equals 的静态重载,这样既避免了额外的内存分配,又能保证跨文化的正确性。

为什么转小写会导致性能下降和内存浪费?
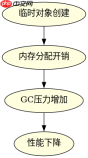
将字符串转换为小写会创建一个新的字符串实例,这在频繁调用或处理长字符串时会显著增加垃圾回收(GC)的压力。此外,如果原始字符串不需要被修改,这种临时对象的创建是纯粹的资源浪费。
using System;

public class Program
{
    public static void Main()
    {
        string original = "Hello World";

        // 不推荐:创建新字符串
        string lowerOriginal = original.ToLower();
        string target = "hello world";
        bool isEqual = lowerOriginal == target;

        Console.WriteLine($"Lowercase result: {lowerOriginal}");
        Console.WriteLine($"Is equal: {isEqual}");
    }
}
上述代码中,ToLower() 会生成一个新的字符串对象 lowerOriginal。虽然逻辑上可行,但在高并发或大数据量场景下,这种模式会导致内存碎片化和GC频率上升。
使用 StringComparison.OrdinalIgnoreCase 的优势是什么?
使用 StringComparison.OrdinalIgnoreCase 可以直接在比较过程中进行逐字符的忽略大小写比对,而不需要预先转换整个字符串。这种方式不仅性能更高,而且对于ASCII字符集来说,它通过简单的位运算(如异或第5位)来实现忽略大小写,效率极高。


using System;

public class Program
{
    public static void Main()
    {
        string str1 = "Hello World";
        string str2 = "hello world";

        // 推荐:直接比较,无额外内存分配
        bool isEqual = string.Equals(str1, str2, StringComparison.OrdinalIgnoreCase);

        Console.WriteLine($"Is equal using OrdinalIgnoreCase: {isEqual}");
    }
}
在这个例子中,string.Equals 方法内部直接处理了大小写差异,没有创建任何中间字符串对象。这是微软官方推荐的忽略大小写比较方式,尤其适用于标识符、文件名等对文化不敏感的场景。
在处理特定文化(如土耳其语)时需要注意什么?
当涉及到特定文化(如土耳其语)时,大小写转换规则可能与标准ASCII不同。例如,土耳其语中的 'I' 转小写是 'ı'(无点i),而 'i' 转大写是 'İ'(有点I)。如果使用 OrdinalIgnoreCase,它会忽略这些文化特定的规则,始终基于Unicode码点进行简单的大小写匹配。如果需要遵循特定文化的规则,应使用 StringComparison.CurrentCultureIgnoreCase 或 StringComparison.InvariantCultureIgnoreCase。









