






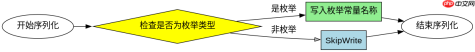
java 枚举序列化具有特殊性,其核心在于反序列化时不创建新对象,而是通过反射查找并返回已存在的枚举常量。具体做法是调用 enum.valueof() 方法,根据反序列化数据中的类名和常量名称匹配现有的枚举实例。这样做确保了枚举单例模式的完整性,防止因反序列化产生重复的枚举对象。
readResolve() 在枚举中是否生效
readResolve() 方法在枚举序列化中不会生效。因为枚举的反序列化机制由 JVM 底层直接处理,它绕过标准的反序列化流程,直接通过 valueOf 获取现有实例,所以自定义的 readResolve() 不会被调用。

import java.io.*;

public class EnumSerializationTest {
    public enum Status {
        ACTIVE, INACTIVE;

        // 此方法在枚举反序列化时不会被调用
        protected Object readResolve() throws ObjectStreamException {
            return ACTIVE; // 试图替换为其他值
        }
    }

    public static void main(String[] args) throws Exception {
        // 序列化
        ByteArrayOutputStream baos = new ByteArrayOutputStream();
        ObjectOutputStream oos = new ObjectOutputStream(baos);
        oos.writeObject(Status.ACTIVE);
        oos.close();

        // 反序列化
        ByteArrayInputStream bais = new ByteArrayInputStream(baos.toByteArray());
        ObjectInputStream ois = new ObjectInputStream(bais);
        Status status = (Status) ois.readObject();

        // 验证:仍然是 ACTIVE,且不是 readResolve 返回的对象(如果存在的话)
        System.out.println(status == Status.ACTIVE); // true
        System.out.println(status.name()); // ACTIVE
    }
}
枚举序列化后的字节流特征
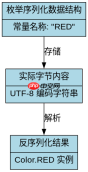
枚举序列化后的字节流非常简洁,只包含枚举常量的名称字符串,而不包含任何字段数据。这是因为枚举常量是静态的、不可变的,其状态在编译时就已确定,无需在运行时保存额外信息。

FilePond 灵活的 JavaScript 文件上传库
下载
FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
import java.io.*;
import java.util.Arrays;

public class EnumByteStreamTest {
    public enum Color {
        RED, GREEN, BLUE;
    }

    public static void main(String[] args) throws Exception {
        ByteArrayOutputStream baos = new ByteArrayOutputStream();
        ObjectOutputStream oos = new ObjectOutputStream(baos);
        oos.writeObject(Color.RED);
        oos.close();

        byte[] bytes = baos.toByteArray();
        System.out.println(Arrays.toString(bytes));
        // 输出示例: [AC ED 00 05 74 00 04 52 45 44]
        // 其中 74 00 04 52 45 44 对应 "RED" 的 UTF-8 编码
    }
}
基于枚举常量名称的具体问题
当枚举常量名称中包含特殊字符或空格时,序列化依然能正常工作,但反序列化时必须严格匹配名称。例如,如果枚举定义为 VALUE_ONE,则字节流中存储的是 VALUE_ONE,任何拼写错误都会导致 IllegalArgumentException。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


