






通过自定义异常类携带结构化业务数据,并在统一入口捕获后统计堆栈或错误码,可以精准定位高频错误。具体做法是定义包含错误类型、上下文id和详细信息的字段,在业务逻辑中抛出实例,由全局异常处理器收集并聚合这些指标。这样能直接区分偶发故障与系统性问题,无需依赖日志文本挖掘。

BusinessException 如何设计以支持高频错误统计
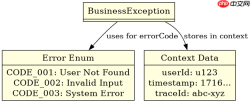
自定义异常应继承 RuntimeException 并封装关键统计维度,如错误码、用户ID和业务状态。设计时需确保所有必要信息在构造时即确定,避免运行时动态获取导致性能损耗或数据丢失。通过枚举定义标准错误码,可保证统计口径的一致性,便于后续按码聚合分析。
public class BusinessException extends RuntimeException {
    private final String errorCode;
    private final String userId;
    private final Map<string object> context;

    public BusinessException(String errorCode, String userId, Map<string object> context) {
        super(errorCode);
        this.errorCode = errorCode;
        this.userId = userId;
        this.context = context != null ? context : new HashMap();
    }

    public String getErrorCode() { return errorCode; }
    public String getUserId() { return userId; }
    public Map<string object> getContext() { return context; }
}</string></string></string>
上述代码定义了基础异常结构,包含错误码、用户标识和扩展上下文。在实际使用中,业务层只需实例化该异常并传入对应参数,即可将结构化数据随异常抛出。这种设计使得上层处理器能直接提取统计所需字段,无需解析堆栈或消息文本。
全局异常处理器如何实现高频错误聚合
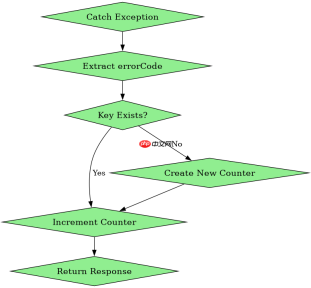
利用 Spring Boot 的 @ControllerAdvice 或 @RestControllerAdvice 拦截自定义异常,并在内存或外部存储中累加错误计数。实现时需关注线程安全,使用 ConcurrentHashMap 或原子计数器记录各错误码的出现频次。同时应设置过期策略或阈值,防止内存无限增长,并定期导出统计结果供分析。

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
@RestControllerAdvice
public class GlobalExceptionHandler {
    private final ConcurrentHashMap<string atomicinteger> errorCounts = new ConcurrentHashMap();

    @ExceptionHandler(BusinessException.class)
    public ResponseEntity<string> handleBusinessException(BusinessException ex) {
        String code = ex.getErrorCode();
        errorCounts.computeIfAbsent(code, k -> new AtomicInteger(0)).incrementAndGet();
        // 实际项目中应发送指标到监控系统如 Prometheus 或 ELK
        return ResponseEntity.status(HttpStatus.BAD_REQUEST).body("Error: " + code);
    }

    public Map<string integer> getTopErrors(int limit) {
        return errorCounts.entrySet().stream()
                .sorted(Map.Entry.<string atomicinteger>comparingByValue(Comparator.reverseOrder()))
                .limit(limit)
                .collect(Collectors.toMap(Map.Entry::getKey, e -> e.getValue().get(), (a, b) -> a, LinkedHashMap::new));
    }
}</string></string></string></string>
该处理器在捕获异常后更新内部计数器,并提供方法获取高频错误列表。开发者可通过调用 getTopErrors() 实时查看当前系统中最常发生的错误类型。结合定时任务将数据持久化,即可形成完整的高频错误趋势图,辅助快速定位瓶颈。
当 userId 为空时异常统计会丢失哪些关键信息
若 BusinessException 中的 userId 字段允许为 null,则按用户维度的错误分布统计将不完整。这会导致无法识别特定用户的集中性故障,例如某用户因配置错误反复触发同一异常,但在全局统计中被稀释。此外,缺乏用户标识也使得复现问题和关联日志变得困难,降低排查效率。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


