






使用 mod 函数结合行号或主键可以对结果集进行奇偶行筛选标记。具体做法是先通过窗口函数 row_number() 生成连续的行号,然后对行号应用 mod(row_number, 2):结果为 1 表示奇数行,结果为 0 表示偶数行。若数据量极大且主键为自增整数,也可直接对主键取模,但需注意主键不连续时的间隙问题。

如何基于 ROW_NUMBER 实现通用的奇偶标记?
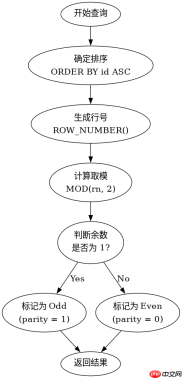
在大多数关系型数据库中,最稳健的方法是使用 ROW_NUMBER() 窗口函数。该函数会为查询结果集中的每一行分配一个唯一的整数序号,从 1 开始。接着,利用 MOD 函数计算该行号除以 2 的余数。当余数为 1 时,该行即为奇数行;当余数为 0 时,该行即为偶数行。这种方法不依赖于底层数据的物理存储顺序或主键特性,仅取决于 SQL 语句中 ORDER BY 子句定义的逻辑顺序,因此具有高度的可移植性和准确性。
SELECT
    id,
    name,
    ROW_NUMBER() OVER (ORDER BY id) AS rn,
    MOD(ROW_NUMBER() OVER (ORDER BY id), 2) AS parity_flag
FROM employees;
上述代码中,employees 表包含 id 和 name 字段。执行后,rn 列将显示 1, 2, 3... 的序列,而 parity_flag 列将交替显示 1 和 0。开发者可以直接在外部应用层过滤 parity_flag = 1 的数据,或者在 SQL 中使用 CASE 表达式将其转换为更直观的字符串标记,例如 CASE WHEN MOD(...) = 1 THEN 'Odd' ELSE 'Even' END。
直接对自增主键取模有何风险与适用场景?
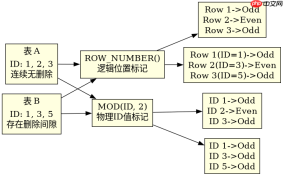
如果表的主键是严格自增且无删除操作的整数类型(如 MySQL 的 AUTO_INCREMENT),可以直接对主键列使用 MOD(id, 2)。这种方式避免了窗口函数的计算开销,在某些大数据量场景下可能略快。然而,其核心风险在于“数据间隙”。如果历史数据中存在删除操作,或者主键并非从 1 开始连续递增,那么 MOD(id, 2) 的结果将与行的实际物理顺序或逻辑顺序脱节。例如,ID 为 1, 3, 5 的行会被标记为奇数,但如果业务逻辑期望的是“查询结果中的第 1、3、5 行”,则此方法失效。因此,它仅适用于对绝对 ID 值敏感而非相对位置敏感的场景,或者在确认数据完全连续且无删除的情况下使用。
SELECT
    id,
    name,
    MOD(id, 2) AS id_parity
FROM employees
WHERE MOD(id, 2) = 1; -- 筛选 ID 为奇数的记录
对比第一种方法,这里直接使用 id 列。假设表中只有 ID 为 101, 102, 103 的记录,MOD(101, 2) 为 1,MOD(102, 2) 为 0。如果之前删除了 ID 为 100 的记录,导致当前查询结果的第一行 ID 是 101,虽然它在结果集中是“第 1 行”(奇数位),但其 ID 也是奇数,此时巧合一致。但若删除了 ID 为 101 的记录,第一行变为 ID 102(偶数 ID),它在结果集中却是“第 1 行”(奇数位),此时 MOD(id, 2) 返回 0,与逻辑位置不符。因此,除非明确需要按 ID 值的奇偶性筛选,否则应优先使用 ROW_NUMBER() 方案。
当使用 ROW_NUMBER 时,ORDER BY 子句如何影响奇偶标记结果?
在使用 ROW_NUMBER() 进行奇偶标记时,ORDER BY 子句决定了行的编号顺序,从而直接决定了哪一行被标记为奇数或偶数。如果没有 ORDER BY,数据库返回行的顺序是不确定的,导致 ROW_NUMBER() 的值随机变化,奇偶标记也随之不可预测。例如,对于同一组数据,一次查询可能将 A 员工标记为奇数行,另一次查询可能将其标记为偶数行。因此,必须显式指定 ORDER BY 以确保排序的稳定性。常见的做法是按主键升序排列,以保证每次查询结果一致。如果业务需求是“每隔一行插入空行”或“交错显示”,则需根据具体的排序逻辑来调整 ORDER BY 的字段,确保奇偶分组符合预期的业务展示规则。


