






在递归函数中处理变量声明,核心原则是区分需要跨层级共享的“状态”和仅在当前层级有效的“局部数据”。对于累加器、路径记录等需要随调用栈传递并累积的数据,应将其作为参数传入;对于仅用于当前层计算且不影响其他分支的临时变量,直接在函数体内使用 let 或 const 声明。这样能避免闭包陷阱和意外的状态污染,确保每个递归分支拥有独立的作用域。

如何正确传递累加器以避免状态污染
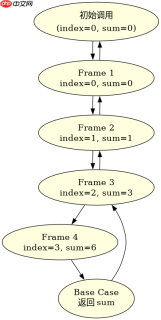
当递归过程需要累积结果(如求和、计数)时,必须将累加器作为参数传入,而不是依赖外部变量。如果在函数外部定义累加器并在递归中修改它,所有递归分支将共享同一个引用,导致结果错误。正确的做法是将初始值作为默认参数或在首次调用时传入,每次递归调用时传入新的累加器值。
function sumArray(arr, index = 0, currentSum = 0) {
    if (index === arr.length) return currentSum;
    return sumArray(arr, index + 1, currentSum + arr[index]);
}
console.log(sumArray([1, 2, 3])); // 输出: 6
上述代码展示了尾递归形式的求和。每次调用 sumArray 时,currentSum 都会基于上一层的值进行更新。由于 JavaScript 引擎通常不强制优化尾递归,这种写法主要保证了逻辑上的状态隔离。如果改用外部变量,例如在函数外定义 let total = 0 并在内部执行 total += arr[index],则无法支持多次调用或并行递归,因为 total 会被反复重置或覆盖。
如何在递归中管理局部临时变量
对于不需要传递给子节点的中间计算结果,应在函数体内部使用 let 或 const 声明。这些变量属于当前调用帧,递归返回时自动销毁。在处理树形结构或图遍历算法时,常用于存储当前节点的邻居列表、临时路径或标志位。关键在于不要将这些变量提升到函数作用域之外,也不要通过参数传递它们,除非它们确实需要被子节点访问。

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
function findMaxNode(node) {
    if (!node) return -Infinity;
    const leftMax = findMaxNode(node.left);
    const rightMax = findMaxNode(node.right);
    const currentMax = Math.max(leftMax, rightMax, node.value);
    return currentMax;
}
// 假设 node 是一个二叉树节点对象
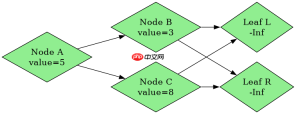
在这个二叉树最大值查找的例子中,leftMax、rightMax 和 currentMax 都是局部变量。每个递归调用都会创建自己的副本。如果错误地将 currentMax 定义为全局变量或闭包变量,不同分支的计算结果会相互干扰。例如,左子树的最大值可能会意外地覆盖右子树的比较基准。通过局部声明,确保了每个节点的计算只依赖于其直接子节点的返回值,符合分治法的逻辑。
递归深度过大时如何处理内存中的变量堆积
JavaScript 的调用栈大小有限,深层递归会导致 Maximum call stack size exceeded 错误。虽然变量声明本身不直接决定栈溢出,但大量局部变量的累积会增加每层调用帧的大小。对于极深的递归,建议将递归改为迭代,或使用显式栈来模拟调用过程。在必须使用递归的场景下,尽量保持每层调用的局部变量数量最少,避免在递归调用前创建大型对象或数组。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南





