






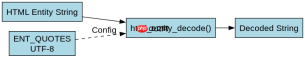
使用 html_entity_decode() 函数即可将 html 实体转回原字符。调用该函数并传入包含实体的字符串,指定 ent_quotes 标志和 utf-8 编码,即可还原双引号、单引号及所有标准实体为对应的原始文本。
html_entity_decode() 处理双引号与单引号的差异是什么
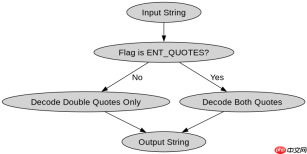
默认情况下,html_entity_decode() 仅解码双引号实体(如 "),而保留单引号实体(如 ' 或 ')不变。若需同时还原单引号,必须显式传入 ENT_QUOTES 标志。这一行为差异源于 PHP 对 HTML 规范中“属性值”与“文本内容”的区分处理逻辑。
$input = "<p>He said "Hello" & 'World'</p>";
$default_result = html_entity_decode($input, ENT_COMPAT, 'UTF-8');
// 结果: <p>He said "Hello" & 'World'</p>

$full_result = html_entity_decode($input, ENT_QUOTES, 'UTF-8');
// 结果: <p>He said "Hello" & 'World'</p>
上述代码展示了两种标志下的输出差异。在 ENT_COMPAT 模式下,双引号被还原,但单引号保持实体形式。启用 ENT_QUOTES 后,单引号也被正确转换为 ASCII 字符。开发者应根据目标场景选择是否开启此标志,避免残留未解码的实体导致后续解析错误。

如何处理自定义实体或未知实体序列
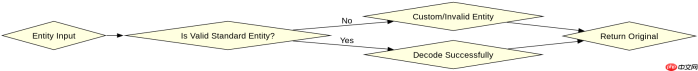
对于未在 HTML 标准中定义的自定义实体(如 &myentity;),html_entity_decode() 会原样返回该字符串,不会报错也不会替换。若输入中包含非法实体序列(如缺少分号),函数可能截断或忽略部分字符。因此,在处理不可信输入时,建议结合正则表达式预检或改用更严格的解析器。
$custom = "<div>&myentity;</div>"; $result = html_entity_decode($custom, ENT_QUOTES, 'UTF-8'); // 结果: <div>&myentity;</div> $invalid = "<span> </span>"; $result2 = html_entity_decode($invalid, ENT_QUOTES, 'UTF-8'); // 结果: <span> </span> (无变化,因非合法实体)
测试表明,自定义实体和非法序列均不会被转换。这要求开发者在接收外部数据时,不能依赖该函数进行完整性校验。若需强制清理,应配合 strip_tags() 或 DOM 解析器使用,确保最终输出的安全性与一致性。
当输入为空字符串或 null 时函数返回什么
当传入空字符串 '' 时,html_entity_decode() 返回空字符串;若传入 null,PHP 8.0+ 会抛出 Error,而早期版本可能静默返回空字符串或引发警告。因此,在不确定输入类型时,应先进行类型检查或强制转换,避免运行时异常。
$empty = '';
var_dump(html_entity_decode($empty, ENT_QUOTES, 'UTF-8')); // string(0) ""

try {
    var_dump(html_entity_decode(null, ENT_QUOTES, 'UTF-8'));
} catch (Error $e) {
    echo $e->getMessage(); // Argument #1 ($string) must be of type string
}
该行为差异提示我们在生产环境中应对输入做防御性编程。推荐使用 is_string() 判断后再调用,或对 null 做默认值填充,确保函数始终接收有效字符串参数,提升代码健壮性。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!





