






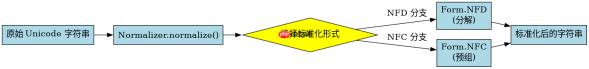
java 中处理 unicode 等价性主要依赖 java.text.normalizer 类,核心做法是先调用 normalizer.normalize(input, form) 将文本转换为特定的标准化形式(如 nfd、nfc),再结合正则表达式或字符比较来识别和消除重音等组合字符。通过指定 form.nfd 可以将预组字符分解为基字符与组合标记,而 form.nfc 则将其合并,从而确保不同书写形式的字符串在逻辑上被视为等价。
NFD 分解后如何去除重音符号?
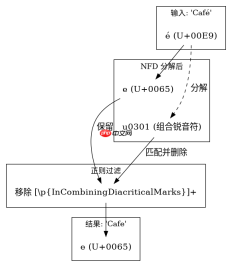
使用 Normalizer.NFD 分解文本后,可以通过正则表达式 [p{InCombiningDiacriticalMarks}]+ 匹配并移除所有组合变音符号,从而实现“去重音”效果。该操作会将带重音的字符(如 é)拆分为基本字符 e 和组合符号 u0301,随后过滤掉后者即可得到纯 ASCII 或基础字符序列。
import java.text.Normalizer;

public class Main {
    public static void main(String[] args) {
        String input = "Café résumé";
        // 1. 分解为 NFD (基字符 + 组合标记)
        String nfd = Normalizer.normalize(input, Normalizer.Form.NFD);
        // 2. 移除组合变音符号
        String clean = nfd.replaceAll("[\p{InCombiningDiacriticalMarks}]+", "");
        System.out.println(clean); // 输出: Cafe resume
    }
}
NFC 合并后如何判断两个字符串是否等价?
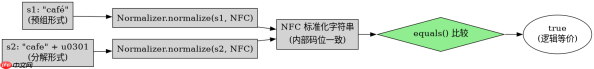
在将文本统一转换为 NFC 形式后,可以直接使用 equals() 方法比较两个字符串是否逻辑等价。因为 NFC 是预组形式,它将尽可能多的字符组合成单个码位,消除了因输入来源不同(如直接输入 vs 键盘组合输入)导致的底层码位差异。这种比较方式比逐字符比较组合标记更高效且符合直觉。

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
import java.text.Normalizer;

public class Main {
    public static void main(String[] args) {
        // 假设 s1 是直接输入的预组字符,s2 是分解后重新组合的
        String s1 = "café";
        String s2 = new StringBuilder().append("cafe").append((char)0x0301).toString();

        String nfc1 = Normalizer.normalize(s1, Normalizer.Form.NFC);
        String nfc2 = Normalizer.normalize(s2, Normalizer.Form.NFC);

        System.out.println(nfc1.equals(nfc2)); // 输出: true
    }
}
当输入包含未定义的组合序列时 normalize 会返回什么?
当输入包含无法被标准 Unicode 规则合并或分解的非法组合序列时,Normalizer.normalize 不会抛出异常,而是原样保留这些字符或进行最大程度的合法化转换。例如,如果输入中包含一个没有对应基字符的组合标记,NFC 形式下它可能保持独立或根据具体实现回退;NFD 形式下若基字符缺失,组合标记可能无法正确附着。程序应始终假设 normalize 返回的是非空字符串,并通过后续的正则或逻辑处理潜在的非标准字符。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


