






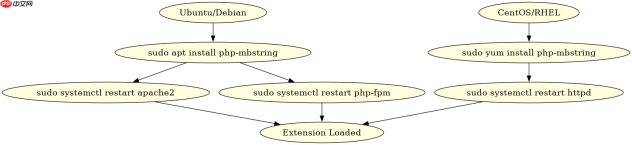
php升级后mbstring缺失导致中文截断乱码,直接启用或安装`php-mbstring`扩展即可修复。在ubuntu/debian系统中执行`sudo apt install php-mbstring`并重启web服务;在centos/rhel中执行`sudo yum install php-mbstring`。启用后,使用`mb_substr()`等函数替代原生`substr()`处理utf-8字符串,可确保按字符而非字节截取,彻底解决乱码问题。

如何确认当前环境是否加载了mbstring扩展
通过运行`php -m`命令查看已加载的模块列表,若输出中包含`mbstring`则说明扩展已启用。若未列出,需检查`php.ini`配置文件中`extension=mbstring`是否被注释,或使用包管理器安装对应版本的扩展包。安装完成后务必重启PHP-FPM或Apache/Nginx服务使配置生效。
<?php // 检查mbstring是否加载
if (extension_loaded('mbstring')) {
    echo "mbstring is loaded.";
} else {
    echo "mbstring is NOT loaded.";
}

// 验证多字节函数可用性
echo function_exists('mb_substr') ? 'Function available' : 'Function missing';
?>
上述代码将输出确认信息。若显示未加载,请根据操作系统执行相应的安装命令。例如在Ubuntu上:`sudo apt update && sudo apt install php-mbstring`,随后重启服务:`sudo systemctl restart apache2`(或`php-fpm`)。在CentOS上:`sudo yum install php-mbstring`,然后`sudo systemctl restart httpd`。安装后再次运行检查脚本,应显示已加载且函数可用。
为什么原生substr会导致中文乱码而mb_substr不会
原生`substr()`函数按字节截取字符串,而UTF-8编码的中文字符通常占用3个字节。当截取位置恰好落在中文字符的中间字节时,会产生非法字节序列,导致后续解析失败并显示乱码或截断符号。`mb_substr()`函数基于字符计数和指定的编码(如UTF-8)进行截取,能识别多字节字符边界,从而保证完整性。

使用官方Model Context Protocol PHP SDK将PHP应用程序功能暴露为MCP工具、资源和提示,用于代理工作流。

<?php $str = "Hello 世界";

// 错误用法:按字节截取,可能在第5个字节处切断“世”字
$bad_result = substr($str, 0, 5);
echo $bad_result . "\n"; // 输出: Hello � 或乱码

// 正确用法:按字符截取,第6个字符是“世”
$good_result = mb_substr($str, 0, 6, 'UTF-8');
echo $good_result . "\n"; // 输出: Hello 世

// 完整截取示例
$full_bad = substr($str, 0, 10); // 可能截断
$full_good = mb_substr($str, 0, 10, 'UTF-8'); // 安全
?>
运行上述代码可见,`substr`在第5字节处截断“世界”的“世”字,产生无效UTF-8序列,浏览器或终端显示为替换字符或乱码。而`mb_substr`指定UTF-8编码,按字符索引截取,第6个字符正是“世”,结果完整无乱码。关键区别在于:`substr`操作的是字节流,`mb_substr`操作的是字符序列。在处理任何非ASCII文本时,必须显式指定编码参数以避免默认行为不一致导致的错误。
在现有代码中将substr替换为mb_substr的具体步骤
将项目中所有涉及中文字符串截断的`substr()`调用替换为`mb_substr()`,并添加第三个参数`'UTF-8'`。同时,将`strlen()`替换为`mb_strlen()`以获取正确的字符长度,避免循环或判断逻辑出错。对于字符串拼接、查找和分割,也应分别使用`mb_strpos()`, `mb_strrpos()`, `mb_split()`等多字节版本函数,确保整个字符串处理链路的一致性。
<?php // 原代码片段
$title = "这是一个很长的标题";
$short_title = substr($title, 0, 5); // 危险!

// 修改后
$short_title = mb_substr($title, 0, 5, 'UTF-8'); // 安全

// 其他相关替换示例
$len = strlen($title);        // 返回字节数,中文每个算3
$len = mb_strlen($title, 'UTF-8'); // 返回字符数,中文每个算1

$pos = strpos($title, "长");   // 可能找不到或位置错误
$pos = mb_strpos($title, "长", 0, 'UTF-8'); // 准确定位
?>
替换时需全局搜索项目中的`substr`、`strlen`、`strpos`等函数调用,评估其输入是否包含多字节字符。若确定只处理ASCII,可保留原函数以提升性能;若包含中文或其他Unicode字符,必须迁移至`mb_*`系列函数。注意`mb_substr`比`substr`稍慢,但安全性优先。建议在重构时编写单元测试,覆盖含中文的边界情况,确保替换后行为符合预期。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!





