






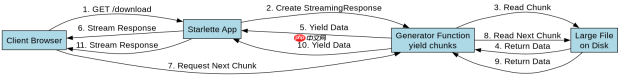
starlette处理大文件下载的核心做法是使用 streamingresponse 配合 python 的生成器(generator)或异步迭代器,通过分块读取和流式传输来避免内存溢出。开发者只需定义一个返回文件块的函数,将其作为参数传递给 streamingresponse,并设置正确的 content-type 和 content-length 响应头即可实现高效的大文件下载。
如何构建支持断点续传的文件流
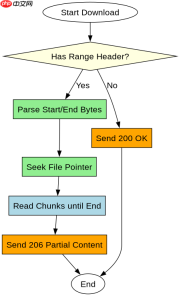
要实现更完善的下载体验,需要解析客户端请求中的 Range 头,计算字节范围,并只发送该范围内的数据。这要求代码能够根据起始偏移量定位文件指针,并按固定大小(如 64KB)循环读取直到达到结束位置。
import os
from starlette.responses import StreamingResponse, Response

def file_iterator(file_obj, chunk_size=8192):
    while True:
        data = file_obj.read(chunk_size)
        if not data:
            break
        yield data

class RangeFileResponse(StreamingResponse):
    def __init__(self, path, chunk_size=8192, **kwargs):
        self.path = path
        self.chunk_size = chunk_size
        self.file_size = os.path.getsize(path)
        super().__init__(content=self._generate(), **kwargs)

    def _generate(self):
        with open(self.path, 'rb') as f:
            # 实际应用中需在此处解析 Request.headers.get('range')
            # 此处简化为全量流式传输
            yield from file_iterator(f, self.chunk_size)

    def __iter__(self):
        return self._generate()

# 使用示例
# response = RangeFileResponse('/path/to/large_file.zip', media_type='application/octet-stream')
上述代码展示了基于 StreamingResponse 的子类实现思路。关键点在于 _generate 方法必须是一个生成器函数,每次 yield 的数据块都会立即通过网络发送给客户端,而不会在服务器端累积。对于断点续传,需要在初始化时检查 Range 头,若存在则调整文件指针至指定位置,并返回 206 Partial Content 状态码及对应的 Content-Range 头。
异步环境下大文件下载的注意事项
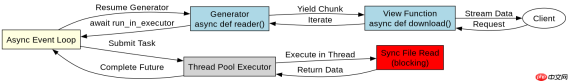
在 Starlette 的异步架构中,直接对大文件进行阻塞式的 I/O 操作会阻塞事件循环,导致其他请求无法处理。因此,必须确保文件读取操作是非阻塞的,或者将阻塞操作放入线程池中执行。通常推荐使用 anyio 或 concurrent.futures 来处理这种场景。
Starlette 1.5.1 是轻量级 Python ASGI 框架与工具集,提供路由、请求响应、中间件、WebSocket 和后台任务等组件,适合构建异步 Web 服务。本下载为官方 PyPI 通用 wheel 包,可使用 pip 安装,并由包管理器处理依赖;运行应用时还需配置 ASGI 服务器。
import anyio
from starlette.responses import StreamingResponse

async def async_file_reader(path, chunk_size=8192):
    loop = anyio.get_current_task().loop
    with open(path, 'rb') as f:
        while True:
            # 使用 run_in_executor 避免阻塞事件循环
            data = await loop.run_in_executor(None, f.read, chunk_size)
            if not data:
                break
            yield data

async def download_large_file(request):
    path = request.query_params.get('file')
    return StreamingResponse(
        content=async_file_reader(path),
        media_type='application/octet-stream'
    )
这段代码演示了如何在异步视图函数中使用 run_in_executor 包装同步的文件读取操作。虽然 StreamingResponse 本身是异步友好的,但其内部的迭代器如果包含阻塞调用,仍会影响性能。通过将 f.read() 放入线程池,可以保证主事件循环的流畅性。此外,对于超大型文件,还可以考虑结合 CDN 或对象存储(如 S3)的分片下载功能,进一步减轻应用服务器的压力。
当文件路径不存在或权限不足时会发生什么
如果在构建 StreamingResponse 时指定的文件路径无效,或者进程没有读取权限,程序会在首次尝试读取文件块时抛出异常。由于生成器是惰性求值的,错误不会在创建响应对象时立即触发,而是在客户端开始接收数据、服务器尝试从生成器获取第一个值时才暴露出来。这通常会导致连接中断或返回 500 错误。
import os
from starlette.responses import StreamingResponse

def safe_file_iterator(path, chunk_size=8192):
    try:
        if not os.path.exists(path):
            raise FileNotFoundError(f"File {path} not found")
        with open(path, 'rb') as f:
            while True:
                data = f.read(chunk_size)
                if not data:
                    break
                yield data
    except IOError as e:
        # 在实际生产中,应记录日志并可能抛出特定异常
        print(f"IO Error: {e}")
        raise

# 测试:传入不存在的文件
try:
    response = StreamingResponse(safe_file_iterator('/nonexistent/file.bin'))
    # 此时不会报错
    # 只有当客户端请求并开始消费时才会触发 FileNotFoundError
except Exception as e:
    pass
为了避免静默失败,建议在生成器内部增加前置检查。例如,在 safe_file_iterator 中先验证文件是否存在及可读。如果验证失败,直接抛出异常,这样可以在更早的阶段捕获问题。同时,Starlette 的全局异常处理器会将未处理的异常转换为标准的 HTTP 500 响应,但用户可能只会看到连接重置。因此,良好的错误处理和日志记录对于排查此类问题至关重要。









