






米哈游团队公布的gamer将游戏画面、文字指令与键鼠动作放进同一套视觉语言动作模型,目标是在实时游戏中完成持续较长的交互任务。论文于2026年11月13日提交,项目在11月17日获得进一步关注;其方法结合持续预训练、指令微调、跨上下文记忆与强化学习,而不是仅让聊天模型逐张解释截图。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
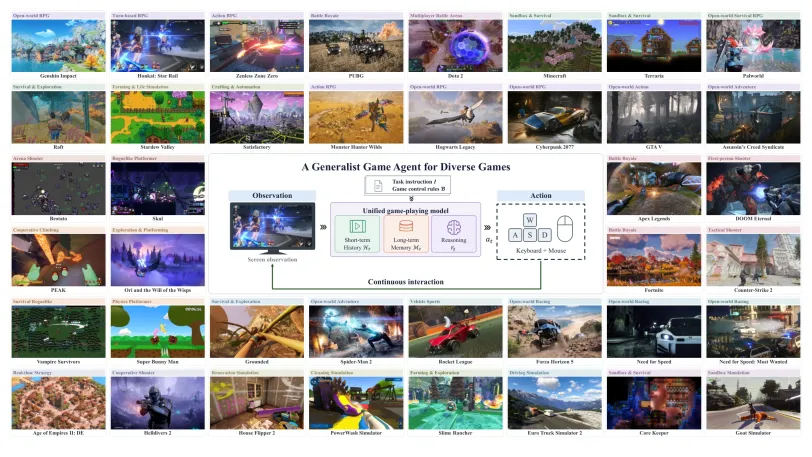
Gamer论文原图:覆盖的游戏类型与观察、记忆、推理、键鼠交互系统。
观察与控制采用不同频率
论文的实时交互设置以5Hz接收截图,以30Hz安排键盘和鼠标控制,每个200毫秒交互步包含六个动作块。模型既要理解画面中的任务状态,也要把输出落实为连续控制;较长任务则利用总结式记忆在上下文切换后保留任务线索。
训练路径先用游戏轨迹持续预训练,再通过指令微调加入稀疏推理和记忆能力,最后采用时间感知的GRPO强化学习。论文还使用按键随机重映射、针对重复片段的损失衰减等处理,降低对固定键位或重复动作的依赖。
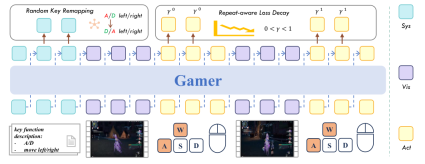
论文展示的随机按键映射与重复片段训练处理。
49.7%对应七类小游戏宏平均
在论文列出的七类小游戏测试中,基础Qwen3-VL-8B的无权重宏平均成绩为3.2%,Gamer-CPT为15.0%,Gamer-SFT为39.2%,Gamer-RL为49.7%。各小游戏的改善幅度不同,这个49.7%不能当成全部游戏、全部长任务的统一通关率。

公开研究检查点与完整Gamer要分开
项目关联的GameScaling公开检查点来自持续预训练规模研究,包含不同尺寸与训练阶段。它们有助于研究跨游戏控制,但不等同于《崩坏:星穹铁道》专项微调后的全部Gamer权重、数据或完整部署包。论文演示能力与当前公开下载范围需要分别看待。








