






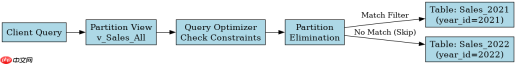
在sql server中,通过创建分区视图实现大数据水平切分的核心做法是:使用union all将多个结构相同的表(或远程服务器上的同名表)组合成一个逻辑视图,并在每个基表中定义check约束以限定数据范围。查询该视图时,优化器会根据where条件中的过滤列自动进行“分区消除”(partition elimination),只扫描相关的数据分片,从而避免全表扫描并提升查询性能。
CREATE VIEW语句需要满足哪些语法和约束条件
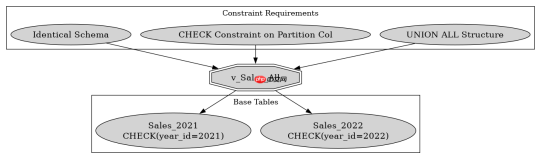
要成功创建分区视图,必须确保所有参与联合的基表具有完全相同的列定义、数据类型和顺序。最关键的限制是每个基表必须包含一个用于分区的整数列(如year_id),并且每个表上必须对该列建立CHECK约束,明确界定该表负责存储的数据范围。此外,如果涉及本地表的分区视图,通常要求这些表位于同一个数据库中;若涉及分布式分区视图(跨服务器),则需配置链接服务器并确保ANSI_NULLS和ANSI_PADDING等设置一致。
CREATE TABLE Sales_2021 (
    order_id INT PRIMARY KEY,
    year_id INT NOT NULL CHECK (year_id = 2021),
    amount DECIMAL(10,2)
);

CREATE TABLE Sales_2022 (
    order_id INT PRIMARY KEY,
    year_id INT NOT NULL CHECK (year_id = 2022),
    amount DECIMAL(10,2)
);

CREATE VIEW v_Sales_All AS
SELECT order_id, year_id, amount FROM Sales_2021
UNION ALL
SELECT order_id, year_id, amount FROM Sales_2022;
上述代码定义了两个分别存储2021年和2022年数据的表,并通过v_Sales_All视图将它们合并。注意year_id列在每个表中都有严格的CHECK约束,这是启用分区消除的前提。
查询分区视图时如何验证分区消除是否生效
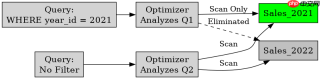
当对分区视图执行带有分区列过滤条件的SELECT查询时,SQL Server优化器会分析WHERE子句,判断哪些基表可能包含匹配数据。如果查询条件明确指向某个特定范围(例如WHERE year_id = 2021),优化器将生成仅扫描对应基表(Sales_2021)的执行计划,而完全忽略其他表。这种机制称为“分区消除”,它能显著减少I/O开销。可以通过查看执行计划(Execution Plan)来验证:如果计划中只显示单个表的Clustered Index Scan或Seek,而非所有表的联合扫描,则说明分区消除已生效。
-- 查询2021年的数据,理论上只扫描Sales_2021表
SELECT * FROM v_Sales_All WHERE year_id = 2021;

-- 查询所有数据,需扫描所有基表
SELECT * FROM v_Sales_All;
第一条查询利用year_id的约束信息,优化器知道只有Sales_2021表包含2021年的数据,因此跳过Sales_2022。第二条查询没有过滤条件,必须遍历所有分片。在实际应用中,应始终尽量在查询中包含分区列,以触发分区消除机制。
插入数据到分区视图时如何处理约束冲突
向分区视图插入数据时,用户无需指定目标基表,只需向视图插入记录。SQL Server会根据INSERT语句中提供的分区列值,结合各基表的CHECK约束,自动路由数据到正确的物理表中。如果插入的值不符合任何现有表的约束范围(例如插入year_id = 2023但尚无对应表),数据库引擎将返回错误,提示无法找到合适的目标表。此时,管理员需要先创建新的分区表并更新视图定义,然后再进行插入操作。这种机制保证了数据的一致性,但也要求维护阶段需要提前规划好分区边界。
,


