






这次预发布把该架构已有的权重缩放传入线性注意力的输出投影。变化属于模型计算图中的一处调用,见效范围由所加载模型的架构决定。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
缩放作用于哪一条路径
llama.cpp b12474 修改的是 Qwen3-Next 的 build_layer_attn_linear。线性注意力先产生 final_output,再进入输出投影,新的调用为该步骤提供模型层的 ssm_out_s。
实现上新增了什么
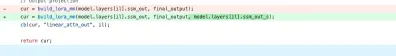
原有 build_lora_mm 调用使用层的 ssm_out 对 final_output 做投影。修复后,该调用多接收同层的 ssm_out_s,从而把输出投影权重缩放纳入这一步。

适用范围怎样识别
这项变化在 llama.cpp b12474 预发布构建交付,修复指向 Qwen3-Next 的线性注意力输出投影。公告未给出通用速度或准确性变化。








