






使用 java 8 引入的 stream api,可以通过 collectors.groupingby() 方法将 arraylist 中的元素按指定条件分组。只需调用集合的 .stream() 方法获取流,再传入 collect(collectors.groupingby(function)),即可得到一个以分类键为 key、包含对应元素的列表为 value 的 map。如果需要对分组后的值进行二次处理(如计数或求和),可以结合 collectors.reducing() 或自定义下游收集器。

如何按对象属性对列表进行基础分组
最直接的做法是使用 Collectors.groupingBy() 并传入一个提取属性的 Lambda 表达式。假设有一个员工列表,想要按部门名称分组,只需在 groupingBy 中指定 Employee::getDepartment。该方法会遍历流中的每个元素,计算 Key,并将元素放入对应的列表中。最终返回的 Map 保持了插入顺序(如果使用 LinkedHashMap 作为目标映射类型,默认行为即如此)。
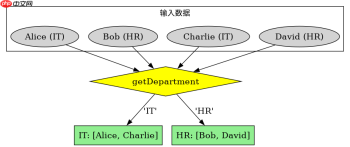
import java.util.*;
import java.util.stream.Collectors;

class Employee {
    String name;
    String department;
    int salary;

    public Employee(String name, String department, int salary) {
        this.name = name;
        this.department = department;
        this.salary = salary;
    }

    public String getDepartment() { return department; }
    public int getSalary() { return salary; }
    public String getName() { return name; }
}

public class Main {
    public static void main(String[] args) {
        List<employee> employees = Arrays.asList(
            new Employee("Alice", "IT", 5000),
            new Employee("Bob", "HR", 4000),
            new Employee("Charlie", "IT", 6000),
            new Employee("David", "HR", 4500)
        );

        // 按部门分组
        Map<string list>> byDept = employees.stream()
            .collect(Collectors.groupingBy(Employee::getDepartment));

        System.out.println(byDept);
    }
}</string></employee>
运行上述代码,控制台输出如下结构:
{IT=[Employee{name='Alice', ...}, Employee{name='Charlie', ...}], HR=[Employee{name='Bob', ...}, Employee{name='David', ...}]}
可以看到,byDept 是一个 Map,Key 是部门字符串,Value 是该部门所有员工的列表。这种操作不会修改原始列表,而是生成一个新的数据结构。
如何在分组时同时统计每组的人数或总和
当不仅需要分组,还需要对组内数据进行聚合计算时,可以使用 Collectors.groupingBy() 的重载版本,它接受两个参数:分类函数和下游收集器(downstream collector)。例如,若要统计每个部门的员工人数,可以将第二个参数设为 Collectors.counting();若要计算每个部门的薪资总和,则使用 Collectors.summingInt(Employee::getSalary)。这种方式避免了先分组再遍历计算的冗余步骤,直接在归约阶段完成统计。


Biome 是一个基于 Rust 的高性能工具链,适用于 JavaScript、TypeScript、JSX、JSON、CSS 和 GraphQL,它将格式化和 linting 统一到一个工具中。具有 97% 的 Prettier 兼容性以及超过 450 条 lint 规则,Biome 以显著更快的执行速度取代了 ESLint 和 Prettier。
// 统计每个部门的人数
Map<string long> countByDept = employees.stream()
    .collect(Collectors.groupingBy(Employee::getDepartment, Collectors.counting()));

// 计算每个部门的总薪资
Map<string integer> sumSalaryByDept = employees.stream()
    .collect(Collectors.groupingBy(Employee::getDepartment, Collectors.summingInt(Employee::getSalary)));

System.out.println(countByDept);   // {IT=2, HR=2}
System.out.println(sumSalaryByDept); // {IT=11000, HR=8500}</string></string>
在上述代码中,counting() 返回的是 Long 类型的计数结果,而 summingInt() 返回的是 Integer 类型的累加和。通过组合不同的下游收集器,可以实现复杂的聚合逻辑,如 averagingDouble() 或自定义的 reducing()。注意,如果分组键对应的值为空或 null,groupingBy 默认会将它们归入一个 Key 为 null 的条目中,除非显式指定了 mapFactory 或使用 filtering() 预处理数据。
如果输入列表中包含 null 元素,分组结果会怎样
当 ArrayList 中存在 null 元素时,Collectors.groupingBy() 的行为取决于分类函数的实现。如果分类函数直接引用对象属性(如 Employee::getDepartment),且列表中包含 null 对象,调用 getDepartment() 会抛出 NullPointerException。因此,在使用基于方法的引用前,必须确保流中没有 null 对象,或者在流操作中预先过滤掉 null。若分类函数本身能处理 null(例如返回固定字符串),则 null 元素会被正常分组到对应的 Key 下。此外,如果希望忽略 null 值而不报错,可以在 stream() 后添加 .filter(Objects::nonNull)。
List<employee> listWithNull = Arrays.asList(
    new Employee("Alice", "IT", 5000),
    null,
    new Employee("Bob", "HR", 4000)
);

// 错误示范:会抛出 NullPointerException
// Map<string list>> badMap = listWithNull.stream()
//     .collect(Collectors.groupingBy(Employee::getDepartment));

// 正确做法:过滤 null
Map<string list>> safeMap = listWithNull.stream()
    .filter(Objects::nonNull)
    .collect(Collectors.groupingBy(Employee::getDepartment));

System.out.println(safeMap); // {IT=[Employee{name='Alice', ...}], HR=[Employee{name='Bob', ...}]}</string></string></employee>
通过 filter(Objects::nonNull),程序安全地跳过了 null 元素,避免了异常。这是处理可能包含空值的集合时的标准实践。如果不进行过滤,任何尝试访问 null 对象属性的操作都会导致运行时崩溃。因此,在构建流管道时,始终检查数据源的完整性是必要的步骤。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


