






使用 filechannel 读写大文件的核心做法是结合 mappedbytebuffer 将文件映射到内存,避免传统 i/o 的频繁磁盘交互。具体实现时,通过 randomaccessfile 获取通道并调用 map() 方法指定映射模式(如只读或读写),随后直接操作字节数组完成数据搬运。这种方式在处理 gb 级文件时能显著降低系统调用开销,但需注意控制映射大小以防内存溢出。

如何配置 FileChannel 的映射模式与缓冲区大小
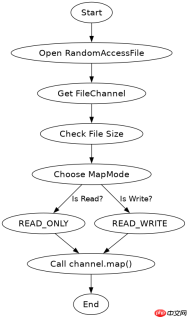
配置映射的关键在于选择正确的 MapMode 枚举值以及合理估算文件大小。对于纯读取场景,使用 READ_ONLY 模式效率最高且最安全;若需修改内容则必须使用 READ_WRITE。在代码层面,先打开 RandomAccessFile 实例,再通过其 getChannel() 方法获取通道,最后调用 channel.map() 传入模式和偏移量。需要注意的是,如果文件极大,一次性映射整个文件可能导致 OutOfMemoryError,此时应分块处理。

Biome 是一个基于 Rust 的高性能工具链,适用于 JavaScript、TypeScript、JSX、JSON、CSS 和 GraphQL,它将格式化和 linting 统一到一个工具中。具有 97% 的 Prettier 兼容性以及超过 450 条 lint 规则,Biome 以显著更快的执行速度取代了 ESLint 和 Prettier。
import java.io.RandomAccessFile;
import java.nio.MappedByteBuffer;
import java.nio.channels.FileChannel;

public class LargeFileReader {
    public static void main(String[] args) throws Exception {
        // 假设有一个 1GB 的文件
        String filePath = "large_file.dat";

        // 1. 打开 RandomAccessFile,模式为只读
        try (RandomAccessFile raf = new RandomAccessFile(filePath, "r")) {
            // 2. 获取 FileChannel
            FileChannel channel = raf.getChannel();

            // 3. 映射整个文件到内存 (仅适用于小文件或测试)
            // 实际生产中建议分块映射
            MappedByteBuffer buffer = channel.map(FileChannel.MapMode.READ_ONLY, 0, channel.size());

            // 4. 直接读取字节
            byte b = buffer.get(0); // 读取第一个字节
            System.out.println("First byte: " + b);
        }
    }
}
如何处理超大文件的分块映射以避免内存溢出
当文件体积超过可用堆内存时,必须采用分块映射策略。具体做法是定义一个固定的缓冲区大小(例如 1GB 或更小),通过循环计算每个块的起始偏移量和长度,依次调用 map() 进行映射和处理。处理完当前块后,释放引用以便 GC 回收,再映射下一块。这种方法虽然增加了代码复杂度,但能保证内存使用的稳定性。同时,MappedByteBuffer 是懒加载的,操作系统会根据访问情况分页加载数据,因此即使映射了大区域,物理内存占用也取决于实际访问的数据页。

FileChannel
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


