






javascript web worker 无法直接传递 idbdatabase 实例,因为数据库连接对象不是可克隆的。正确的做法是在主线程中打开数据库并获取 idbdatabase 后,将具体的数据库名称和版本信息传递给 worker,由 worker 内部自行调用 window.indexeddb.open() 建立独立的本地连接进行数据操作。
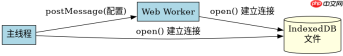
为什么 IDBDatabase 不能跨线程共享
Web Worker 运行在独立于主线程的执行环境中,两者之间通过消息队列通信。浏览器规范规定,只有符合结构化克隆算法(Structured Clone Algorithm)的对象才能在主线程和 Worker 之间传递。IDBDatabase、IDBTransaction 和 IDBCursor 等接口属于持久化的资源句柄,它们持有对底层存储引擎的引用,因此被明确排除在可克隆对象之外。如果尝试使用 postMessage 发送这些对象,会抛出 DataCloneError 异常。
const worker = new Worker('worker.js');

// 错误示范:这会抛出 DataCloneError
indexedDB.open('my-db', 1).then(db => {
  worker.postMessage({ type: 'init', db: db });
});

// 正确做法:只传递配置参数
worker.postMessage({ type: 'init', dbName: 'my-db', version: 1 });
上述代码展示了两种不同的传递方式。第一种尝试直接传递 db 对象,这是不可行的。第二种方式仅传递字符串类型的数据库名和数字类型的版本号,这些是基本类型或简单的数据结构,可以被结构化克隆算法正确处理。Worker 接收到这些参数后,可以在其上下文中重新发起数据库请求。
Worker 内部如何建立独立连接
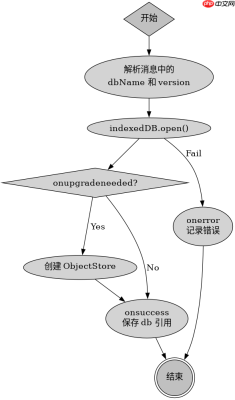
在 Worker 脚本中,需要实现一个逻辑来接收主线程传来的配置,并初始化自己的数据库连接。由于 IndexedDB 的操作是异步的,通常需要在 Worker 内部维护一个状态机或使用 Promise 链来确保连接就绪后再执行后续的数据读写任务。每个 Worker 实例都会拥有自己独立的 IDBDatabase 连接,这意味着主线程和多个 Worker 可以同时访问同一个数据库文件,但必须注意事务的隔离性和并发控制。

使用Atmosphere构建通过WebSocket、SSE、gRPC、WebTransport、MCP、A2A和AG-UI流传输的JVM代理网关,并带有治理钩子。
// worker.js
self.onmessage = function(e) {
  const { dbName, version } = e.data;

  if (e.data.type === 'init') {
    const request = indexedDB.open(dbName, version);

    request.onupgradeneeded = function(event) {
      const db = event.target.result;
      if (!db.objectStoreNames.contains('items')) {
        db.createObjectStore('items', { keyPath: 'id' });
      }
    };

    request.onsuccess = function(event) {
      const db = event.target.result;
      // 通知主线程连接已建立
      self.postMessage({ type: 'connected', db: db }); // 依然不能传 db
      // 实际应用中,应在此处缓存 db 引用供内部使用
      self.dbInstance = db;
    };

    request.onerror = function(event) {
      console.error('Database error:', event.target.error);
    };
  }
};
这段 Worker 代码演示了完整的初始化流程。它监听 onmessage 事件,解析来自主线程的 dbName 和 version。在 onsuccess 回调中,它将返回的 IDBDatabase 对象保存在全局变量 self.dbInstance 中,以便后续的消息处理函数可以直接使用这个连接进行数据存取。需要注意的是,即使在这里获得了 db 对象,也不能再次通过 postMessage 将其发回主线程,因为它仍然不可克隆。
基于具体输入条件的数据交互验证
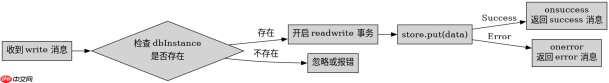
当主线程向 Worker 发送具体的数据写入指令时,Worker 需要使用其内部持有的 IDBDatabase 实例创建事务并执行操作。这种模式确保了数据操作的原子性,并且避免了跨线程共享连接带来的锁竞争问题。开发者应当关注的是如何在 Worker 内部封装通用的数据访问方法,以简化主线程与 Worker 之间的通信协议。
// 主线程发送写入请求
worker.postMessage({
  type: 'write',
  data: { id: 1, name: 'Test Item' }
});

// Worker 内部处理写入
self.onmessage = function(e) {
  if (e.data.type === 'write' && self.dbInstance) {
    const transaction = self.dbInstance.transaction(['items'], 'readwrite');
    const store = transaction.objectStore('items');
    const request = store.put(e.data.data);

    request.onsuccess = function() {
      self.postMessage({ type: 'success', id: e.data.data.id });
    };

    request.onerror = function(event) {
      self.postMessage({ type: 'error', message: event.target.error.message });
    };
  }
};
在这个场景中,主线程发送了一个包含具体数据的对象,Worker 接收到后,利用之前建立的 self.dbInstance 开启一个写事务。数据成功存入后,Worker 通过 postMessage 向主线程返回操作结果。这种基于消息驱动的模式是处理 IndexedDB 跨线程交互的标准实践,既保证了安全性,又实现了高效的数据交换。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南





