






javascript 原型链内存分析的核心在于理解对象实例、构造函数和原型对象在堆内存中的独立存储及其引用关系。每个通过 new 创建的实例都会在堆中拥有独立的属性空间,而它们共享的属性和方法则存储在构造函数的 prototype 对象中,实例通过内部指针 [[prototype]] 指向该原型对象。这种机制使得内存分配既保证了数据的隔离性,又实现了方法的复用,分析时需重点追踪从实例到原型的查找路径及内存占用分布。
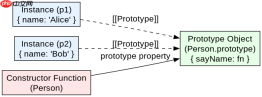
实例与原型对象的内存隔离机制
在 JavaScript 中,当使用 new 关键字调用构造函数时,引擎会在堆内存中创建一个全新的对象实例。这个实例拥有自己独立的属性存储空间,例如在实例上直接赋值的属性会直接存在于该实例对象中,而不是原型上。与此同时,构造函数的 prototype 属性指向一个单独的原型对象,该原型对象存储在堆内存的另一块区域。实例对象内部包含一个隐藏的属性 [[Prototype]](在现代浏览器中可通过 __proto__ 访问),它指向构造函数的 prototype。这种设计意味着,虽然多个实例共享原型上的方法以节省内存,但它们的自有属性是互不干扰的。分析内存时,必须区分哪些数据属于实例本身,哪些属于原型共享,这决定了内存的分配效率和数据修改的影响范围。
function Person(name) {
    this.name = name;
}
Person.prototype.sayName = function() {
    console.log(this.name);
};

const p1 = new Person('Alice');
const p2 = new Person('Bob');

// p1 和 p2 在堆中有独立的 {name: 'Alice'} 和 {name: 'Bob'}
// p1.[[Prototype]] 和 p2.[[Prototype]] 都指向同一个 Person.prototype 对象
// Person.prototype 中包含 sayName 方法
上述代码展示了典型的内存布局。p1 和 p2 是两个独立的对象,分别占用堆内存中的不同地址。它们的 name 属性各自独立。然而,sayName 方法只存在于 Person.prototype 中,p1 和 p2 通过原型链引用该方法。如果我们在 p1 上添加一个新属性 p1.age = 20,这个属性只会存在于 p1 的内存空间中,不会影响 p2 或原型对象。这种隔离机制确保了实例数据的独立性,同时通过共享原型减少了重复代码的内存开销。
原型链查找与内存引用路径
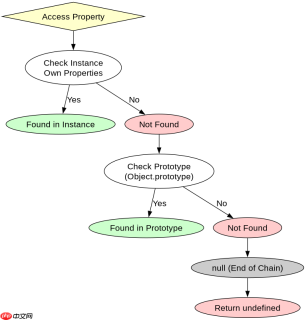
当访问一个对象的属性时,JavaScript 引擎会先在实例自身的属性中查找。如果找不到,引擎会通过 [[Prototype]] 指针跳转到原型对象中继续查找。如果原型对象中也没有,且原型对象本身也有原型(即原型链向上延伸),则继续沿着原型链向上查找,直到找到属性或到达原型链顶端(通常是 Object.prototype)。这一过程涉及多次内存引用跳转,每次跳转都依赖于对象内部的指针。分析内存时,需要关注原型链的长度以及每层原型对象的大小,因为过长的原型链可能导致性能下降,而原型对象过大则会增加内存负担。此外,修改原型对象会影响所有指向该原型的实例,这在内存管理中需要特别注意,以避免意外的数据污染。

使用Atmosphere构建通过WebSocket、SSE、gRPC、WebTransport、MCP、A2A和AG-UI流传输的JVM代理网关,并带有治理钩子。

// 假设我们有一个更复杂的继承链
function Animal() {
    this.type = 'animal';
}
Animal.prototype.eat = function() {
    return 'eating';
};

function Dog() {
    this.breed = 'dog';
}
Dog.prototype = Object.create(Animal.prototype);
Dog.prototype.constructor = Dog;
Dog.prototype.bark = function() {
    return 'barking';
};

const myDog = new Dog();
console.log(myDog.eat()); // 输出 'eating',通过原型链找到 Animal.prototype.eat
console.log(myDog.bark()); // 输出 'barking',在 Dog.prototype 中找到
console.log(myDog.type); // 输出 'animal',在 myDog 自身没有找到,但在 Animal.prototype 中也没有,实际上 type 是实例属性,这里应修正为:
// 修正:type 是 Animal 构造函数的实例属性,所以 myDog 没有 type,除非在 Dog 构造函数中调用 Animal.call(this)
// 为了演示原型链,我们看 eat 方法
// myDog -> Dog.prototype -> Animal.prototype -> Object.prototype -> null
在这个例子中,myDog 实例首先查找 eat 方法,未在自身找到,然后通过 [[Prototype]] 指向 Dog.prototype,仍未找到,再指向 Animal.prototype,最终找到 eat 方法。这个过程涉及两次内存引用跳转。如果 eat 方法不存在于 Animal.prototype 中,引擎会继续向上查找至 Object.prototype,若仍不存在则返回 undefined。分析内存时,需明确每条原型链的路径,确保没有循环引用导致内存泄漏,并优化原型链长度以提高属性访问效率。
基于原型链断裂的内存影响分析
当手动替换原型对象时,如 Dog.prototype = { ... };,原有的原型链会被切断。新创建的原型对象不再指向原来的 Animal.prototype,而是指向一个新的对象。这意味着之前创建的实例仍然指向旧的原型对象,而新创建的实例将指向新的原型对象。这种操作会导致内存中出现两套原型体系,旧的原型对象可能成为垃圾回收的候选者,如果没有其他引用指向它。分析内存时,需注意这种断裂可能导致某些实例无法访问原本共享的方法,从而引发运行时错误。此外,如果旧的原型对象仍然被某些实例引用,它将保留在内存中,造成内存浪费。因此,在重构原型链时,应谨慎处理原型替换,确保所有实例都能正确访问所需的方法,并及时清理不再使用的原型对象以避免内存泄漏。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南





