






在 java 日志记录中,可以通过调用 logger 或 logmanager 提供的 api 获取当前线程的栈帧信息来提取行号。具体做法是使用 thread.currentthread().getstacktrace() 方法获取栈跟踪数组,跳过前几个由日志框架自身调用产生的帧(通常是索引 2 或 3),然后从剩余的 stacktraceelement 对象中调用 getlinenumber() 方法即可得到准确的源代码行号。

如何编写一个自动捕获行号的日志工具类
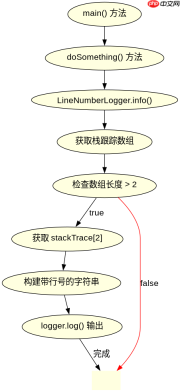
要实现自动记录行号,核心思路是封装一个静态方法,该方法内部通过反射栈来获取调用者的位置信息。这样开发者只需调用这个工具方法,而不需要在每次打印日志时手动传入行号参数。这种方法虽然比直接调用标准日志 API 稍慢,但在开发调试阶段非常有用。
import java.util.logging.Logger;
import java.util.logging.Level;

public class LineNumberLogger {
    private static final Logger logger = Logger.getLogger(LineNumberLogger.class.getName());

    public static void info(String message) {
        // getStackTrace() 返回当前线程的栈跟踪
        StackTraceElement[] stackTrace = Thread.currentThread().getStackTrace();

        // 索引分析:
        // index 0: getStackTrace()
        // index 1: info()
        // index 2: 调用 info() 的方法 (即我们想要的行号)
        if (stackTrace.length > 2) {
            StackTraceElement caller = stackTrace[2];
            String fileName = caller.getFileName();
            int lineNumber = caller.getLineNumber();
            String className = caller.getClassName();
            String methodName = caller.getMethodName();

            // 构建包含行号的日志消息
            String detailedMessage = String.format("[%s:%d] %s",
                fileName != null ? fileName : "unknown",
                lineNumber,
                message);

            logger.log(Level.INFO, detailedMessage);
        } else {
            logger.log(Level.INFO, message);
        }
    }

    public static void main(String[] args) {
        // 模拟业务代码
        doSomething();
    }

    private static void doSomething() {
        // 这里调用我们的工具类
        info("这是一个测试消息");
    }
}
运行上述代码后,控制台输出将类似于:
INFO: [LineNumberLogger.java:35] 这是一个测试消息
其中 35 即为 info 方法被调用的实际行号。注意,getStackTrace() 会创建新的数组对象并填充栈数据,因此在高频调用的生产环境中需谨慎使用,以免产生过多的垃圾回收压力。
不同日志框架下获取行号的差异与性能影响
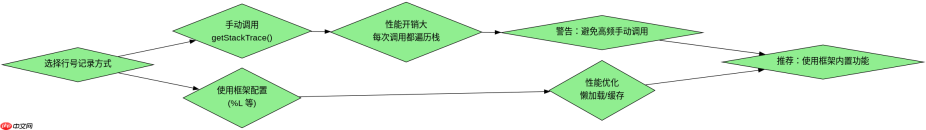
虽然原生 Java 提供了 getStackTrace(),但主流日志框架如 Logback、Log4j2 和 SLF4J 通常有更优化的实现方式。例如,Logback 的 %L 转换符可以直接在配置文件中启用行号记录,它内部使用了更高效的栈解析机制,而不是每次都调用 getStackTrace()。相比之下,手动调用 getStackTrace() 会导致每次日志记录都进行完整的栈遍历,性能开销显著高于框架内置方案。此外,某些框架支持懒加载行号,仅在日志级别匹配时才计算行号,从而进一步减少不必要的 CPU 消耗。

Java开发手册规约集合,基于阿里巴巴Java开发手册(嵩山版)。 涵盖7大维度:编程规约、异常日志、单元测试、安全规约、MySQL数据库、工程结构、设计规约。
// Logback 配置示例 (logback.xml)
<configuration><appender name="STDOUT" class="ch.qos.logback.core.ConsoleAppender"><encoder><pattern>%d{HH:mm:ss.SSS} [%thread] %-5level %logger{36} - %msg%n%ex</pattern><!-- 注意:Logback 默认不记录行号,需使用 %L 且可能影响性能 --><pattern>%d{HH:mm:ss.SSS} [%thread] %-5level %logger{36}:%L - %msg%n</pattern></encoder></appender><root level="INFO"><appender-ref ref="STDOUT"></appender-ref></root></configuration>
在实际项目中,如果必须记录行号,建议优先使用日志框架提供的格式化选项(如 Logback 的 %L 或 Log4j2 的 %L),而不是在代码中手动调用 getStackTrace()。这样可以确保行号记录的准确性和性能平衡。对于需要动态获取行号的场景,可以考虑使用 AOP 或字节码增强技术,在编译期或加载期注入行号信息,避免运行时栈遍历的开销。
当调用链较深时如何准确定位源文件行号
在复杂的调用链中,Thread.currentThread().getStackTrace()[2] 可能指向的是中间层的代理方法或包装器,而非最终的业务代码行。为了准确定位,可以遍历栈帧,跳过所有属于日志工具类本身或框架内部的类名,直到找到第一个非日志相关的类。例如,可以检查 caller.getClassName() 是否以 com.example.logger 开头,如果是则继续向下查找。这种策略能确保即使经过多层封装,也能正确捕捉到用户代码的实际执行位置。同时,需注意 getFileName() 在某些环境下可能返回 null,应做空值处理以避免 NullPointerException。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


