






java 中识别 utf-8 bom 的标准做法是读取文件开头的三个字节,判断其是否等于 0xef 0xbb 0xbf。若匹配则跳过这三个字节继续处理正文;若不匹配则按普通 utf-8 流处理。推荐使用 bufferedreader 配合自定义的 inputstreamreader 或手动检测前缀来实现。

如何检测输入流的前三个字节是否为 BOM
通过 InputStream.mark() 和 read() 方法可以安全地检查流起始位置。具体实现时,创建一个包装类,在初始化时尝试读取三个字节并比对 BOM 值,如果匹配则记录已消费状态,后续读取时自动跳过。
import java.io.*;

public class BOMInputStream extends FilterInputStream {
    private boolean bomConsumed = false;
    private byte[] bomBytes = new byte[3];
    private int bytesRead = 0;

    public BOMInputStream(InputStream in) throws IOException {
        super(in);
        // 尝试读取 BOM
        int count = 0;
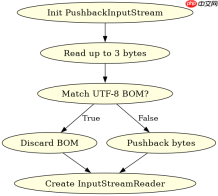
        while (count <p>实际开发中,建议使用 <code>PushbackInputStream</code> 来包裹原始输入流。在构造时读取三个字节,如果是 BOM 则丢弃(不 pushback),否则将这三个字节 pushback 回流中,确保后续读取器能正常读到文件头。</p><pre class="brush:php;toolbar:false;">import java.io.*;

public class SafeBOMReader {
    public static BufferedReader createReader(InputStream is, String charset) throws IOException {
        PushbackInputStream pbis = new PushbackInputStream(is, 3);
        byte[] bom = new byte[3];
        int n = pbis.read(bom, 0, 3);

        boolean hasBom = false;
        if (n == 3) {
            if (bom[0] == (byte)0xEF && bom[1] == (byte)0xBB && bom[2] == (byte)0xBF) {
                hasBom = true;
            } else {
                pbis.unread(bom, 0, n);
            }
        } else if (n > 0) {
            pbis.unread(bom, 0, n);
        }

        return new BufferedReader(new InputStreamReader(pbis, charset));
    }
}
调用 SafeBOMReader.createReader(inputStream, "UTF-8") 即可得到一个自动处理 BOM 的 BufferedReader。如果文件包含 BOM,它会被静默跳过;如果不包含,文件内容从第一行开始被正确读取。

为什么有些库会自动处理 BOM 而有些不会
不同 Java IO 库对 BOM 的处理策略不同。例如 java.nio.file.Files.newBufferedReader() 在某些 JDK 版本中会尝试检测 BOM 并调整解码器,但行为可能不一致。而传统的 FileReader 默认使用平台编码,完全忽略 UTF-8 BOM。第三方库如 Apache Commons IO 提供了 BOMInputStream 类专门用于此目的。

// 使用 Apache Commons IO (需引入依赖)
import org.apache.commons.io.input.BOMInputStream;
import java.io.FileInputStream;
import java.io.BufferedReader;
import java.io.InputStreamReader;

public class CommonsIOExample {
    public static void main(String[] args) throws Exception {
        try (BOMInputStream bomIn = new BOMInputStream(
                new FileInputStream("test.txt"),
                BOM.UTF8)) {
            try (BufferedReader reader = new BufferedReader(
                    new InputStreamReader(bomIn, "UTF-8"))) {
                String line = reader.readLine();
                System.out.println(line); // 第一行内容,不含 BOM 字符
            }
        }
    }
}
Apache Commons IO 的 BOMInputStream 内部实现了类似的逻辑,但封装更好,支持多种 BOM 类型(如 UTF-16 BE/LE)。对于新项目,优先推荐此类成熟库,避免重复造轮子导致边界情况处理错误。
当文件中存在非标准 BOM 或混合编码时会发生什么
如果文件开头不是标准的 EF BB BF,而是其他字节序列,BOMInputStream 或自定义检测逻辑会将其视为普通数据。此时,如果后续解码器仍按 UTF-8 解析,这些字节会被当作有效字符输出,可能导致首行出现乱码。例如,若文件以 FF FE 开头(UTF-16 LE BOM),UTF-8 解码器会将其解释为两个非法或多字节字符,造成显示异常。因此,识别 BOM 的前提是明确预期编码,并在检测失败时采取适当策略,如抛出异常或切换解码器。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


