






在java日志记录中结合链路追踪,核心做法是在日志输出时自动注入全局唯一的trace id。具体实现通常通过自定义logback或log4j2的pattern layout,利用mdc(mapped diagnostic context)机制,在请求入口处生成id并放入上下文,随后在日志配置中使用%x{traceid}占位符将其打印到日志行中。这样做的结果是每条日志都携带了相同的追踪标识,便于在海量日志中快速检索和串联特定请求的全生命周期数据。
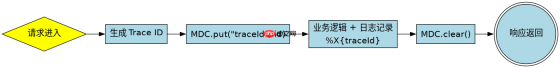
如何在日志格式中嵌入Trace ID
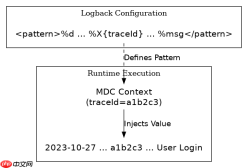
要在日志文件中看到Trace ID,必须修改日志框架的配置文件,将MDC中的字段映射到输出模式中。以最常见的Logback为例,需要在logback-spring.xml中定义一个包含%X{traceId}的pattern。当应用启动后,任何进入系统的请求如果触发了拦截器或过滤器并将ID存入MDC,那么后续所有由该线程产生的日志都会自动带上这个ID。这种配置方式简单直接,不需要侵入业务代码即可实现全量日志的标准化。
<configuration><appender name="CONSOLE" class="ch.qos.logback.core.ConsoleAppender"><encoder><pattern>%d{yyyy-MM-dd HH:mm:ss.SSS} [%thread] %-5level %logger{36} - %X{traceId} - %msg%n</pattern></encoder></appender><root level="INFO"><appender-ref ref="CONSOLE"></appender-ref></root></configuration>
上述配置定义了控制台输出的格式。其中%X{traceId}是关键字段,它会从当前线程的MDC中查找名为traceId的值。如果未设置,则输出为空。配合前面的拦截器逻辑,实际运行时的日志输出将类似于:2023-10-27 10:00:00.123 [http-nio-8080-exec-1] INFO c.e.demo.Controller - a1b2c3d4 - User login success。这里a1b2c3d4即为生成的唯一标识。开发者可以通过复制该ID,在ELK或Splunk等日志平台中进行精确过滤,从而定位该次请求的所有相关日志。
如何确保跨服务调用时Trace ID一致
在微服务架构中,单个服务的日志只能反映局部状态,要实现完整的链路追踪,必须保证Trace ID在HTTP或RPC调用链中透传。这通常通过在客户端发送请求前读取MDC中的ID,并将其添加到HTTP Header中,同时在服务端接收请求时解析Header并写入本地MDC来实现。Spring Cloud Sleuth或Micrometer Tracing等成熟库可以自动化这一过程,但理解其底层原理有助于排查透传失败的问题。关键在于入口和出口两个节点的MDC操作必须成对出现且线程安全。


// 客户端拦截器示例:将Trace ID放入Header
public class TraceInterceptor implements ClientHttpRequestInterceptor {
    @Override
    public ClientHttpResponse intercept(HttpRequest request, byte[] body, ClientHttpRequestExecution execution) throws IOException {
        String traceId = MDC.get("traceId");
        if (traceId != null) {
            request.getHeaders().add("X-Trace-Id", traceId);
        }
        return execution.execute(request, body);
    }
}

// 服务端过滤器示例:从Header获取Trace ID并放入MDC
@WebFilter("/*")
public class TraceFilter implements Filter {
    @Override
    public void doFilter(ServletRequest request, ServletResponse response, FilterChain chain) {
        HttpServletRequest httpRequest = (HttpServletRequest) request;
        String traceId = httpRequest.getHeader("X-Trace-Id");
        if (traceId == null || traceId.isEmpty()) {
            traceId = UUID.randomUUID().toString().replace("-", "");
        }
        MDC.put("traceId", traceId);
        try {
            chain.doFilter(request, response);
        } finally {
            MDC.clear(); // 清理MDC防止内存泄漏
        }
    }
}
这段代码展示了手动实现Trace ID透传的两种典型场景。客户端拦截器在发出HTTP请求前,检查当前线程MDC中是否存在traceId,若存在则将其作为X-Trace-Id头附加到请求中。服务端过滤器则在请求到达时,优先从Header中提取ID;如果Header中没有(例如这是链路的起点),则生成一个新的UUID。最后务必在finally块中调用MDC.clear(),因为Tomcat等容器使用线程池,不清理会导致后续复用该线程的请求污染MDC数据。通过这种方式,上游服务生成的ID会一路传递到下游,确保整个分布式链路在日志层面具有连续性。
异步线程中Trace ID丢失如何解决
在实际开发中,经常遇到日志中Trace ID突然消失的情况,这通常发生在任务提交到异步线程池执行时。由于MDC是基于ThreadLocal实现的,子线程无法自动继承父线程的MDC数据。如果在异步方法中直接记录日志,会发现%X{traceId}为空。解决这个问题的标准做法是在提交异步任务前,捕获当前的MDC上下文,并在子线程执行初期将其恢复,执行结束后再清理。可以使用Spring提供的TaskDecorator或手动包装Runnable来实现。
// 自定义TaskDecorator用于传递MDC
public class MdcTaskDecorator implements TaskDecorator {
    @Override
    public Runnable decorate(Runnable runnable) {
        Map<string string> contextMap = MDC.getCopyOfContextMap();
        return () -> {
            try {
                if (contextMap != null) {
                    MDC.setContextMap(contextMap);
                }
                runnable.run();
            } finally {
                MDC.clear();
            }
        };
    }
}

// 使用时注册到线程池
ThreadPoolTaskExecutor executor = new ThreadPoolTaskExecutor();
executor.setTaskDecorator(new MdcTaskDecorator());
executor.initialize();
executor.submit(() -> {
    // 这里的日志会包含正确的Trace ID
    log.info("Async task executed");
});</string>
上述MdcTaskDecorator实现了TaskDecorator接口,在任务真正执行前,通过MDC.getCopyOfContextMap()获取主线程的MDC快照,并在子线程中通过MDC.setContextMap()还原。这保证了即使在异步回调、定时任务或消息队列消费者中,日志依然能正确关联到原始请求的Trace ID。如果不做处理,异步部分的日志将成为“孤儿”日志,无法与同步部分串联,导致链路追踪断裂。开发者在使用@Async注解或自定义线程池时,务必检查是否配置了此类装饰器。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


