






css 复合选择器从右向左解析是为了性能优化。浏览器引擎会先通过最快的方式(如 id、类名或标签)定位页面中所有可能的候选元素,然后再逐级向上检查父级是否匹配,从而避免对不相关的子元素进行昂贵的祖先遍历。

为什么从左向右解析会导致性能问题
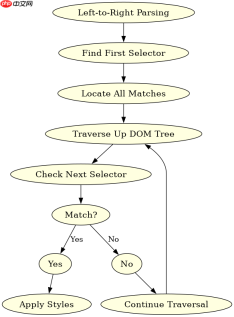
如果 CSS 引擎从左向右解析,它必须找到所有匹配最左侧选择器的元素,然后为每个元素去遍历 DOM 树查找其祖先是否符合后续条件。在大型文档中,这会产生巨大的计算开销。
  <div class="container">
    <p>Text 1</p>
    <p>Text 2</p>
    <div class="nested">
      <p>Text 3</p>
    </div>
  </div>
  <div class="other">
    <p>Text 4</p>
  </div>
假设我们使用 .container p 这个选择器。从左向右解析时,引擎首先找到所有 p 标签(Text 1, Text 2, Text 3, Text 4)。然后,对于每一个 p,它都要向上遍历 DOM 树,检查其祖先是否有 .container 类。对于 Text 4,它需要一直追溯到根节点才能确认不匹配。这种“先找所有后代再验证祖先”的模式在 DOM 庞大且选择器复杂时会显著拖慢渲染速度。
从右向左解析的具体执行流程
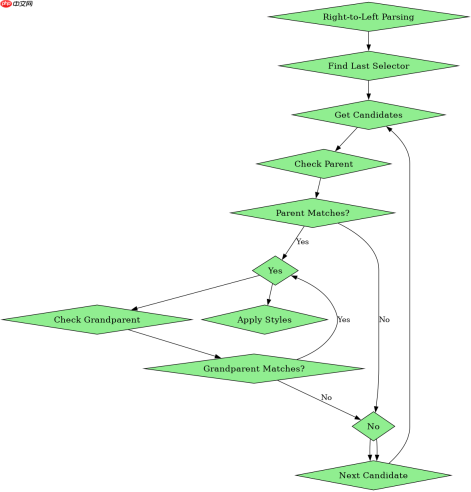
从右向左解析时,引擎首先定位最右侧的选择器(通常是最高效的标识符),找到所有匹配的候选元素,然后只对这些候选元素的祖先链进行验证。这大大减少了不必要的 DOM 遍历。

  <div class="container">
    <p>Text 1</p>
    <p>Text 2</p>
    <div class="nested">
      <p>Text 3</p>
    </div>
  </div>
  <div class="other">
    <p>Text 4</p>
  </div>
同样使用 .container p 选择器。从右向左解析时,引擎首先找到所有 p 标签(Text 1, Text 2, Text 3, Text 4)。然后,它只检查这些 p 的父级或祖先是否有 .container 类。对于 Text 1 和 Text 2,它们直接位于 .container 下,匹配成功。对于 Text 3,它的祖先中有 .container,也匹配成功。对于 Text 4,它的祖先中没有 .container,匹配失败。这个过程只涉及必要的祖先检查,避免了全局搜索。
基于具体输入条件的匹配结果差异
当选择器包含多个层级时,从右向左解析的优势更加明显。例如,使用 #header .nav li a 这样的选择器,引擎会先找到所有 a 标签,然后检查它们的祖先是否有 li,再检查是否有 .nav,最后检查是否有 #header。这种逐层过滤的方式确保了只有真正符合条件的元素才会被处理,极大地提高了浏览器的渲染效率。
前端入门到VUE实战笔记:立即使用
在学习笔记中,你将探索 前端 的入门与实战技巧!










