






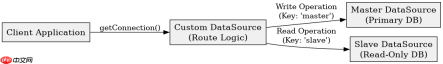
java 数据库连接池配置路由的核心在于实现自定义的 datasource 接口,通过拦截 getconnection() 调用并根据业务逻辑(如数据源标识、租户 id 或读写标记)动态选择底层物理连接。具体做法是定义一个代理类或包装器,内部维护多个 datasource 实例,在获取连接前解析路由规则,将请求转发至对应的目标数据源,从而在不修改业务代码的前提下实现多数据源的透明切换。
如何基于注解或上下文实现动态数据源路由
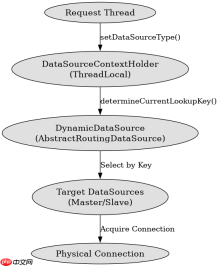
要实现基于上下文的动态路由,通常使用继承 AbstractRoutingDataSource 的方式,重写 determineCurrentLookupKey() 方法。该方法会在每次获取连接时被调用,开发者需从线程局部变量(如 ThreadLocal)中读取当前请求的路由键,并返回对应的数据源标识。Spring 框架默认提供了这种机制,只需配置多个目标数据源并设置主数据源即可。当业务代码通过 AOP 或拦截器设置好路由键后,连接池会自动根据该键查找并返回正确的物理连接,确保事务和连接的生命周期与路由上下文一致。
import org.springframework.jdbc.datasource.lookup.AbstractRoutingDataSource;

public class DynamicDataSource extends AbstractRoutingDataSource {
    @Override
    protected Object determineCurrentLookupKey() {
        return DataSourceContextHolder.getDataSourceType();
    }
}
上述代码展示了核心路由类的实现。在实际应用中,DataSourceContextHolder 是一个管理 ThreadLocal 的工具类,用于存储当前线程的数据源类型。配置时,需在 Spring 容器中注册此 DynamicDataSource bean,并将具体的 MasterDataSource 和 SlaveDataSource 作为 targetDataSources 注入。这样,当应用发起数据库操作时,框架会自动调用 determineCurrentLookupKey 获取键值,进而从目标数据源映射表中找到对应的 DataSource 实例,完成连接的获取。整个过程对业务层完全透明,无需手动管理数据源切换。
如何在多租户场景下隔离不同租户的连接池
在多租户架构中,每个租户可能拥有独立的数据库实例,此时连接池路由需结合租户标识进行隔离。实现方式是在路由逻辑中增加租户维度的判断,通常为每个租户预创建或按需初始化一个独立的 DataSource 实例。路由键不仅包含读写标记,还包含租户 ID。当请求到达时,系统先识别租户 ID,再结合读写需求确定最终的数据源。若采用懒加载策略,可在首次遇到某租户请求时动态创建其专属连接池,后续请求复用该实例,从而实现资源的按需分配和租户间的物理隔离。


import com.zaxxer.hikari.HikariConfig;
import com.zaxxer.hikari.HikariDataSource;
import java.util.Map;
import java.util.concurrent.ConcurrentHashMap;

public class TenantDataSourceRouter {
    private final Map<string hikaridatasource> tenantDataSources = new ConcurrentHashMap();

    public HikariDataSource getDataSource(String tenantId) {
        return tenantDataSources.computeIfAbsent(tenantId, this::createTenantDataSource);
    }

    private HikariDataSource createTenantDataSource(String tenantId) {
        HikariConfig config = new HikariConfig();
        config.setJdbcUrl("jdbc:mysql://localhost/db_" + tenantId);
        config.setUsername("user_" + tenantId);
        config.setPassword("pass_" + tenantId);
        return new HikariDataSource(config);
    }
}</string>
该示例代码演示了基于租户 ID 的动态数据源创建与管理。TenantDataSourceRouter 使用 ConcurrentHashMap 缓存已创建的租户数据源,避免重复初始化。当调用 getDataSource 时,若缓存中不存在对应租户的数据源,则通过 createTenantDataSource 方法创建新的 HikariDataSource 实例,并配置特定的 JDBC URL 和认证信息。这种方式确保了每个租户的数据访问都被限制在其专属的连接池中,实现了严格的物理隔离。在实际部署中,可结合 AbstractRoutingDataSource 使用,将租户 ID 作为路由键的一部分,由框架统一调度。
当路由键为空时连接池会如何处理默认数据源
当路由键为空或未设置时,连接池通常会回退到预设的默认数据源,以确保系统在高可用性和容错性方面的表现。在 AbstractRoutingDataSource 的实现中,若 determineCurrentLookupKey() 返回 null,框架会自动使用配置的 defaultTargetDataSource 作为后备选项。这一机制防止了因路由上下文缺失导致的空指针异常或连接获取失败。开发者应在配置阶段明确指定默认数据源,通常为主库或最常用库,以保证在路由失效时系统仍能正常响应基本查询请求。同时,建议在日志中记录此类回退行为,便于监控和排查潜在的路由配置问题。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


