






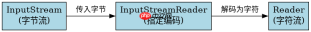
在java中,可以通过 inputstreamreader 的构造函数直接指定编码。只需传入一个 java.io.inputstream 对象和一个表示字符集名称的 string(如 "utf-8")即可。这样创建的流会按照指定的编码将字节解码为字符,确保读取内容与预期一致。
使用 String 指定编码名称
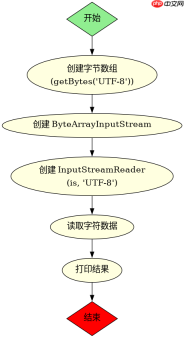
最直接的方法是在构造 InputStreamReader 时传入编码字符串。这种方式简单直观,适用于大多数场景。如果指定的编码名称不被支持,会抛出 UnsupportedEncodingException。
import java.io.*;

public class EncodingExample {
    public static void main(String[] args) throws IOException {
        // 模拟字节数据:"Hello" 的 UTF-8 字节
        byte[] bytes = "Hello".getBytes("UTF-8");
        InputStream is = new ByteArrayInputStream(bytes);

        // 指定 UTF-8 编码
        InputStreamReader reader = new InputStreamReader(is, "UTF-8");

        char[] buffer = new char[10];
        int len = reader.read(buffer);
        System.out.println(new String(buffer, 0, len));

        reader.close();
    }
}
运行上述代码,控制台将输出 Hello。这里通过 new InputStreamReader(is, "UTF-8") 明确指定了编码。如果省略第二个参数,将使用系统默认编码,可能导致乱码。
使用 Charset 对象指定编码
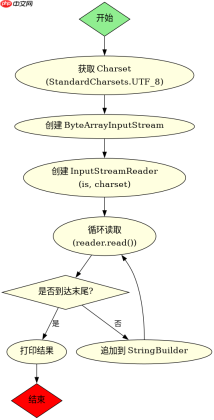
另一种更推荐的方式是使用 java.nio.charset.Charset 对象。这种方式避免了字符串拼写错误,并且可以在运行时动态获取或验证编码支持情况。构造方法接受 Charset 实例作为参数。

import java.io.*;
import java.nio.charset.*;

public class CharsetExample {
    public static void main(String[] args) throws IOException {
        byte[] bytes = "World".getBytes(StandardCharsets.UTF_8);
        InputStream is = new ByteArrayInputStream(bytes);

        // 使用 StandardCharsets.UTF_8
        InputStreamReader reader = new InputStreamReader(is, StandardCharsets.UTF_8);

        int c;
        StringBuilder sb = new StringBuilder();
        while ((c = reader.read()) != -1) {
            sb.append((char) c);
        }
        System.out.println(sb.toString());

        reader.close();
    }
}
此代码输出 World。使用 StandardCharsets.UTF_8 是静态常量,编译期检查更安全。相比字符串方式,它不会抛出 UnsupportedEncodingException,因为标准编码在 Java 中必须被支持。若需自定义编码,可调用 Charset.forName("name") 获取 Charset 对象。
当输入流已包含 BOM 时如何处理
如果输入的字节流以 BOM(Byte Order Mark)开头,例如 UTF-8 BOM(EF BB BF),直接使用 InputStreamReader 会将 BOM 字符作为普通字符读取出来,导致解析异常。此时需要手动跳过 BOM 或使用支持 BOM 检测的包装类。例如,可以使用 BOMInputStream 从 Apache Commons IO 库中过滤掉 BOM,或者在读取第一个字符后判断是否为 BOM 并丢弃。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


