






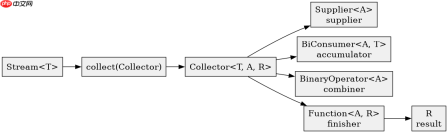
在java stream的collect中自定义收集,核心是调用stream接口的collect方法并传入一个collector实例。通常通过collectors类提供的工厂方法(如groupingby、mapping)组合出复杂逻辑,或者直接使用collector.of工厂方法手动定义累加器、合并器和完成器来实现完全自定义的收集行为。
如何使用Collectors.groupingBy进行分组统计
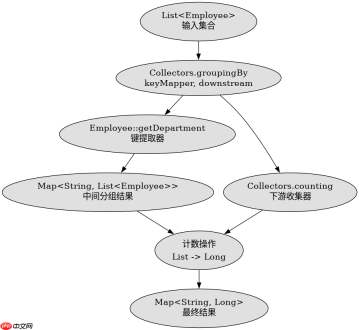
使用Collectors.groupingBy可以按指定条件对元素进行分组,并结合下游收集器实现统计。例如,将一组员工按部门分组并统计人数,只需调用Collectors.groupingBy(Employee::getDepartment, Collectors.counting())即可得到Map
import java.util.*;
import java.util.stream.Collectors;

public class Main {
    public static void main(String[] args) {
        List<employee> employees = Arrays.asList(
            new Employee("Alice", "Engineering"),
            new Employee("Bob", "HR"),
            new Employee("Charlie", "Engineering")
        );

        Map<string long> deptCounts = employees.stream()
            .collect(Collectors.groupingBy(
                Employee::getDepartment,
                Collectors.counting()
            ));

        System.out.println(deptCounts);
    }
}

class Employee {
    private String name;
    private String department;

    public Employee(String name, String department) {
        this.name = name;
        this.department = department;
    }

    public String getDepartment() {
        return department;
    }
}</string></employee>
如何手动实现Collector接口
当内置收集器无法满足需求时,可以使用Collector.of工厂方法手动定义收集逻辑。这需要指定三个函数:supplier用于创建累加容器,accumulator用于处理每个元素,combiner用于合并部分结果。例如,手动实现一个将字符串连接成逗号分隔列表的收集器。

import java.util.*;
import java.util.function.*;
import java.util.stream.Collector;

public class Main {
    public static void main(String[] args) {
        List<string> names = Arrays.asList("Alice", "Bob", "Charlie");

        Collector<string string> joiningCollector = Collector.of(
            StringBuilder::new,
            (sb, s) -> sb.append(s).append(","),
            (sb1, sb2) -> sb1.append(sb2.toString().substring(0, Math.max(0, sb2.length() - 1))),
            StringBuilder::toString
        );

        String result = names.stream().collect(joiningCollector);
        System.out.println(result);
    }
}</string></string>
collector.of的combiner函数如何处理并行流
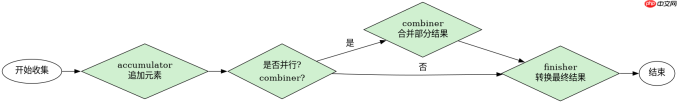
在使用parallelStream执行collect操作时,combiner函数负责将不同线程产生的部分结果合并。如果combiner实现不当,可能导致数据丢失或重复。例如在上述joiningCollector中,combiner需要正确处理前一个StringBuilder末尾可能存在的多余逗号,确保最终结果的格式正确。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


