






Java HashSet 为什么不能存重复元素
java hashset 不能存储重复元素,是因为其底层基于 hashmap 实现,利用对象的 equals() 和 hashcode() 方法来判断唯一性。当向集合中添加元素时,hashset 会计算该元素的哈希值以确定其在内部数组中的位置,如果该位置已有元素,则进一步通过 equals() 方法比较内容是否相同,若相同则视为重复元素并拒绝添加。

HashMap 如何保证 Key 的唯一性
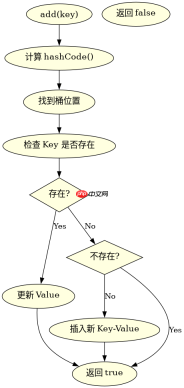
HashSet 的底层数据结构是 HashMap,其中添加的元素作为 HashMap 的 Key 存储,Value 固定为一个静态的 PRESENT 对象。HashMap 通过哈希表结构来管理这些 Key,确保每个 Key 都是唯一的。在插入新 Key 时,HashMap 首先检查哈希表中是否存在相同的 Key,如果存在则更新 Value,否则插入新的 Key-Value 对。
import java.util.HashMap;
import java.util.HashSet;

public class Main {
    public static void main(String[] args) {
        // 创建 HashSet
        HashSet<string> set = new HashSet();

        // 添加元素
        set.add("Apple");
        set.add("Banana");
        set.add("Apple"); // 尝试添加重复元素

        // 输出结果
        System.out.println(set); // [Apple, Banana]
        System.out.println(set.size()); // 2
    }
}</string>
自定义对象如何正确重写 hashCode 和 equals
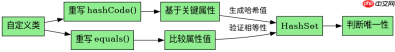
对于自定义对象,要确保它们在 HashSet 中不被重复存储,必须正确重写 hashCode() 和 equals() 方法。如果不重写这两个方法,默认使用 Object 类的实现,即基于内存地址进行比较,这可能导致逻辑上相同的对象被视为不同元素。正确的做法是根据对象的关键属性生成哈希值,并在 equals() 方法中比较这些属性的值。

掌握 ES6+ 特性,包括 async/await、解构、扩展运算符、箭头函数、Promise、模块、迭代器、生成器以及函数式编程模式,编写简洁高效的 Java
import java.util.Objects;
import java.util.HashSet;

class Person {
    private String name;
    private int age;

    public Person(String name, int age) {
        this.name = name;
        this.age = age;
    }

    @Override
    public boolean equals(Object o) {
        if (this == o) return true;
        if (o == null || getClass() != o.getClass()) return false;
        Person person = (Person) o;
        return age == person.age && Objects.equals(name, person.name);
    }

    @Override
    public int hashCode() {
        return Objects.hash(name, age);
    }
}

public class Main {
    public static void main(String[] args) {
        HashSet<person> set = new HashSet();
        set.add(new Person("Alice", 30));
        set.add(new Person("Alice", 30)); // 逻辑上相同的对象

        System.out.println(set.size()); // 1
    }
}</person>
哈希冲突时的处理机制
当两个不同的对象计算出相同的哈希值时,会发生哈希冲突。在这种情况下,HashSet 会通过链地址法或红黑树来处理冲突。具体来说,如果哈希表中某个位置的链表长度超过一定阈值(默认为8),并且总节点数达到64以上,链表会转换为红黑树以提高查找效率。这种机制确保了即使在哈希冲突的情况下,HashSet 仍能高效地判断元素是否重复。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


