






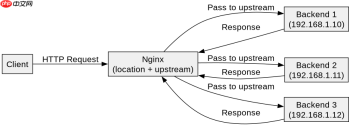
nginx 的 location 块本身不直接执行健康检查,而是通过上游模块(如 ngx_http_upstream_module)定义后端节点组来实现。具体做法是在 upstream 中配置 server 指令并添加 max_fails、fail_timeout 参数,然后在 location 中使用 proxy_pass 指向该 upstream 名称。
如何配置 upstream 以启用被动健康检查
在 Nginx 中,被动健康检查是通过 upstream 块中的 server 指令参数控制的。当 Nginx 作为反向代理时,如果请求失败次数超过阈值,Nginx 会将该节点标记为不可用一段时间。
http {
    upstream backend_pool {
        server 192.168.1.10:8080 max_fails=3 fail_timeout=30s;
        server 192.168.1.11:8080 max_fails=3 fail_timeout=30s;
        server 192.168.1.12:8080 max_fails=3 fail_timeout=30s;
    }

    server {
        listen 80;
        location /api/ {
            proxy_pass http://backend_pool;
            proxy_next_upstream error timeout invalid_header http_500 http_502 http_503;
        }
    }
}
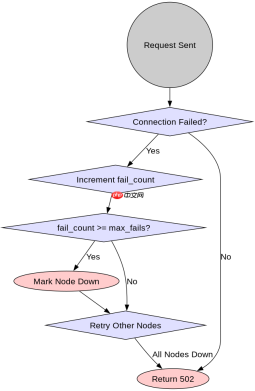
上述配置中,max_fails=3 表示在 fail_timeout=30s 的时间窗口内,如果与后端的连接失败达到 3 次,Nginx 会在接下来的 30 秒内将该节点视为不可用。这属于被动检查,即只有当客户端请求到达时才触发检测。此外,proxy_next_upstream 指令定义了哪些错误类型会触发重试其他节点,包括连接错误、超时以及 HTTP 5xx 状态码。
如何实现主动健康检查
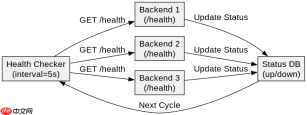
被动检查存在延迟,因为只有在流量经过时才会发现节点故障。为了实现更及时的故障转移,可以使用第三方模块如 nginx-upstream-healthcheck 或 Nginx Plus 内置的健康检查功能。这里以开源模块为例,展示如何在 upstream 中集成主动检查逻辑。

# 假设已编译安装 nginx-upstream-healthcheck 模块
http {
    upstream backend_pool {
        server 192.168.1.10:8080;
        server 192.168.1.11:8080;
        server 192.168.1.12:8080;

        # 主动健康检查配置
        health_check interval=5 fails=3 passes=2 uri=/health;
    }

    server {
        listen 80;
        location /api/ {
            proxy_pass http://backend_pool;
        }
    }
}
在此配置中,health_check 指令由第三方模块提供。它每隔 5 秒向每个后端节点的 /health 路径发送一次 HTTP 请求。如果连续 3 次检查失败,节点被标记为 down;如果连续 2 次成功,则恢复为 up。这种方式能更快地剔除故障节点,减少用户请求被发送到不可用后端的风险。
当所有后端节点都标记为不可用时 location 如何处理请求
当所有配置的 upstream 节点都被标记为不可用时,Nginx 默认会返回 502 Bad Gateway 错误。这是因为 proxy_pass 无法将请求转发到任何可用的后端服务器。可以通过配置 error_page 来定制这一行为,例如返回一个自定义的错误页面或尝试备用服务。
server {
    listen 80;
    location /api/ {
        proxy_pass http://backend_pool;
        error_page 502 = @fallback;
    }

    location @fallback {
        return 503 "Service temporarily unavailable";
    }
}
在上述配置中,当 backend_pool 中所有节点均不可用时,Nginx 会触发 502 错误,并通过 error_page 502 = @fallback; 将请求重定向到名为 @fallback 的内部位置块。该内部位置块直接返回 503 状态码和一条简短消息,避免暴露底层架构细节。这种处理方式提升了用户体验,同时保持了系统的稳定性。


