






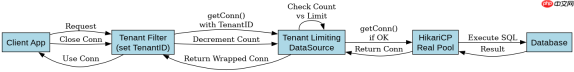
java 数据库连接池配置租户限流的核心做法是在获取连接的环节拦截请求,通过统计当前租户的活跃连接数或并发任务数,在超过阈值时拒绝新请求或排队等待。具体实现通常依赖于自定义 datasource 包装器或连接池(如 hikaricp)的 connectioncustomizer 结合线程局部变量(threadlocal)来隔离租户上下文,并在 getconnection() 调用前后进行计数校验。
如何基于 ThreadLocal 识别当前请求的租户
要实现租户限流,第一步是确保每个数据库操作都能明确知道属于哪个租户。这通常通过在 Web 过滤器中解析租户标识(如 Header 中的 Tenant-ID),并将其存入 ThreadLocal 来实现。这样,后续的业务逻辑和连接池层面无需传递参数即可获取当前租户信息。
public class TenantContext {
    private static final ThreadLocal<string> TENANT_HOLDER = new ThreadLocal();

    public static void setTenant(String tenantId) {
        TENANT_HOLDER.set(tenantId);
    }

    public static String getTenant() {
        return TENANT_HOLDER.get();
    }

    public static void clear() {
        TENANT_HOLDER.remove();
    }
}</string>
上述代码定义了一个简单的 TenantContext 工具类。在实际应用中,需要在 Servlet Filter 或 Spring Interceptor 中调用 setTenant,并在 finally 块中调用 clear 以防止内存泄漏。这是限流判断的基础,因为限流计数器必须按租户维度独立维护。
如何封装 DataSource 实现租户级连接数限制
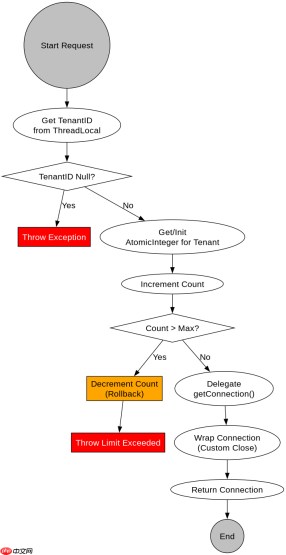
第二步是创建一个代理 DataSource,它包裹真实的连接池(如 HikariCP),并在每次调用 getConnection 时检查该租户的连接数是否超限。如果未超限,则从底层池获取连接并记录;如果超限,则抛出异常或阻塞。

你是 TypeScript 项目架构专家,专注于脚手架搭建生产就绪的 Node.js 和前端应用。生成包含现代工具链(pnpm、Vite、Next.js)、类型
import com.zaxxer.hikari.HikariDataSource;
import java.sql.Connection;
import java.sql.SQLException;
import java.util.Map;
import java.util.concurrent.ConcurrentHashMap;
import java.util.concurrent.atomic.AtomicInteger;

public class TenantLimitingDataSource implements javax.sql.DataSource {
    private final HikariDataSource delegate;
    private final int maxConnectionsPerTenant;
    // 使用 ConcurrentHashMap 存储每个租户的当前活跃连接数
    private final Map<string atomicinteger> tenantConnectionCounts = new ConcurrentHashMap();

    public TenantLimitingDataSource(HikariDataSource delegate, int maxConnectionsPerTenant) {
        this.delegate = delegate;
        this.maxConnectionsPerTenant = maxConnectionsPerTenant;
    }

    @Override
    public Connection getConnection() throws SQLException {
        String tenantId = TenantContext.getTenant();
        if (tenantId == null) {
            throw new SQLException("Tenant ID not found in context");
        }

        AtomicInteger count = tenantConnectionCounts.computeIfAbsent(tenantId, k -> new AtomicInteger(0));

        // 尝试增加计数,如果超过阈值则拒绝
        if (count.incrementAndGet() > maxConnectionsPerTenant) {
            count.decrementAndGet(); // 回滚增加
            throw new SQLException("Tenant " + tenantId + " connection limit exceeded");
        }

        try {
            Connection conn = delegate.getConnection();
            // 可选:在此处注册回调以在连接关闭时减少计数
            return wrapConnection(conn, tenantId, count);
        } catch (SQLException e) {
            count.decrementAndGet(); // 获取失败则回滚
            throw e;
        }
    }

    private Connection wrapConnection(Connection conn, String tenantId, AtomicInteger count) {
        return new DelegatingConnection(conn) {
            @Override
            public void close() throws SQLException {
                super.close();
                count.decrementAndGet();
            }
        };
    }
    // 其他 DataSource 方法委托给 delegate...
}</string>
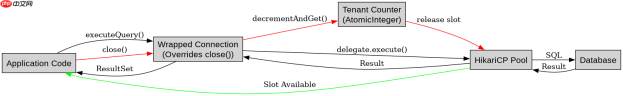
这段代码展示了一个基本的 TenantLimitingDataSource。它使用 AtomicInteger 保证计数的线程安全。关键点在于 wrapConnection 方法,它重写了 close() 方法,确保当应用层调用 conn.close() 时,对应的租户连接计数会正确递减。如果不重写 close,连接归还到池后计数不会减少,导致假死锁或资源耗尽。
连接释放时计数为何可能不准确及如何修复
在使用上述封装方案时,一个常见的问题是:如果业务代码捕获了 SQLException 但没有调用 close(),或者连接因超时被池回收,计数可能无法及时释放。虽然 HikariCP 本身有超时机制,但我们的自定义计数逻辑依赖 close() 调用。为了确保准确性,应结合 HikariCP 的 ConnectionCustomizer 或在更高层面监控池状态,但在纯 Java 层面,最可靠的方式是确保所有路径都调用 close,或使用 try-with-resources 语句。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


