






Java HashMap 怎么统计词频
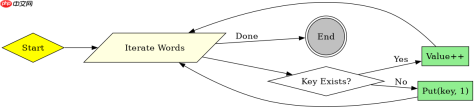
使用 hashmap 结合 merge() 或 computeifabsent() 方法可以高效地统计词频。核心做法是遍历输入数据,对每个元素调用 map.merge(key, 1, integer::sum),该方法会自动处理键不存在时初始化为 1 以及键存在时累加的逻辑,从而避免手动判断 containskey 的冗余代码。
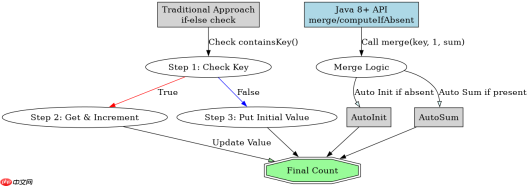
传统方式与 Java 8+ 新 API 的区别
传统方式需要显式检查键是否存在并分别执行赋值或自增操作,而 merge() 和 computeIfAbsent() 将状态检查与值更新合并为原子逻辑,代码更简洁且不易出错。前者适合需要精细控制初始化过程的场景,后者适合标准的计数累加场景。
import java.util.HashMap;
import java.util.Map;

public class WordCount {
    public static void main(String[] args) {
        String[] words = {"apple", "banana", "apple", "orange", "banana", "apple"};
        Map<string integer> frequencyMap = new HashMap;

        // 使用 merge 方法统计词频
        for (String word : words) {
            frequencyMap.merge(word, 1, Integer::sum);
        }

        System.out.println(frequencyMap);
    }
}</string>
预期输出:
{orange=1, banana=2, apple=3}

javascript-typescript-typescript-scaffold
下载
你是 TypeScript 项目架构专家,专注于脚手架搭建生产就绪的 Node.js 和前端应用。生成包含现代工具链(pnpm、Vite、Next.js)、类型
如何处理大小写敏感及空值情况
在统计词频时,默认情况下 HashMap 区分大小写,即 "Apple" 和 "apple" 被视为不同的键。若需忽略大小写,应在存入前统一转换为小写。此外,若输入数据包含 null,HashMap 允许一个 null 键,但通常建议在预处理阶段过滤掉 null 值以避免潜在的 NullPointerException 或逻辑混淆。

import java.util.HashMap;
import java.util.Map;

public class RobustWordCount {
    public static void main(String[] args) {
        String[] words = {"Apple", "apple", null, "Banana", "banana"};
        Map<string integer> frequencyMap = new HashMap;

        for (String word : words) {
            if (word == null) continue; // 过滤空值
            String lowerWord = word.toLowerCase(); // 统一转为小写
            frequencyMap.merge(lowerWord, 1, Integer::sum);
        }

        System.out.println(frequencyMap);
    }
}</string>
预期输出:
{apple=2, banana=2}
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


