






在spring data marklogic中处理空文档,核心做法是利用`optional
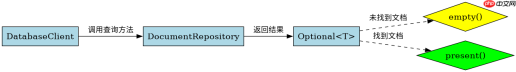
findByCode查询未命中时返回什么
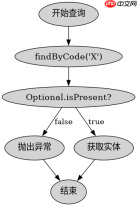
当使用基于接口的Repository定义查询方法如findByCode(String code)且数据库中不存在对应文档时,Spring Data MarkLogic会返回一个空的Optional对象。这意味着返回值不是null,而是Optional.empty()。开发者可以直接链式调用isPresent()或orElse(null)来判断是否存在数据,从而避免传统的null指针检查逻辑。
import com.marklogic.client.DatabaseClient;
import com.marklogic.client.io.JacksonHandle;
import org.springframework.data.domain.Page;
import org.springframework.data.domain.Pageable;
import org.springframework.data.repository.ListCrudRepository;
import java.util.Optional;

public interface DocumentRepository extends ListCrudRepository<mydoc string> {
    Optional<mydoc> findByCode(String code);
}</mydoc></mydoc>
上述代码定义了标准的Spring Data接口。在实际调用中,如果传入的code在MarkLogic中没有匹配项,findByCode将返回Optional.empty()。若需获取具体值,应使用optionalDoc.orElseThrow(() -> new RuntimeException("Not Found")),这样可以在未找到时明确抛出业务异常,而不是静默失败。
批量查询findAll如何过滤空结果
对于集合类型的查询如findAll()或findAllById(Iterable,即使某些ID对应的文档不存在,Spring Data MarkLogic也不会返回包含null元素的列表,而是直接忽略不存在的ID。返回的List仅包含实际找到的文档实体。这种设计简化了后处理逻辑,无需遍历列表进行null判断。

你是 TypeScript 项目架构专家,专注于脚手架搭建生产就绪的 Node.js 和前端应用。生成包含现代工具链(pnpm、Vite、Next.js)、类型

import org.springframework.stereotype.Service;
import java.util.List;
import java.util.Optional;
import java.util.stream.Collectors;

@Service
public class DocumentService {
    private final DocumentRepository repo;

    public DocumentService(DocumentRepository repo) { this.repo = repo; }

    public List<mydoc> getExistingDocs(List<string> codes) {
        return codes.stream()
            .flatMap(code -> repo.findByCode(code).stream())
            .collect(Collectors.toList());
    }
}</string></mydoc>
在Service层实现中,利用Java 8 Stream API结合Optional是处理批量查询的最佳实践。flatMap操作会自动丢弃空的Optional,只提取存在的文档。例如,输入["A", "B"],若只有A存在,输出列表仅包含A对应的对象。这种方式既简洁又高效,避免了手动循环和条件判断。
自定义转换器如何处理JSON解析失败
当MarkLogic中的文档内容格式不符合预期(如损坏的JSON)时,Spring Data MarkLogic在反序列化阶段可能抛出异常。虽然Optional本身不捕获解析错误,但可以通过配置自定义的Converter或MappingJackson2XmlHttpMessageConverter来处理此类情况。建议在DatabaseClientFactory初始化时注册容错处理器,将解析失败的文档映射为特定的错误状态对象而非直接崩溃。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


