






实现自定义 outputstream 需要继承 java.io.outputstream 抽象类,并至少重写其唯一的抽象方法 write(int b)。具体做法是创建子类,在 write 方法中定义字节写入的逻辑(如保存到文件、网络或内存),如果涉及缓冲优化,可以额外重写 write(byte[] b, int off, int len) 和 close() 方法。这样就能获得一个可复用的流对象,用于处理特定的数据输出需求。

如何编写最基础的 OutputStream 子类
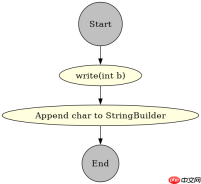
最基础的做法是直接继承 OutputStream 并重写 write(int b) 方法。这是所有自定义流的起点,因为父类提供的其他方法(如 write(byte[]))默认都是基于这个单字节方法实现的。只要实现了这个方法,就满足了接口的最低要求。
import java.io.IOException;
import java.io.OutputStream;

public class SimpleCustomStream extends OutputStream {
    private StringBuilder buffer = new StringBuilder();

    @Override
    public void write(int b) throws IOException {
        // 将单个字节转换为字符并存储
        buffer.append((char) b);
    }

    public String getContent() {
        return buffer.toString();
    }
}
运行上述代码时,调用 write(65) 会将 'A' 存入内部缓冲区。通过 getContent() 可以验证数据是否正确累积。这种实现方式简单直接,适合理解核心机制,但在处理大量数据时性能较差,因为每次写入都涉及方法调用和可能的同步开销。
如何优化高性能的 OutputStream 实现
为了提升性能,应当重写 write(byte[] b, int off, int len) 方法,以支持批量写入。同时,建议实现缓冲机制,减少底层 I/O 操作的频率。此外,必须正确实现 close() 方法以释放资源,并确保在关闭后再次写入时抛出 IOException,符合 Java IO 规范。

你是 TypeScript 项目架构专家,专注于脚手架搭建生产就绪的 Node.js 和前端应用。生成包含现代工具链(pnpm、Vite、Next.js)、类型
import java.io.IOException;
import java.io.OutputStream;
import java.util.Arrays;

public class BufferedCustomStream extends OutputStream {
    private byte[] buffer;
    private int count = 0;
    private boolean closed = false;

    public BufferedCustomStream(int bufferSize) {
        this.buffer = new byte[bufferSize];
    }

    @Override
    public void write(int b) throws IOException {
        if (closed) throw new IOException("Stream closed");
        if (count == buffer.length) {
            flushBuffer();
        }
        buffer[count++] = (byte) b;
    }

    @Override
    public void write(byte[] b, int off, int len) throws IOException {
        if (closed) throw new IOException("Stream closed");
        // 如果请求长度超过缓冲区,直接刷新现有内容并处理大块数据
        if (len >= buffer.length) {
            flushBuffer();
            System.arraycopy(b, off, buffer, 0, len); // 简化处理:实际应动态扩容或分块
            count = len;
            flushBuffer();
            return;
        }
        while (len > 0) {
            int space = buffer.length - count;
            int toWrite = Math.min(len, space);
            System.arraycopy(b, off, buffer, count, toWrite);
            count += toWrite;
            off += toWrite;
            len -= toWrite;
            if (count == buffer.length) {
                flushBuffer();
            }
        }
    }

    private void flushBuffer() throws IOException {
        if (count > 0) {
            // 模拟写入到底层目标,例如打印到控制台
            System.out.write(buffer, 0, count);
            count = 0;
        }
    }

    @Override
    public void close() throws IOException {
        if (!closed) {
            flushBuffer();
            closed = true;
        }
    }
}
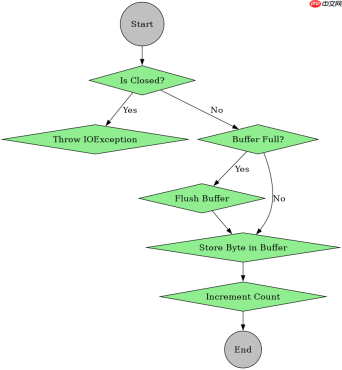
该实现展示了如何通过缓冲数组 buffer 来累积数据,并在满时调用 flushBuffer() 进行实际输出。重写的 write(byte[], int, int) 方法能够高效地处理大块数据,避免频繁的单字节操作。测试时,传入一个大数组,观察 System.out 的输出,可以验证缓冲和刷新逻辑的正确性。这种模式是构建高效自定义流的标准实践。
当缓冲区满时 flushBuffer 的具体行为是什么
在上面的 BufferedCustomStream 实现中,当 count 等于 buffer.length 时,flushBuffer() 会被触发。它的行为是将当前缓冲区中的有效字节(从索引 0 到 count-1)传递给底层的输出目标(在此例中是 System.out),然后将 count 重置为 0,准备接收下一批数据。这个过程确保了数据不会丢失,并且保持了缓冲区的可用性。如果在 close() 时缓冲区还有剩余数据,flushBuffer() 也会被调用以确保所有数据都被写出。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


